
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковая модель стала точнее прогнозировать реальные события, потому что научилась сама выбирать данные для ответа. В препринте команды Yusuf Afifi, который не рецензировался и в котором все числа получили сами авторы, обученная Qwen3.5-35B-A3B чуть обошла Claude Opus 4.5 при примерно 5% стоимости одного ответа. Для прогнозирующих систем это переносит поиск из внешней обвязки в навык, который можно улучшать вместе с самой моделью.
Поиск включили в цикл обучения
Обычный прогнозирующий агент получает вопрос, заранее собранную справку и выдаёт вероятность исхода. Качество такого агента ограничивает справка: обучение не поможет найти факт, которого в ней изначально не было.
В новой схеме модель сама собирает контекст. Каждый пример содержит уже разрешившийся бинарный вопрос с Polymarket, правила определения исхода и дату, на которую нужно сделать прогноз. Агент ищет страницы, читает их, запрашивает финансовые и экономические временные ряды, обновляет оценку вероятности и завершает работу обоснованным ответом.
Вознаграждение зависит только от итоговой вероятности и реального исхода. Для него используют оценку Брайера: она измеряет квадрат отклонения прогноза от результата, поэтому уверенная ошибка обходится дороже осторожной. Эта метрика поощряет калибровку — соответствие заявленной вероятности тому, как часто событие действительно происходит.
Так поиск становится частью оптимизируемого поведения. Алгоритм GRPO сравнивает несколько траекторий для одного вопроса и усиливает те действия, которые привели к лучшему прогнозу. Модель учится не только формулировать запросы, но и решать, стоит ли продолжать поиск, какой странице доверять и насколько новое свидетельство должно изменить вероятность.
Обучающая выборка включает около 2100 вопросов. Для каждого исторического вопроса система закрывает доступ к будущему: блокирует сайты рынков предсказаний, отбрасывает материалы после даты прогноза и передаёт оставшиеся результаты Claude Haiku, который проверяет их на косвенное раскрытие исхода. Без такого фильтра модель могла бы найти ответ вместо того, чтобы прогнозировать его.
Модель реже ищет и точнее оценивает уверенность
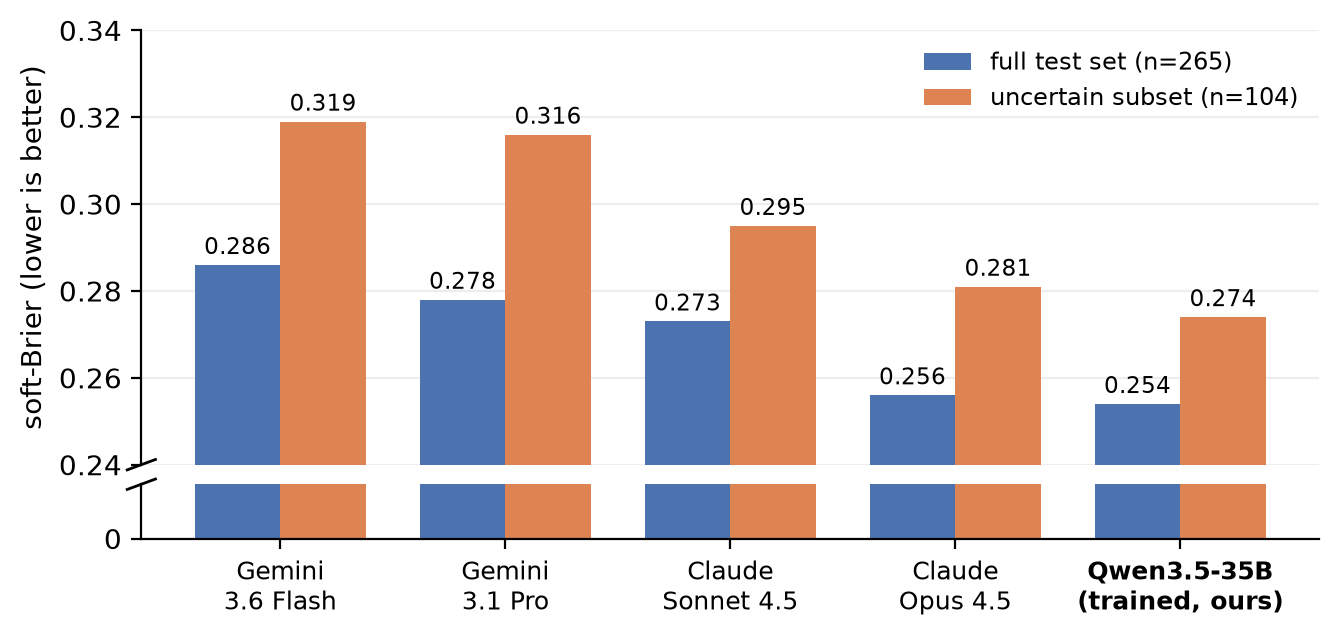
На отложенной выборке обученная модель получила сглаженную оценку Брайера 0,254 против 0,256 у Claude Opus 4.5; меньшее значение означает более точный прогноз. Разрыв невелик, но Qwen также опередила Claude Sonnet и обе протестированные Gemini в одном стенде, с одинаковыми инструментами и ограничениями.
Главное изменение видно не только в итоговом месте. Ошибка калибровки снизилась на 31%: после обучения модель реже приписывала событиям уверенность, которая не подтверждалась фактической частотой исходов. Это важно для продуктов, где вероятность влияет на бюджет, запас ресурсов или порог автоматического действия.
Среднее число поисковых попыток сократилось с 3,8 до 2,25 на один прогон. По журналам работы агент реже повторял запрос после пустого или отфильтрованного результата и чаще строил вывод из уже найденных свидетельств. Вознаграждение за конечный прогноз без отдельного штрафа за поиск всё равно научило модель экономнее обращаться к инструментам.
Преимущество оказалось заметнее на вопросах, где рынок сам ещё не пришёл к уверенному ответу. На простых событиях разные модели находили сходные факты и сближались, а на неоднозначных больше зависели от выбора источников и способа обновлять вероятность.
Командам стоит менять контур обучения, а не сразу базовую модель
Работа предлагает практическое изменение для систем прогнозирования: не фиксировать результаты поиска перед обучением, а выполнять поиск внутри каждого прогона. Тогда вознаграждение улучшает всю цепочку — от запроса до конечной вероятности, — а не только ответ на готовой справке.
Это подходит задачам, где исход можно однозначно проверить позже и где для каждого примера известна граница доступной информации. Например, так можно строить внутренние прогнозы сроков, спроса или наступления операционных событий, если команда умеет сохранять состояние источников на момент прогноза. Без временной отсечки обучение легко вознаградит утечку будущих фактов.
Меняется и экономика эксперимента. Результат показывает, что меньшая открытая модель может компенсировать разрыв с более крупной моделью, если обучается вместе с инструментами и получает проверяемое вознаграждение. Поэтому перед переходом на более дорогой API имеет смысл проверить, не ограничивают ли качество фиксированный контекст, лишние поисковые вызовы и неверно выставленная уверенность.
Проверка охватывает одну Qwen, бинарные вопросы Polymarket и отложенный набор из 265 событий; сравнение проводили с четырьмя моделями в одинаковом исследовательском стенде без доступа к рыночной цене. Результат обосновывает пилот для сходных задач, но не доказывает такое же преимущество в свободных аналитических отчётах или прогнозах без проверяемого исхода.
Авторы открыли среду, набор данных и журналы прогонов. Для продуктовой команды ценнее всего не готовая модель, а воспроизводимая схема: датированные источники, инструменты внутри обучения, награда за калиброванную вероятность и аудит каждого шага агента.
Источники
Иллюстрация: рисунок из статьи «Do Your Own Research: Learning to Forecast by Learning to Search», Yusuf Afifi, Artur Kiulian, Anton Polishko и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


