
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Длинного исследовательского агента научились выводить из локального тупика, не стирая накопленные файлы и не увеличивая общий бюджет вычислений. Работа Microsoft Research — нерецензированный препринт, а все числа рассчитали сами авторы. На 13 задачах периодическое разветвление со сбросом истории обошло и один непрерывный запуск, и несколько независимых коротких запусков: оркестратору агента может понадобиться управлять не только бюджетом, но и наследованием контекста.
Почему дополнительное время не выводит агента к новой идее
Исследовательский агент многократно меняет программу или другой рабочий результат, запускает его и получает оценку от проверяющей среды. Проблема возникает, когда раннее решение задаёт направление всей дальнейшей работы: агент продолжает улучшать одну архитектуру или алгоритм, хотя в другой части пространства решений лежит более сильный вариант.
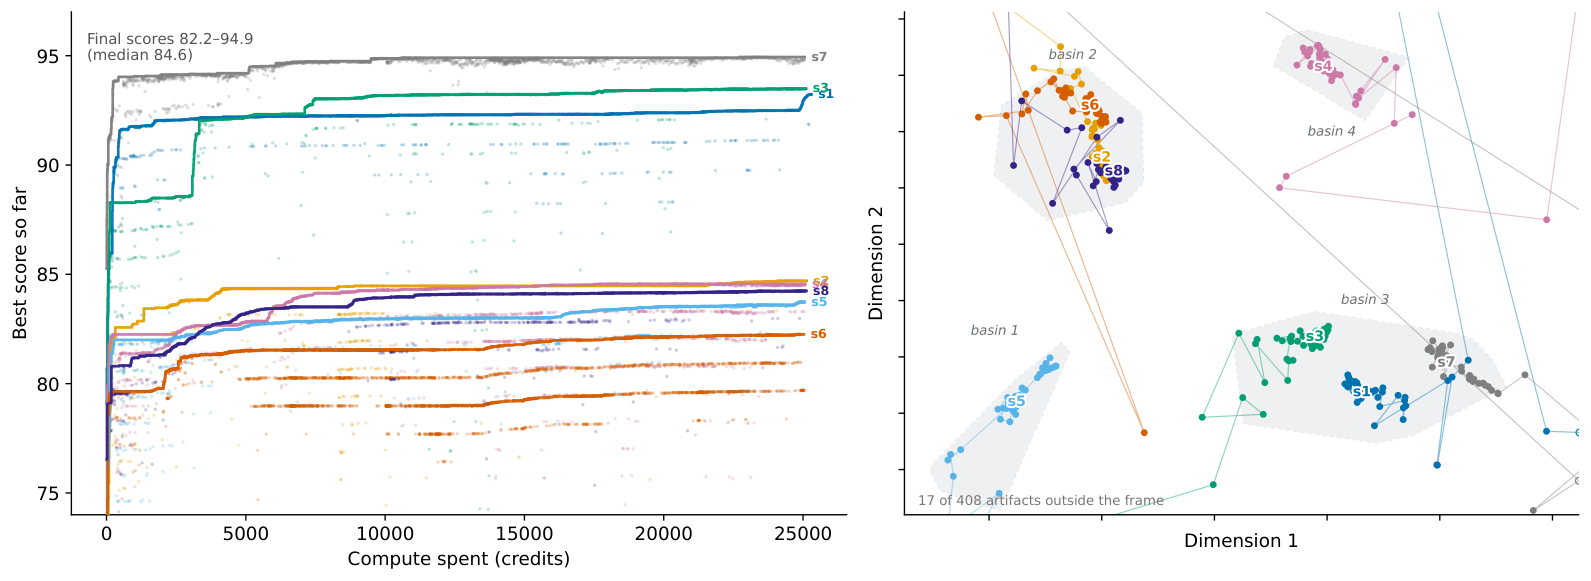
В показательном задании независимые запуски одного агента начинали с одинакового состояния, но завершались с результатами от 68,3 до 100 баллов. Разрыв сохранялся после дополнительных вычислений. Значит, слабые запуски не просто медленнее двигались к общей цели — они закреплялись на других подходах.
Чтобы проверить это, исследователи сравнивали рабочие результаты по функциональному сходству, а не по синтаксису кода. Модель-оценщик получала три описания и выбирала, какое из двух решений ближе к первому по подходу. Затем эти сравнения превращали в двумерную карту.
Карта воспроизводила 85% отложенных сравнений против 50% у случайного выбора. На ней результаты каждого запуска собирались в локальных областях: агент менял детали, но редко переходил к другой семье решений. Обычное сокращение длинной истории диалога до краткого резюме этот эффект не устраняло.
Как Fork-and-Flush сохраняет работу, но отбрасывает ход рассуждений
Fork-and-Flush разделяет состояние агента на рабочую область и контекст диалога. В рабочей области остаются исходный код, конфигурация, промежуточные результаты и другие файлы. Контекст содержит объяснения, гипотезы и решения, которыми модель пришла к текущему состоянию.
В заданные моменты оркестратор копирует рабочую область в несколько параллельных ветвей, но запускает каждую с пустым контекстом. Ветви получают одинаковую часть общего бюджета, независимо развивают решение и отправляют результаты в детерминированную проверяющую среду. После этого оркестратор оставляет ветвь с лучшей оценкой, отбрасывает остальные и продолжает последовательную работу.
Сброс нужен не для экономии токенов. Он разрывает зависимость от прежнего объяснения: модель видит готовые файлы, но должна заново понять их назначение и решить, куда двигаться дальше. Разветвление, в свою очередь, снижает риск, что единственный новый ход снова приведёт к прежнему подходу.
При равном общем бюджете нормированный средний результат оказался на 66% выше, чем у одного длинного запуска, и на 44% выше, чем у стратегии «лучший из четырёх», где независимые агенты делят бюджет и начинают с нуля. Fork-and-Flush дал лучший средний результат в 12 из 13 задач. Нормирование здесь приводит разные метрики задач к общей шкале между худшим и лучшим результатом, полученным в эксперименте.
Главное различие с независимыми запусками состоит в повторном использовании удачной работы. Стратегия «лучший из четырёх» расширяет поиск, но каждой ветви достаётся короткий горизонт, а файлы проигравших запусков исчезают. Fork-and-Flush чередует широкий поиск с длительной доработкой выбранного варианта.
Когда стоит менять оркестратор агента
Приём касается систем, где агент часами или днями улучшает проверяемый результат: оптимизирует программу, подбирает архитектуру модели, решает инженерную задачу или восстанавливает параметры по наблюдениям. Для внедрения нужен числовой показатель, по которому можно честно выбрать ветвь, и рабочая область, которую можно копировать отдельно от истории диалога.
Работу проверяли на задачах по алгоритмической оптимизации, криптоанализу, научным расчётам и системной инженерии. В разных заданиях использовали GPT-5.6-terra или GPT-5.5 через одинаковый агент GitHub Copilot CLI; отдельные запуски занимали от нескольких часов до нескольких дней. Сравнивали непрерывный запуск, несколько независимых запусков и Fork-and-Flush при одинаковых вычислительных бюджетах.
Это не аргумент срочно менять модель. Работа показывает другой рычаг: если длинный запуск перестал улучшаться, добавление того же бюджета в ту же историю может закрепить тупик. Команде стоит хранить файлы и контекст как разные части состояния, периодически запускать несколько продолжений без прежней переписки и выбирать победителя внешней проверкой.
В производственной системе придётся учитывать стоимость параллельного исполнения и возможность безопасно клонировать среду. Метод не требует большего суммарного бюджета, но временно создаёт несколько одновременных задач. Поэтому он проще всего встраивается туда, где вычисления уже выполняются в изолированных контейнерах, а проверка результата автоматизирована.
Источники
Иллюстрация: рисунок из статьи «Fork-and-Flush: Escaping Idea Basins in Autoresearch Agents», Ziyang Cai, Christos Ziakas, Vasilis Kontonis и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


