
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Четырёхбитное предобучение большой языковой модели удалось ускорить так, чтобы служебная работа вокруг матричных умножений не съела выигрыш. В работе Robert Hu самая быстрая собственная реализация достигла 37,9 тысячи токенов в секунду на GPU против 18,8 тысячи у bfloat16; препринт не рецензирован, а числа в нём получил сам автор. Для команды это переносит выбор с формата чисел на весь путь данных между операциями.
Ускорение теряется между матричными умножениями
Тензорные ядра быстро перемножают матрицы в FP4, но слой сначала должен вычислить масштабы, упаковать значения и разложить их в памяти. Для обратного прохода также нужно сохранить промежуточные данные. Если отдельные вычислительные ядра пересылают их через память GPU, выигрыш от быстрого умножения исчезает.
Работа объединяет эти действия в один производитель данных. Он вычисляет масштаб, квантует значения и сразу выдаёт физические раскладки, которые нужны следующему умножению. Граница такого объединения зависит от того, какая группа значений делит общий масштаб.
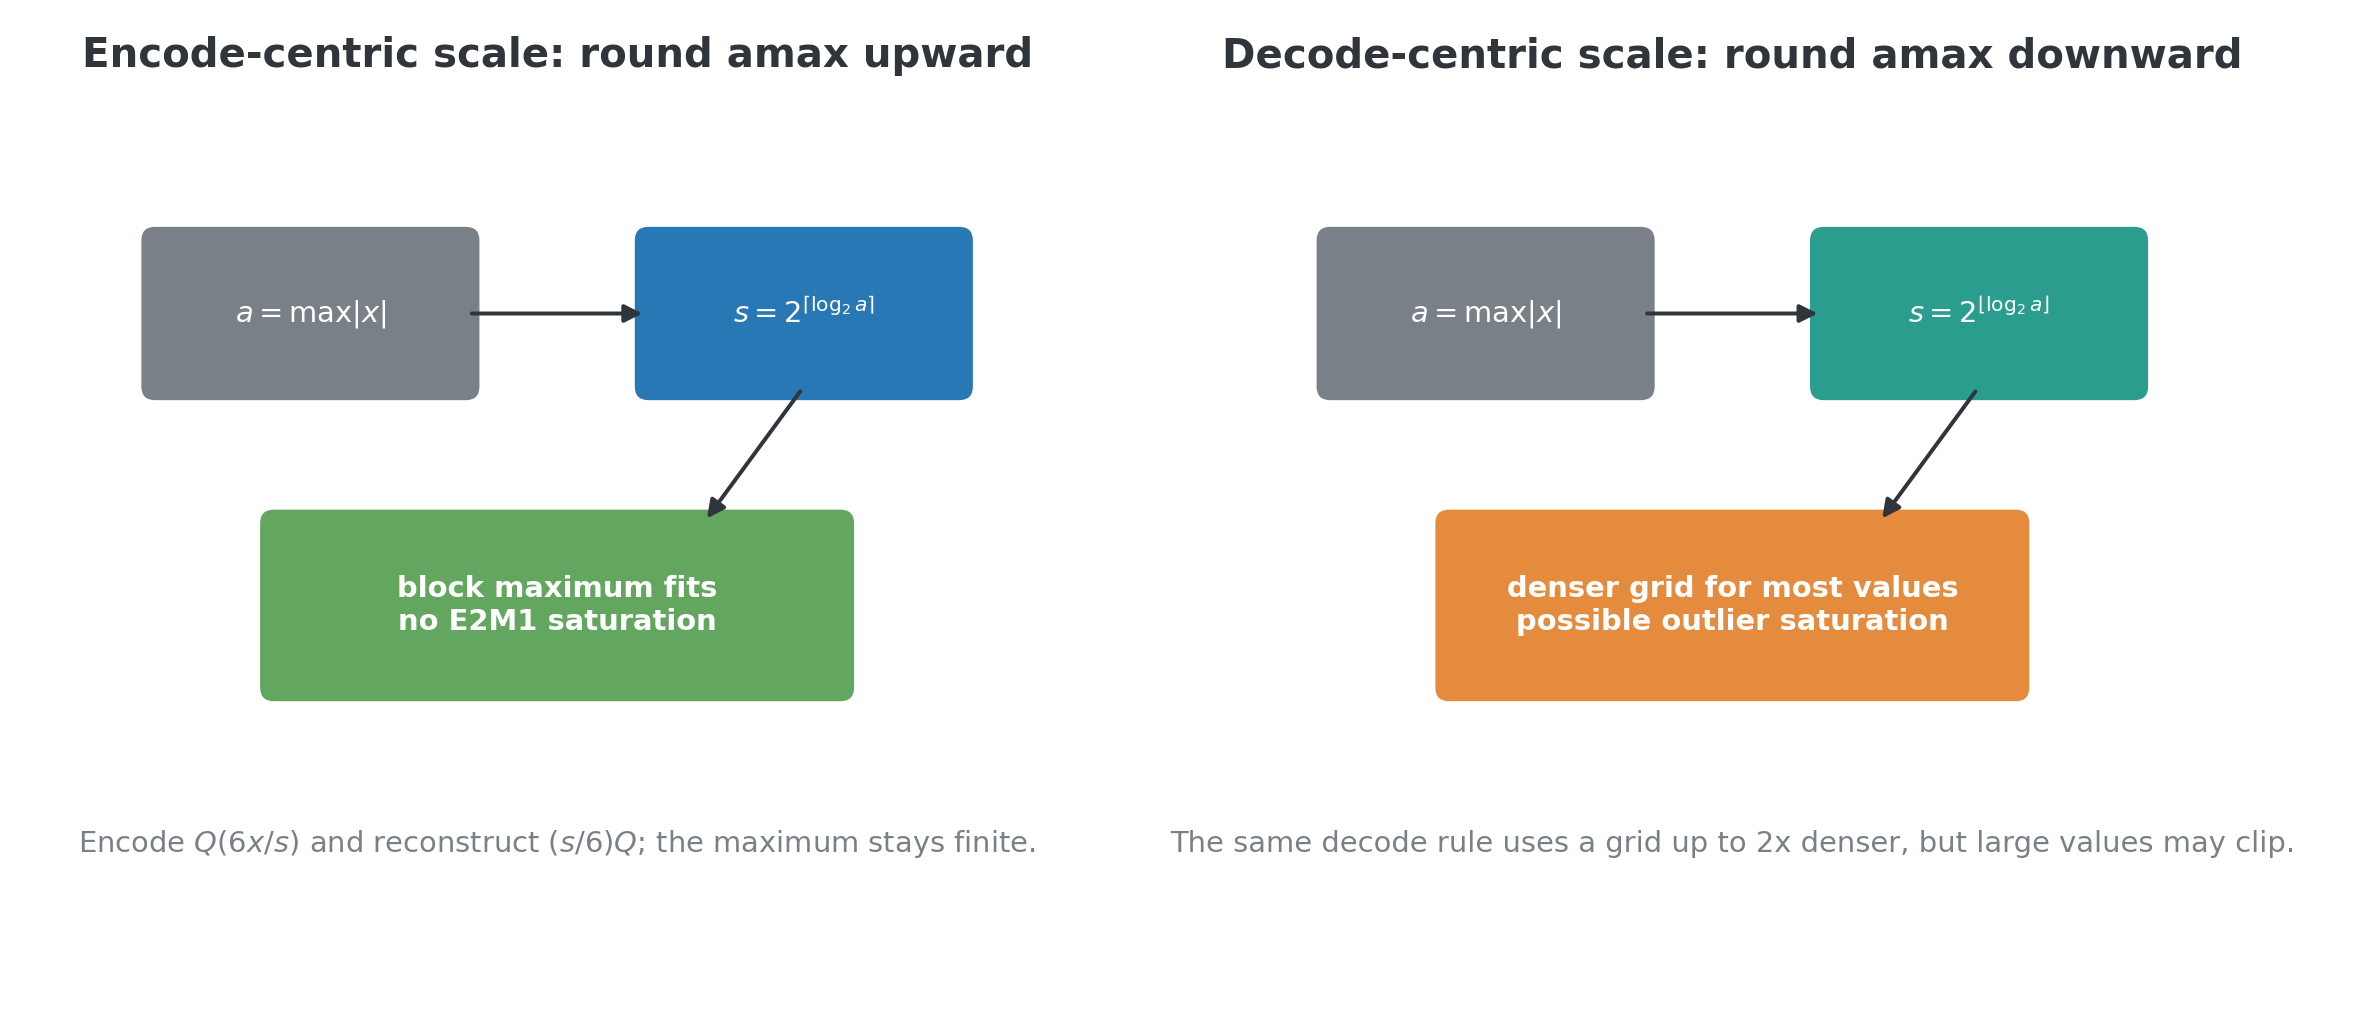
В MXFP4 один масштаб относится к блоку из 32 значений. Его можно вычислить локально, но доступная сетка значений остаётся грубой: масштаб хранится как степень двойки. Для активаций и градиентов реализация выбирает масштаб, который не обрезает наибольшее значение, а для весов иногда использует более мелкий шаг ценой ограниченного обрезания.
Глобальный NVFP4 применяет более точный масштаб к 16 значениям, но дополнительно зависит от максимума по всему тензору. Пока GPU не соберёт частичные максимумы, упаковка и следующее умножение ждать не могут.
Вариант CTA-local NVFP4 переносит эту зависимость внутрь кооперативного блока потоков (CTA). Строка и столбец получают отдельные поправки, которые остаются неизменными во время суммирования и применяются после него. Независимые блоки GPU больше не ждут общий максимум по тензору, хотя численный контракт при этом меняется.
Прямой и обратный проходы также требуют разных представлений одних данных. Градиент выхода читается в одной раскладке при вычислении градиента входа и в другой — при вычислении градиента весов. Объединённый производитель создаёт обе версии за один проход, а для весов один раз выполняет квантизацию и выдаёт две упакованные раскладки.
Быстрый маршрут уступает по функции потерь
Наиболее сбалансированный собственный маршрут использовал MXFP4, вероятностное округление градиента входа и фиксированное преобразование Адамара H32 для градиента весов. Он обработал 37,2 тысячи токенов в секунду на GPU, а конечная функция потерь оказалась на 2,11% выше, чем у bfloat16. Функция потерь здесь показывает, насколько хорошо модель предсказывает обучающие данные: меньше — лучше.
Ближе всего к bfloat16 прошёл маршрут Transformer Engine NVFP4, в котором последние блоки оставили в bfloat16. Его превышение составило 0,87%, но скорость снизилась до 27,1 тысячи токенов в секунду на GPU. Значит, выигрыш приходится выбирать между скоростью всей системы и точностью конкретного численного рецепта.
Порядок маршрутов менялся при другой проверке. MXFP4 с H32 показал лучшую среди рассмотренных вариантов функцию потерь на внешнем потоке данных, хотя не был лучшим по конечной обучающей функции. На прикладных тестах лидеры также различались: bfloat16 выиграл MMLU, другой маршрут — WinoGrande, а MXFP4 с H32 — HellaSwag и ARC-Challenge.
Проверка охватывает предобучение модели семейства Llama-3 размером 8B до 160 миллиардов токенов. Маршруты запускали на одном типе ускорителя, с выходными проекциями в bfloat16 и скомпилированной перекрёстной энтропией. Для полных траекторий использовали по одному запуску, поэтому сравнение показывает поведение целых рецептов, а не изолированный эффект каждого приёма.
Планировать нужно маршрут, а не замену типа данных
Работа меняет план эксперимента с FP4, но не даёт универсальной настройки. Простая замена bfloat16 на четырёхбитный формат недостаточна: нужно профилировать вычисление масштаба, упаковку, перемещения через память и подготовку раскладок для прямого и обратного проходов.
Сначала стоит определить, где завершается вычисление масштаба. Глобальный максимум сохраняет численный контракт NVFP4, но создаёт точку синхронизации. Локальный масштаб позволяет раньше запустить умножение, однако его нужно проверять как отдельный рецепт обучения, а не как технически эквивалентную оптимизацию.
Затем форматы и округление нужно выбирать для каждой операции отдельно. В работе вероятностное округление применяли к градиенту входа, а преобразование Адамара — только к паре операндов при вычислении градиента весов. Один и тот же приём помог MXFP4, но ухудшил вариант CTA-local, поэтому перенос настройки между масштабами небезопасен.
Изолированная точность операции тоже не предсказывает результат обучения. CTA-local давал меньшую ошибку градиента входа в каждом проведённом сравнении на сохранённых тензорах, однако построенный на этом гибрид уступил чистому MXFP4 по скорости и качеству. В план испытаний поэтому должны входить пропускная способность, проверочная функция потерь и прикладные тесты на одном полном маршруте.
Для команды с доступом к собственным ядрам результат оправдывает совместную разработку квантизатора и раскладок под конкретный GPU. Если такой разработки в плане нет, работа скорее задаёт критерии проверки готовой реализации: ускорение матричного умножения само по себе ещё не означает ускорения предобучения.
Источники
Иллюстрация: рисунок из статьи «Format-Aware Fusion for Fast FP4 Pretraining», Robert Hu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


