
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
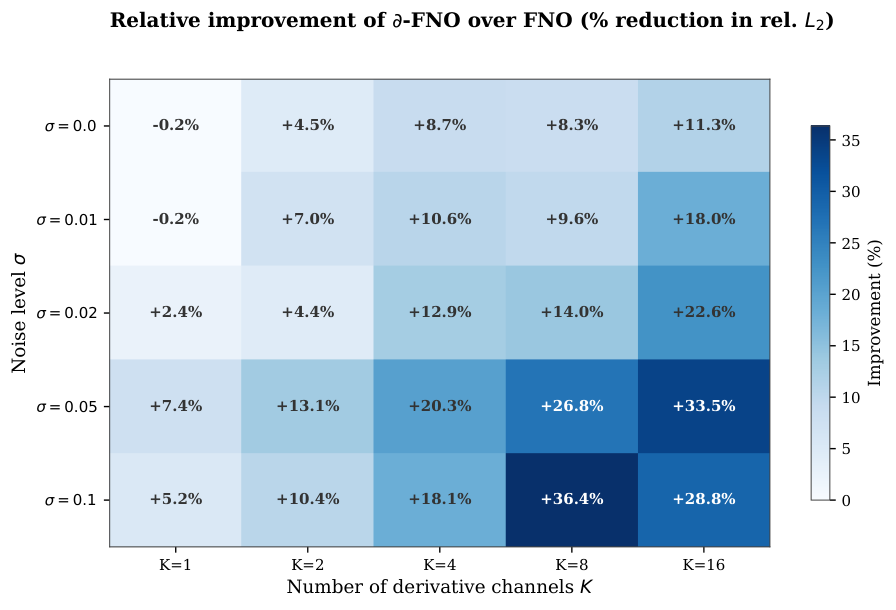
Нейронные операторы можно обучать точнее, если подавать им производные входного поля и выбирать их порядок по данным, а не напрямую из уравнения. Хотя работа NYU не рецензирована и все числа в ней получили сами авторы, ∂-NO улучшил базовые модели во всех 120 шумовых испытаниях, а максимальное снижение ошибки достигло 48,5%. Для продукта на основе таких моделей это означает, что сначала стоит проверить новую входную обработку, а не менять основную архитектуру.
Производные снимают с модели часть вычислительной работы
Нейронный оператор учит отображение между функциями: например, получает начальное состояние физической системы и предсказывает её состояние позднее. Обычно на вход поступают координаты и значения поля. Производные, которые определяют поведение уравнения, модель должна восстановить сама по конечной и, возможно, шумной выборке.
Разбор решения через последовательные приближения показывает, что производные начального поля входят в оператор решения напрямую. В уравнении Burgers первая производная отвечает за перенос, а вторая — за диффузию. Если добавить эти величины ко входу, сети уже не нужно полностью воспроизводить дифференцирование внутри себя.
Теоретический результат сформулирован как верхняя граница ошибки аппроксимации. Без дополнительных признаков она убывает как O(W^{-(s-m)/d}), а с производными до порядка уравнения — как O(W^{-s/d}). Здесь W — число параметров, s — гладкость входа, m — порядок уравнения, а d — пространственная размерность. Это не гарантирует такую скорость на каждом наборе данных, но показывает, почему одинаковой архитектуре становится проще приближать оператор.
∂-NO реализует эту идею как обёртку. Исходное поле остаётся на входе, а рядом появляются несколько каналов с его производными. Их порядки и масштабы оптимизируются вместе с весами базовой модели, поэтому FNO или другая архитектура не требует внутренней переделки.
Точный порядок уравнения сильнее усиливает шум
Порядок производной не обязан быть целым. Дробная производная непрерывно меняет частотный фильтр: нулевой порядок сохраняет исходное поле, первый соответствует обычной первой производной, а промежуточное значение занимает положение между ними. Благодаря непрерывной параметризации порядок можно учить градиентным методом.
Чем ближе порядок признака к порядку уравнения, тем меньше систематическая ошибка: модель получает больше нужной высокочастотной информации. Но дифференцирование одновременно усиливает высокочастотный шум. Поэтому точное следование физическому уравнению снижает одну часть ошибки и увеличивает другую.
Оптимальный порядок оказывается ниже физического, пока выборка конечна и содержит шум. С ростом объёма данных или снижением шума он приближается к порядку уравнения. Обучаемая производная тем самым работает как спектральная регуляризация: модель сама выбирает, насколько сильно усиливать мелкие пространственные детали.
На Burgers выигрыш ∂-FNO без шума держался в диапазоне 6–8% при разных разрешениях. При шуме он доходил до 39% на самой грубой сетке. В сравнении с Conv-FNO новый способ требовал в 34–187 раз меньше параметров предварительной обработки, при этом совпадал с ним по точности или превосходил его.
Когда добавка меняет план разработки
Работу проверяли на Burgers, Darcy, двумерном и трёхмерном Navier-Stokes. В качестве базовых архитектур использовали FNO, LocalNO, TFNO и Transolver; испытания включали чистые входы, аддитивный гауссов и равномерный шум, разные разрешения и сравнение при близком числе параметров. Поэтому результат относится прежде всего к суррогатным моделям уравнений в частных производных, а не к произвольным задачам с последовательностями или изображениями.
Для команды с уже работающим нейронным оператором ∂-NO выглядит как отдельный эксперимент над представлением входа. Имеет смысл сохранить базовую модель и схему обучения, добавить несколько каналов дробных производных и позволить оптимизатору выбрать их порядки. Фиксировать производную по известному уравнению стоит только как контрольный вариант.
Практическая цена возникает в памяти и вычислениях: каждый канал хранит ещё одно преобразованное поле. Авторы наблюдали убывающую отдачу после восьми каналов, поэтому расширять их число без проверки на валидации не следует. Для периодических областей производные вычисляют через преобразование Фурье, а для непериодических — конечными разностями.
Границы метода проходят по представлению данных. Использованная конечно-разностная схема предполагает регулярную сетку; перенос на нерегулярные сетки в работе оставлен отдельной задачей. Теоретические оценки требуют достаточно гладких входов и становятся лишь ориентиром возле разрывов и ударных волн. Кроме того, ∂-NO обрабатывает пространственные признаки, но не временные производные.
Работа не предлагает замену FNO, Transolver или другой базовой архитектуре. Она меняет более раннее решение: какие данные дать модели до первого слоя. Если ошибка растёт на шумных или грубых сетках, обучаемый порядок производной становится более дешёвой гипотезой для проверки, чем увеличение сети или полная смена подхода.
Источники
Иллюстрация: рисунок из статьи «Fractional is Better: Learnable Derivative Orders in Neural Operator Learning», Fares B. Mehouachi, Saif Eddin Jabari, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


