
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Непрерывный выход нейросети научили превращать в допустимые решения комбинаторной задачи без заранее найденных правильных ответов. На крупных задачах коммивояжёра метод обошёл DIFUSCO, но уступил COExpander и классической эвристике LKH3, хотя препринт NYU и MIT не рецензирован, а числа в нём получили сами авторы. Команда может заменить отдельные проекции и эвристическое округление общей процедурой, если для её задачи уже есть быстрый алгоритм линейной оптимизации.
Сеть предсказывает что угодно, ограничения применяет алгоритм
Во многих комбинаторных задачах ответ должен строго соблюдать ограничения: маршрут обязан посетить все города, назначение — сопоставить объекты без конфликтов, а набор элементов — уложиться в бюджет. Нейросеть при этом выдаёт непрерывный вектор, который сам по себе может не соответствовать ни одному допустимому ответу.
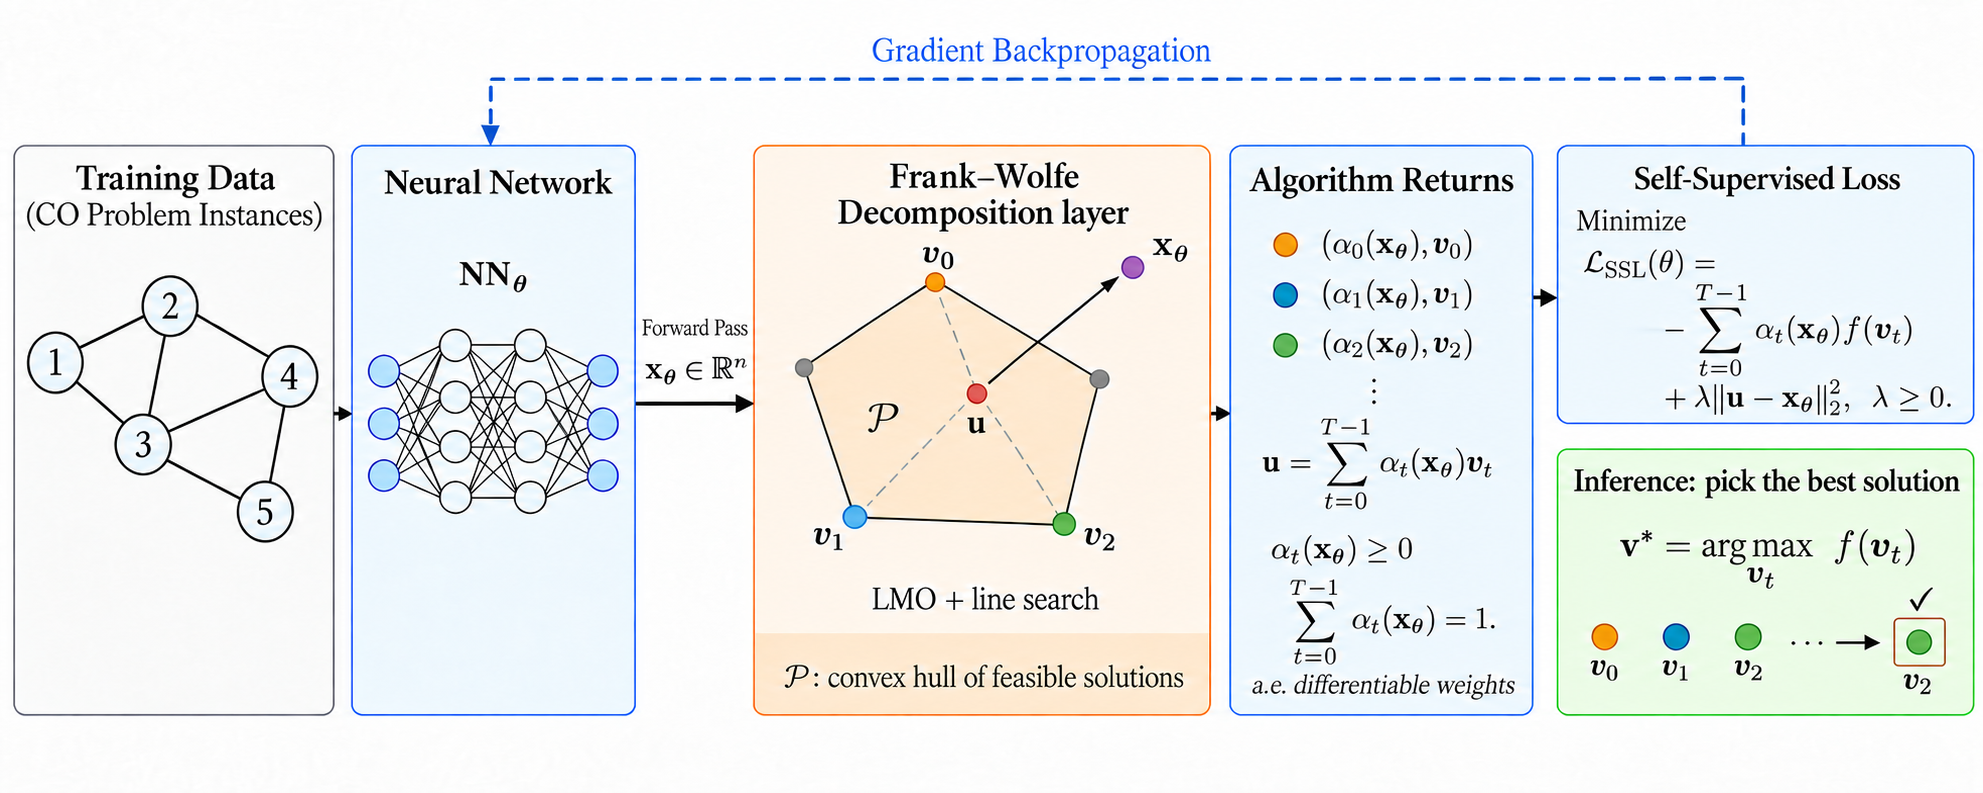
Обычная схема заставляет сеть оставаться внутри многогранника допустимых решений или отдельно проецирует её выход туда. Для разных ограничений приходится строить разные проекции. Авторы переносят эту работу в слой на основе Frank-Wolfe: сеть свободно выдаёт произвольный вектор, а слой приближает его выпуклой комбинацией допустимых дискретных решений.
Выпуклая комбинация здесь означает взвешенное среднее нескольких решений с неотрицательными весами. Каждый маршрут, назначение или набор в этой смеси уже допустим. Поэтому смесь можно читать как распределение вероятностей: вес показывает, с какой вероятностью выбирать соответствующий дискретный ответ.
Frank-Wolfe начинает с одного допустимого решения и постепенно добавляет новые. На каждом шаге оракул линейной оптимизации ищет решение, которое лучше всего сдвигает текущее приближение к выходу сети. Оракул — не отдельная модель, а алгоритм для конкретной структуры: например, в части про TSP минимальное остовное дерево строит алгоритм Краскала.
После каждого шага метод пересчитывает веса выбранных решений. Число кандидатов не превышает числа шагов, поэтому распределение остаётся разреженным даже тогда, когда полный набор допустимых ответов экспоненциально велик. Один шаг требует одного вызова оракула, и команда заранее знает вычислительную цену разложения.
Функция потерь складывается из ожидаемого значения исходной целевой функции и штрафа за расстояние между выходом сети и полученной смесью. Градиент проходит через веса смеси; выбранные дискретные решения локально остаются постоянными. Производная существует почти всюду, чего достаточно для стандартного обучения через автоматическое дифференцирование.
При применении модели слой снова строит небольшой набор допустимых кандидатов и выбирает лучший по исходной целевой функции. Для максимизации лучший кандидат не хуже среднего значения смеси, для минимизации — не дороже него. Отдельное эвристическое округление после обучения не требуется.
На больших маршрутах метод обошёл одну обучаемую базу, но не лидеров
На TSP-1000 вариант FWNCO с обучаемым подбором пар дал разрыв с оптимумом 7,43%: маршрут был на столько длиннее оптимального. У DIFUSCO разрыв составил 10,90%, у COExpander — 6,53%, а у классической эвристики LKH3 — 1,30%. Метод оказался сильнее одной обучаемой системы, но эти результаты не показывают, что он заменяет специализированные алгоритмы.
Проверка охватывает Maximum Coverage, квадратичную задачу о назначениях на QAPLIB и евклидову задачу коммивояжёра на нескольких масштабах. Для TSP точки брали из единичного квадрата, а решение строили через остовное дерево, паросочетание и сокращение повторных посещений по схеме Christofides. Архитектуры нейросетей отдельно не сравнивали: работа проверяет прежде всего функцию потерь, разложение и получение дискретного ответа.
Общий слой сокращает число специальных проекций, но не убирает предметный алгоритм
Работа меняет архитектурный план там, где команда обучает решатель на потоке похожих задач и не располагает готовыми оптимальными ответами. Вместо подготовки размеченного набора можно вычислять целевую функцию непосредственно на допустимых кандидатах и обучать сеть на ней. Тот же слой используется при обучении и при применении, поэтому между непрерывным прогнозом и финальным решением нет отдельной процедуры округления.
Однако метод не превращает произвольную задачу в универсальный модуль. Для каждого класса ограничений нужен эффективный оракул линейной оптимизации, который возвращает допустимую вершину многогранника. Именно в нём остаётся предметная часть решения; Frank-Wolfe унифицирует способ подключить её к нейросети и передать градиент.
Число шагов разложения становится прямым регулятором цены: дополнительные шаги дают больше кандидатов и могут точнее приблизить прогноз, но требуют новых запусков оракула. Для тяжёлого оракула этот слой способен определить задержку всей системы. Его бюджет стоит проектировать вместе с требованиями к времени ответа, а не выбирать только по качеству на проверочном наборе.
Отказ от проекции также не следует воспринимать как обязательное правило. На QAPLIB свободные выходы сети хуже переносились на задачи из другой выборки, поэтому перед разложением добавили облегчённый слой Sinkhorn, который приближает матрицу к допустимой структуре назначений. Теория допускает выход вне многогранника, но при сильном сдвиге данных мягкое ограничение всё равно может улучшить результат.
Практический итог — не новый универсальный решатель, а повторяемая схема интеграции нейросети с комбинаторным алгоритмом. Она подходит, когда ограничения жёсткие, целевую функцию можно вычислить без меток, а быстрый оракул уже известен. Если главная цель — один оптимальный ответ для редкой задачи, результаты TSP пока оставляют преимущество за специализированными эвристиками и точными решателями.
Источники
Иллюстрация: рисунок из статьи «Self-Supervised Combinatorial Optimization with Constraints via Frank-Wolfe», Akbar Rafiey, Yifei Xu, Nikolaos Karalias, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


