
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили сохранять удачные промежуточные решения при обучении с проверяемой наградой, не удерживая отдельную модель-учителя. В препринте IIT Kanpur, который не проходил рецензирование и где все числа получили сами авторы, FSPO обошёл лучший метод сравнения примерно на 4 процентных пункта и сократил пиковый расход памяти с 70 до 56 ГБ. Для команд, которые дообучают модели самостоятельно, это даёт способ обменять полную копию модели на небольшой архив её прошлых прогнозов.
Как прошлый прогноз становится фиксированной целью
Обучение с подкреплением по проверяемой награде (RLVR) обычно оценивает весь ответ одним числом: решена задача или нет. Такая награда не показывает, на каком токене рассуждение свернуло в неверную сторону. Особенно мало информации остаётся, когда все сгенерированные попытки получают одинаковую оценку.
Самодистилляция добавляет более подробный сигнал. Одна и та же модель сначала продолжает ответ только по исходному запросу, а затем пересчитывает вероятности следующих токенов с доступом к подсказке. Разница между двумя распределениями показывает, какие локальные решения стоило изменить.
Подсказкой служит успешный ответ из той же группы попыток. Если его нет, FSPO берёт ранее сохранённое проверенное решение, а затем — эталонный ответ из обучающего набора. Модель сравнивает два прогноза на одинаковом префиксе, поэтому различие связано именно с дополнительным свидетельством, а не с другой траекторией.
У обычной самодистилляции цель движется вместе с моделью: после обновления параметров меняются и ученик, и учитель. Один из способов стабилизировать обучение — держать усреднённую во времени копию параметров. Она занимает память почти как ещё одна модель.
FSPO вместо параметров сохраняет значения функции — разреженное распределение вероятностей следующего токена. В память попадают наиболее вероятные варианты и объединённая вероятность остального словаря. Эти записи не меняются вместе с текущей моделью и потому работают как цели из прошлого, но не требуют загружать ещё один набор весов.
Память хранит не любые успешные ответы. Метод учитывает оценку проверяющего механизма и различия в структуре решений, чтобы похожие траектории не вытеснили остальные. Старые записи обновляются с задержкой и частями: так цели не устаревают одновременно, но и не превращаются обратно в движущегося учителя.
Исправление ошибок зависит от надёжности самой модели
Простого сближения двух распределений недостаточно, если модель без подсказки уверенно предпочитает токен, который версия с дополнительным свидетельством отвергает. FSPO отдельно находит такие расхождения и снижает вероятность переоценённого варианта. Это направленное исправление дополняет общее выравнивание распределений.
Сила эталонного ответа тоже меняется во время обучения. Метод ведёт сглаженную историю успехов по каждой задаче. Пока модель регулярно ошибается, эталон сильнее влияет на обновление; когда собственные решения становятся надёжными, его вес постепенно уменьшается.
Три сигнала чередуются: свежая подсказка исправляет текущую попытку, исторические распределения закрепляют найденное ранее поведение, а эталон возвращает обучение к проверенному решению там, где самодистилляции пока нельзя доверять. В разборе компонентов наибольшую пользу дали историческое закрепление и адаптивная опора на эталон. Направленное подавление токенов помогало только вместе с этими стабилизирующими сигналами.
Когда подход меняет план дообучения
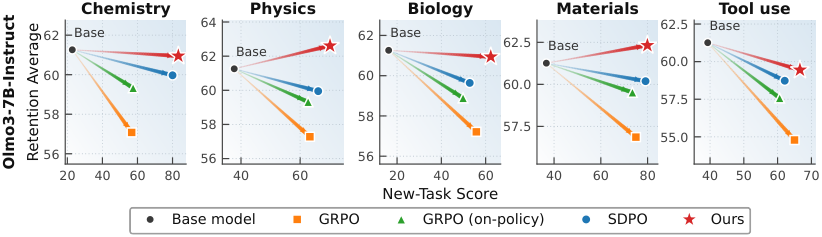
FSPO проверяли на Qwen3-8B и Olmo3-7B-Instruct: модели решали задачи по химии, физике, биологии, материаловедению и использованию инструментов. Результаты сравнивали с GRPO, его вариантом на данных текущей политики и SDPO при одинаковом пятичасовом бюджете. Основной показатель — avg@16, то есть средняя доля верных ответов среди повторных генераций.
FSPO показал лучший средний результат на обеих моделях. При этом пиковый объём временной памяти с сохранёнными распределениями составил около 5 МБ, поэтому выигрыш по памяти возник не из-за переноса большой копии весов на центральный процессор: её действительно заменил компактный набор прогнозов.
Работа меняет архитектурный выбор, если команда уже планирует RLVR или самодистилляцию и упирается в память GPU из-за постоянной модели-учителя. В таком случае стоит прототипировать хранилище разреженных распределений вместе с отбором разнообразных проверенных траекторий. Просто записывать успешные ответы и повторно обучаться на их тексте недостаточно: в разборе компонентов такие варианты уступили фиксированным вероятностным целям.
Оснований менять базовую модель или весь контур дообучения пока меньше. Проверка охватывает две модели, научные задачи и работу с инструментами при одном ограниченном бюджете. Результат показывает рабочий способ сократить память в таком режиме, но не устанавливает, как преимущество сохранится на более крупных моделях, других проверяющих механизмах и длительном обучении.
Источники
Иллюстрация: рисунок из статьи «Function-Space Temporal Self-Distillation for Policy Optimization», Aryan Das, Arnab Bhattacharya, Vinay Kumar Verma, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


