
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Gemma 4 научили генерировать текст быстрее с помощью встроенной модели-черновика, не запуская вторую полноценную модель. В препринте Google, который не прошёл рецензирование и приводит замеры самих авторов, максимальное ускорение составило 3,14 раза. Подход снижает задержку на сервере и помещается на мобильных устройствах, но эффект зависит от архитектуры основной модели.
Как G-MTP убирает повторную обработку контекста
При спекулятивном декодировании небольшая модель-черновик, или драфтер, предлагает сразу несколько следующих токенов. Основная модель проверяет их параллельно и принимает подходящую часть последовательности. Если черновик угадывает достаточно часто и работает дёшево, основная модель делает меньше последовательных проходов.
Отдельный драфтер сам обрабатывает весь входной контекст и создаёт собственный KV-кэш — сохранённые ключи и значения механизма внимания. Это требует дополнительного времени и памяти. На смартфоне второй кэш может занять больше памяти, чем доступно приложению.
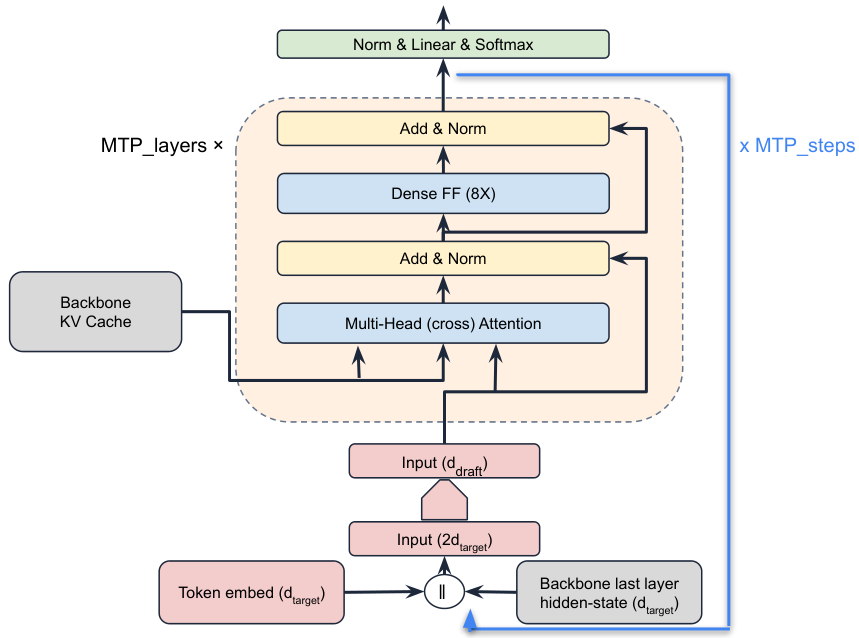
G-MTP вместо отдельной модели добавляет к Gemma 4 компактный общий блок Transformer. Перед началом черновой генерации он получает последнюю активацию основной модели, то есть уже вычисленное представление смысла контекста. После каждого предложенного токена блок передаёт своё состояние в следующий шаг и потому может продолжать последовательность дальше той длины, на которой его обучали.
Драфтер также обращается прямо к KV-кэшу основной модели. Он не копирует кэш и не обрабатывает исходный текст повторно. Это одновременно убирает отдельную подготовку контекста и даёт драфтеру доступ к представлениям, которые уже построила большая модель.
Для небольших вариантов Gemma 4 авторы заменили полный расчёт вероятностей по словарю двухступенчатым поиском. Сначала G-MTP выбирает подходящие группы токенов, затем считает точные оценки только внутри лучших групп. Такой фильтр требует примерно в 43 раза меньше операций на каждом шаге черновика.
Где архитектура превращается в реальное ускорение
На сервере выигрыш менялся вместе с основной моделью. Для Gemma 4 E4B скорость выросла в 2,33 раза, тогда как вариант со смесью экспертов ускорился лишь в 1,34 раза. Проверка нескольких черновых токенов активирует разные экспертные блоки, поэтому экономия на последовательных проходах частично уходит на дополнительную работу.
На мобильном NPU Gemma 4 E4B с G-MTP генерировала текст в 1,98 раза быстрее обычного авторегрессионного режима. Это показывает, что общий KV-кэш решает не только серверную задачу: драфтер работает и там, где отдельная модель-черновик создала бы лишнюю нагрузку на память.
Кластерная проекция словаря выглядит сильнее на уровне отдельной операции, чем на уровне продукта. На мобильном NPU она сократила время работы драфтера примерно на 20%, но итоговая генерация ускорилась лишь на 1%. Фильтр немного снизил долю принятых токенов и почти поглотил вычислительную экономию.
G-MTP также обошёл EAGLE-3 и DFlash при одинаковом движке, типе чисел и оборудовании. DFlash быстрее строил черновик параллельно, но основная модель принимала меньше предложенных токенов, поэтому вся система работала медленнее.
Архитектуру проверяли на линейке Gemma 4: серверные тесты запускали на NVIDIA H100 с vLLM и запросами SPEED-Bench, а мобильные — на GPU смартфона и Edge TPU. Адаптацию к новым задачам изучали на Gemma 4 E4B с SciQA и GSM8K. Работа измеряет скорость всей системы, но не разделяет серверную экономию между передачей активаций и общим KV-кэшем и не переводит её в стоимость запроса.
Когда G-MTP меняет план внедрения
Для продукта на Gemma 4 работа даёт готовый путь к снижению задержки: выпущены контрольные точки драфтеров и код адаптации. Сначала стоит измерить всю цепочку на целевом оборудовании, а не выбирать оптимизацию по числу операций. Пример с проекцией словаря показывает, что более дешёвый шаг не гарантирует более быструю генерацию.
При дообучении основной модели драфтер нельзя оставлять без изменений. На SciQA число полезных токенов за один проход основной модели упало на 36%, а на GSM8K — на 21%. Модель стала лучше решать целевую задачу, но старый драфтер перестал предсказывать её ответы.
Совместное дообучение или отдельная дистилляция вернули прежнюю эффективность. В наиболее заметном случае совместная настройка потребовала в 1,83 раза меньше проходов основной модели при генерации, чем настройка только основной модели. Значит, адаптацию драфтера следует включать в тот же конвейер, что и предметное дообучение.
Для других семейств LLM G-MTP пока служит архитектурным образцом, а не готовым модулем. Потребуются собственный драфтер, доступ к внутренним активациям и KV-кэшу, обучение и поддержка в движке вывода. Такой проект оправдан, когда задержка или память уже ограничивают продукт; при редких запросах выигрыш может не окупить отдельную инфраструктуру.
Источники
Иллюстрация: рисунок из статьи «Efficient and Robust Drafting with Multi-Token Prediction», Filippo Galgani, Ziwei Ji, Omri Homburger и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


