
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
KV-кэш гибридной LLM удалось сократить в десять раз, выбрав нужные записи ещё до появления запроса. В препринте Shanghai Jiao Tong University, который не прошёл рецензирование и содержит замеры самих авторов, GateSight оказался точнее остальных способов без запроса в трёх из четырёх сочетаний модели и бенчмарка. Сжатый кэш можно один раз подготовить после загрузки контекста, а затем использовать для разных вопросов.
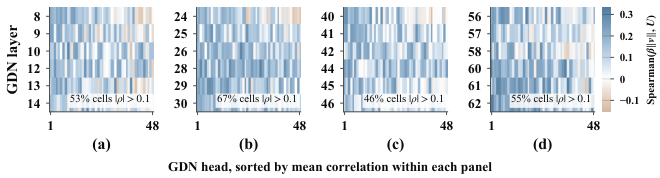
Гибридная модель чередует рекуррентные слои с фиксированной памятью и слои полного внимания. Последние хранят в KV-кэше ключи и значения для каждого токена, поэтому занятая ими память растёт вместе с контекстом. GateSight использует решения, которые рекуррентные слои уже приняли при чтении текста: насколько сильно записать очередной токен, как быстро его забывать и насколько велика запись.
Небольшая нейросеть для каждой головы KV-кэша сопоставляет эти сигналы с возрастом записи и оценивает её будущую полезность. Метод не ждёт вопроса, не вычисляет оценки внимания и не запускает модель по контексту второй раз. После первичного прохода он оставляет записи с наибольшей оценкой, физически уплотняет кэш и возвращает освобождённую память системе.
При таком сжатии GateSight обошёл KVzip во всех четырёх сочетаниях модели и бенчмарка на 9,5–47,2 пункта. На Qwen3.8-27B оценка полного контекста добавила около 0,5% ко времени его первичной обработки. Выигрыш относится именно к KV-кэшу слоёв внимания: веса модели и рекуррентные состояния метод не сокращает.
Проверка охватила Qwen3.8-27B и Qwen3.8-Flash-Next, бенчмарки SCBench и RULER-4096, а также контексты вплоть до предела моделей в 262 тысячи токенов. GateSight сравнивали с четырьмя другими методами, которые тоже выбирают записи без будущего запроса. Результат пока относится к гибридным архитектурам, где рекуррентные слои дают подходящие сигналы для управления кэшем внимания.
Источники
Иллюстрация: рисунок из статьи «GateSight: Recurrent Memory Anticipates Attention Memory for Query-Agnostic KV Eviction in Hybrid LLMs», Junjie Li, Jiong Lou, Jie Li, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


