Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
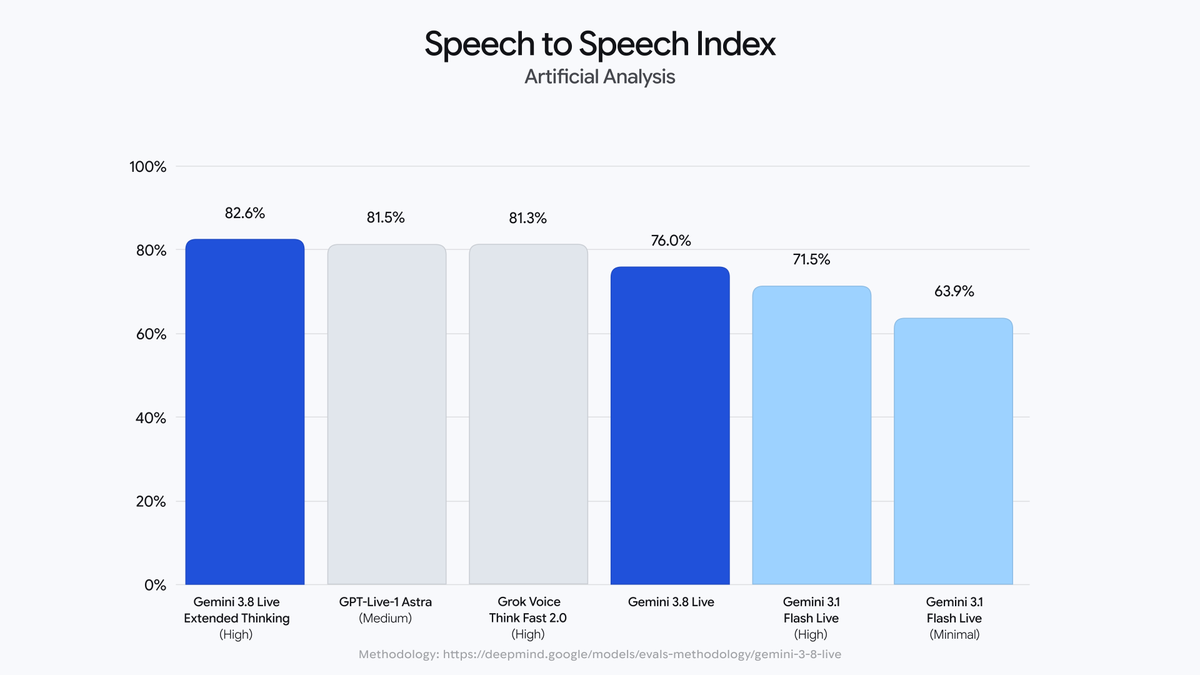
Google DeepMind представила разговорные модели Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking. Они рассчитаны на голосовых и визуальных ассистентов, которые должны продолжать диалог во время обращения к внешним инструментам или выполнения фоновой задачи.
Обе модели автоматически определяют один из 97 языков, анализируют визуальный контекст почти в реальном времени и получили улучшенные способности к рассуждению. Такой набор подходит ассистентам, которые принимают голосовые команды, работают с изображением и обращаются к API без паузы в разговоре.
Extended Thinking предназначена для более сложных задач, где важны дополнительные вычисления и точность. Пока задача выполняется, модель рассказывает о ходе работы: в демонстрации Google она выступала преподавателем программирования и сохраняла непрерывный диалог.
Обе версии уже доступны в Gemini Live и через Gemini API в Google AI Studio. В треде не указаны цена API, задержка в миллисекундах и результаты измерений качества, поэтому сравнить модели с текущим голосовым стеком перед внедрением пока нельзя.
Источники
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.