
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
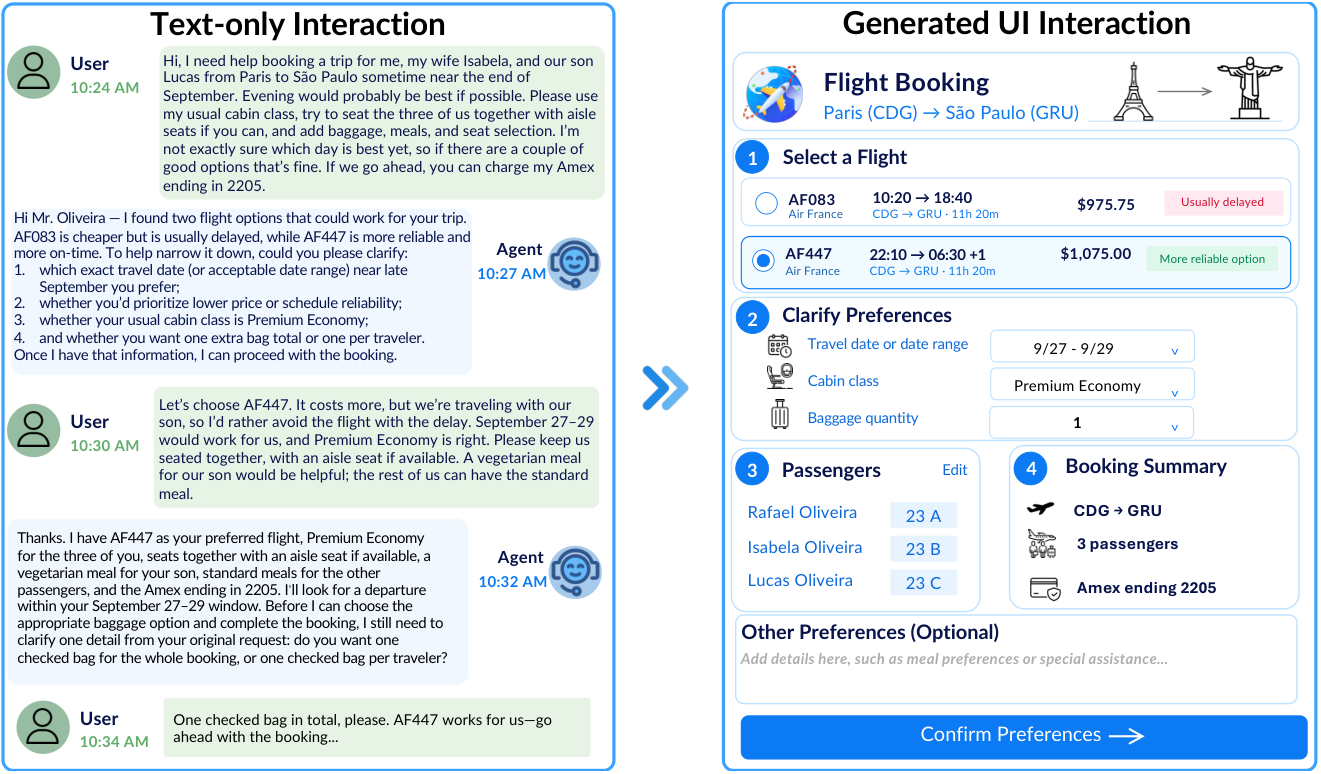
Агента научили превращать найденные в базе варианты и недостающие параметры в одноразовый интерфейс, а затем завершать действие без длинной переписки. Xiaolong Li и соавторы получили для GenUI-4B результат 58% по Pass@3 — доле задач, где хотя бы один из трёх запусков заканчивается точным целевым состоянием базы; препринт не рецензирован, а числа получили сами авторы. Для продуктовых команд это аргумент отделить интерфейс от агента, который ищет данные и вызывает инструменты, и проверять интерфейс по итоговой операции.
Интерфейс встраивают между поиском и действием
GenUI-Harness делит работу между двумя агентами. Агент инструментов сначала читает запрос, определяет нужную операцию и извлекает из базы профиль пользователя, подходящие записи и доступные варианты. На этом этапе он использует только инструменты чтения и не меняет данные.
Агент-кодировщик получает запрос и историю поиска. Он определяет, какие параметры уже известны, какие значения можно выбрать из найденных записей, а какие должен сообщить пользователь. Затем он создаёт компонент на React и TypeScript: например, список подходящих рейсов, переключатель тарифа и поле для ещё не указанного значения.
После отправки формы агент инструментов получает структурированные значения в JSON. Он может проверить выбор дополнительными запросами, собирает аргументы операции и вызывает инструмент, который меняет состояние базы. В отличие от обычного чата, пользователь выбирает среди записей, уже найденных в системе, а не описывает их заново словами.
Для обучения такого кодировщика недостаточно проверить, что код выглядит правдоподобно. Dynamic UX запускает компоненты в общем браузерном процессе, но изолирует каждый прогон отдельным контекстом. Система проверяет, загрузился ли интерфейс, какие элементы управления появились и какие данные он отправляет.
Reward Auditor решает вторую проблему: модель-оценщик может поставить высокий балл аккуратной форме с неработающей кнопкой или неверным форматом отправки. Аудитор сопоставляет оценки с фактическим состоянием базы после операции, находит успешные случаи с низкой наградой и неудачные с высокой, а затем пересобирает правила оценки. При повторной проверке интерфейсы остаются прежними, поэтому видно, изменилось ли именно качество награды, а не поведение обучаемой модели.
Точный результат важнее убедительного макета
Основные сравнения прошли на Lite-разделе UI-Tau Bench из 300 заданий. Они охватывают бронирование перелётов и отелей, электронную торговлю и розницу; базы собраны из открытых источников. В каждом задании есть исходное состояние, инструменты чтения и изменения, правила предметной области и эталонное состояние после операции.
Компактную модель сначала обучили на готовых траекториях, а затем дообучили кодировщик интерфейса с подкреплением, не меняя агента инструментов. После аудита награды средняя доля успешных прогонов Avg@3 достигла 36%. GenUI-Harness также обошёл smolagents по Pass@3 в среднем на 4,48 процентного пункта.
Обученный кодировщик улучшил результат каждой проверенной модели, когда авторы сохраняли её исходный поиск и финальное выполнение, но заменяли только генерацию интерфейса. Это показывает, что компонент можно переносить между агентами рассуждения, не обучая всю систему как единое целое.
Интерфейсы сократили среднее число раундов диалога с 3,4 до 1,2. Этот замер проводили на заданиях, где интерфейс корректно запускался и поддерживал взаимодействие во всех сессиях. Основные ошибки возникали позже ожидаемого: форма могла не позволить выбрать несколько вариантов или отправляла значение, которое не совпадало с аргументом операции.
Что менять в планах агентной системы
Работа поддерживает конкретную архитектуру для процессов, где агент читает записи, уточняет параметры и меняет состояние через API. Поиск данных, сбор пользовательского решения и выполнение операции стоит проектировать как отдельные этапы. Тогда генератор интерфейса можно обучать и заменять независимо от модели, которая вызывает инструменты.
Критерий приёмки такого интерфейса тоже меняется. Проверки синтаксиса, снимка элементов и визуальной правдоподобности недостаточно: испытание должно пройти через отправку формы, вызов инструмента и сравнение итогового состояния базы с ожидаемым. Модель-оценщик при этом остаётся дешёвым приближением, а не источником истины; его правила нужно сверять с выполненными операциями.
Генеративный интерфейс особенно уместен там, где схема действия известна, но набор вариантов зависит от текущих данных: бронирование, изменение заказа, выбор товара или ресурса. Он не требует превращать весь продукт в автоматически собранный интерфейс. Практический первый шаг — вынести один процесс с частыми уточнениями в отдельный контур и измерять успешное изменение данных, число диалоговых раундов и долю интерфейсов, которые нельзя корректно отправить.
Границы доказательства проходят по задачам с формальными инструментами, пользовательским симулятором и точно заданным состоянием базы. Человеческие рецензенты сравнивали каналы общения, но основной показатель успеха рассчитывался автоматически. Поэтому работа даёт основу для пилота в транзакционных процессах, а не общий вывод о замене заранее спроектированных экранов.
Источники
Иллюстрация: рисунок из статьи «When Interfaces Speak: Data-Aware Generative UI Harness for Active Interaction», Xiaolong Li, Xiaohan Xu, Jinyang Li и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


