
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
ИИ-агента научили учитывать не только итог научного проекта, но и путь к нему. Хотя препринт не прошёл рецензирование и все числа получили сами авторы, работа University of Chicago показывает: на новых проектах память из Git-истории предсказывает следующий шаг лучше навыков, собранных только из итоговых статей. Для команд это новый тип данных поверх научных публикаций — порядок проб, замен и отказов.
Как коммиты превращают в научные решения
Статья обычно показывает метод и итоговые эксперименты, но скрывает промежуточный путь. В репозитории остаются другие следы: исследователь меняет функцию потерь, добавляет сравнение, пробует новый набор данных, а затем удаляет неудачный вариант.
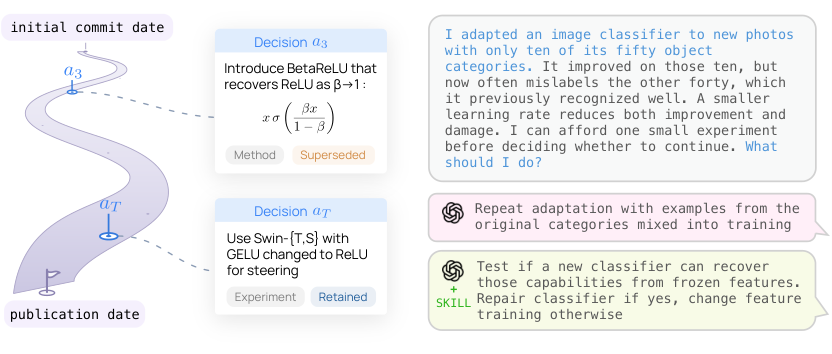
ResearchTrails собирает такие изменения в траекторию проекта. Единицей данных служит не отдельный коммит, а одно научное решение: изменить метод, поставить эксперимент или проверить вклад компонента. Несколько коммитов могут описывать одно решение, а один крупный коммит — содержать несколько решений.
Сначала конвейер связывает статью с репозиторием и отбирает проекты с заметной историей до выхода публикации. Репозиторий должен содержать как минимум пять ранних коммитов, а разработка — продолжаться достаточно долго, чтобы история отражала развитие проекта, а не разовую выгрузку кода.
Затем система читает исходный код, конфигурации и код ячеек блокнотов. Для первого появления файла она сохраняет содержимое, для последующих изменений — разницу между версиями. Контрольные точки моделей, журналы и служебные данные представлены только метаданными, чтобы они не забивали контекст.
Модель просматривает доказательства по времени и связывает коммиты с решениями. Обычное форматирование, обновление зависимостей и исправление опечаток она отделяет от исследовательской работы. Это существенно: 57% просмотренных коммитов не относились к научным решениям.
Каждое решение получает ссылки на коммиты и точные фрагменты изменений. После извлечения конвейер сверяет идентификаторы, пути и цитаты с сохранённой историей; решение без подтверждённого фрагмента отбрасывается. Наконец, система отмечает, сохранилось ли решение в проекте, было заменено следующим или оказалось отброшено.
Траектории помогают выбрать следующий шаг
Итоговый набор охватывает 599 проектов и 13 271 решение. В него вошли изменения методов, эксперименты и проверки отдельных компонентов, включая направления, которые не попали в финальную статью.
Авторы проверили два способа использовать этот материал. Первый не требует переобучать модель: агент получает похожие траектории как примеры либо использует навыки — обобщённые правила, извлечённые из последовательностей решений. Релевантные примеры работали лучше случайных, а добавление всех доступных примеров отвлекало модель.
Навыки из траекторий дали лучший результат и обошли прямой запрос к модели на 0,290 балла. Метрика проверяет, выбрала ли модель тот же компонент проекта и тот же тип изменения, который исследователи действительно сделали следующим.
Второй способ использует траектории для обучения Qwen3-8B. Сначала модель училась продолжать последовательность решений по человеческим примерам, затем её дополнительно обучали с наградой за сходство предложенного шага с реальным. Оценка выросла с 1,20 до 1,51: обучение с учителем научило модель воспроизводить ход проекта, а последующий этап улучшил качество непосредственно генерируемых решений.
Что менять в архитектуре научного агента
Работа не требует менять базовую модель. Практическое изменение лежит в слое памяти: вместо поиска только по статьям агенту можно возвращать близкие последовательности «состояние проекта — принятое решение — результат в коде». Такой поиск полезнее свалки примеров, потому что нерелевантные траектории снижали качество ответа.
Второе изменение касается подготовки данных. Если команда хочет учить агента на собственных проектах, ей стоит сохранять связь между изменением кода и исследовательской причиной, не вычищать из истории заменённые подходы и отделять научные шаги от технического обслуживания. ResearchTrails показывает автоматизированный вариант такого конвейера, но точные сообщения коммитов и структурированные эксперименты могут упростить извлечение.
Git при этом отражает только решения, которые оставили след в репозитории. В работе использованы проекты NeurIPS за четыре выпуска, связанные с публичными репозиториями и обладающие последовательной допубликационной историей. Значит, метод лучше описывает открытые проекты по машинному обучению с дисциплинированной разработкой, чем научную работу вообще.
Проверка тоже моделирует узкую задачу: предсказать следующий шаг по короткому началу уже существующей траектории, а качество определяет модель-оценщик. Это ещё не демонстрация автономного открытия. Для продуктового плана результат поддерживает ограниченный шаг: добавить память о ходе прошлых исследований и проверить её на собственных проектах до затрат на отдельное обучение.
Источники
Иллюстрация: рисунок из статьи «Learning Scientific Exploration from Human Research Decision Trajectories», Xuchen Gong, Shane Gu, Haokun Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


