
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Корпоративные проверки перед закупкой, интеграцией или выпуском системы можно передать программному контуру, не отменяя сами требования и ответственность. В препринте Jeremy Canale, который не прошёл рецензирование и содержит замеры самого автора, лучшая модель успешно выполнила 94,98% отдельных проверок, но заметно хуже прошла процессы целиком. Для внедрения это сдвигает акцент с выбора LLM на формализацию правил, доступ к доказательствам и стоимость оставшейся ручной работы.
Проверка становится исполняемым контрактом
Работа рассматривает governance-гейт как контракт с заранее заданными входами и результатом. Система получает досье проекта, разрешённые источники, версию политики и пределы полномочий. На выходе она должна выдать решение, перечислить нарушения и обязательные действия, приложить доказательства и зафиксировать основание своих полномочий.
Такое определение отделяет выполненную проверку от правдоподобного текста. Отказ может быть правильным результатом, если проект нарушает правило. Одобрение, наоборот, не засчитывается, если система пропустила обязательный дефект, сослалась на неподходящий источник или вышла за пределы делегированных прав.
Контракт также проводит границу между проверкой и последующими действиями. Агент может потребовать провести тест восстановления и корректно завершить обзор, но сам тест остаётся отдельной задачей. Если сотрудник вынужден заново прочитать досье и повторить решение, система лишь помогает ему, а не заменяет выполнение проверки.
Для передачи задачи должны одновременно выполняться три условия. Нужные факты доступны системе, правила позволяют получить однозначно допустимое решение, а полномочия дают право сделать это решение действующим. В статье приведён контрпример с документами: если разрешённые источники не содержат необходимого факта, ни агент, ни человек не смогут надёжно исполнить фиксированный контракт.
Высокий результат на одном гейте не гарантирует весь маршрут
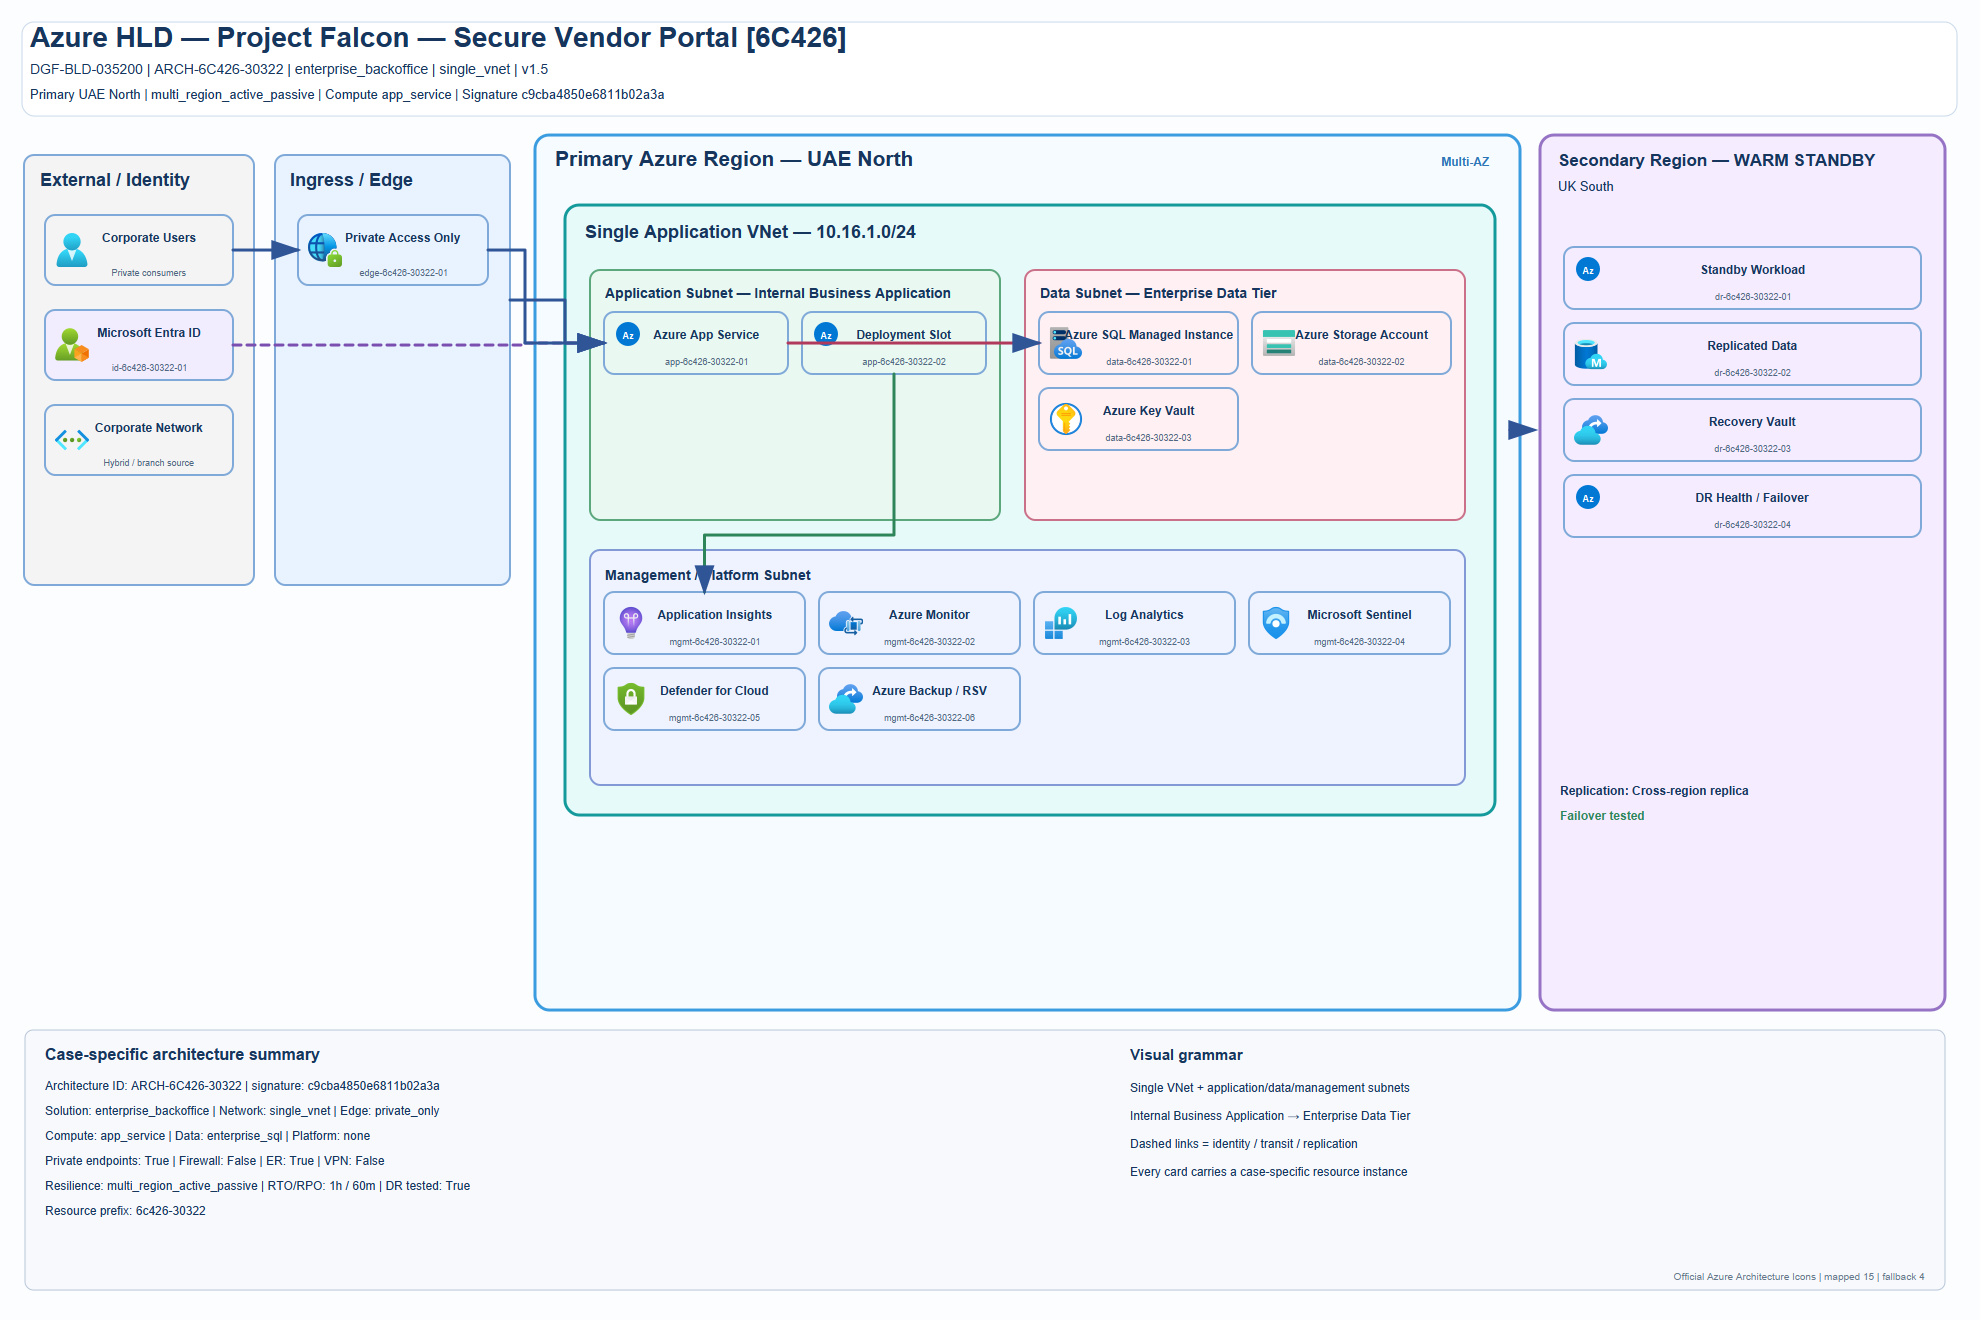
DGF-Bench включает 300 синтетических проектов и 899 пригодных для оценки запусков. Проекты проходят маршруты Buy, Integrate и Build с проверками закупок, договоров, соответствия требованиям, безопасности, архитектуры, готовности и итогового решения. Факты поданы в структурированном виде, а политики заранее формализованы.
Gemini 3.8 Flash успешно выполнила 94,98% отдельных гейтов по строгому критерию. Однако полный маршрут, где должны без ошибки пройти все обязательные проверки и передачи результатов, завершился успешно только в 76,92% случаев. Ошибка на одном этапе или неполная передача условий снижает надёжность всего процесса, даже когда каждый отдельный результат выглядит сильным.
Самая важная контрольная проверка не связана с LLM: детерминированная программа прошла все 1700 гейтов при тех же правилах и структурированных фактах. Значит, эксперимент прежде всего подтверждает исполнимость формализованного ядра решений. Он не доказывает, что языковая модель лучше обычного механизма правил.
Граница результата проходит именно здесь. Проверяли соответствие одной заданной системе правил на сгенерированных досье, а не поиск фактов в корпоративных хранилищах, согласование спорных политик или работу сотрудников в реальной компании. Замеры показывают качество обзоров, но не количество сэкономленных рабочих часов.
Планы меняет не модель, а учёт остаточной работы
Команде не стоит строить такой контур как цепочку вызовов одной LLM. Детерминированный механизм должен проверять пороги, обязательные условия и приоритеты правил. Агенту остаются поиск подходящих фактов, разбор противоречий и сборка понятного заключения; сервис доказательств хранит источники, слой полномочий ограничивает допустимые решения, а спорные случаи уходят сотруднику.
Начинать имеет смысл с узкого класса проверок, где уже существуют стабильные политики, структурированное досье и понятный владелец решения. Версии правил и источников нужно записывать вместе с заключением, иначе результат нельзя воспроизвести при аудите. Расширять охват следует только после проверки целых маршрутов, а не отдельных ответов.
Доля автоматически обработанных случаев сама по себе не показывает экономию. После внедрения люди продолжают разбирать исключения, проверять результаты, исправлять ошибки и поддерживать интеграции. Автоматизация сокращает труд только тогда, когда сумма этих часов меньше времени, которое раньше занимали переданные системе проверки при том же объёме и качестве работы.
Редкие случаи могут оказаться самыми дорогими: простой поток исчезнет, а сотрудникам останутся спорные договоры, неполные документы и конфликты полномочий. Поэтому до масштабирования нужен единый учёт труда внутри прежней границы процесса и вокруг нового контура. Если проверяющие экономят время, но его в том же объёме тратят инженеры сопровождения и владельцы политик, замены работы не произошло.
Работа меняет план внедрения в одном существенном месте: пилот должен доказывать не только точность решения, но и сокращение полного человеческого труда. DGF-Bench даёт схему для первого теста. Второй можно провести только на реальном процессе с его документами, исключениями, исправлениями и стоимостью поддержки.
Источники
Иллюстрация: рисунок из статьи «The Last Human Gate: Forward Deployed Engineering for Governance Automation», Jeremy Canale, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


