
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Обновления LLM при обучении с подкреплением можно ограничивать не одной фиксированной отсечкой PPO, а комбинацией меры изменения политики и способа её оценки. В работе AIR Tsinghua и ByteDance Seed лучшая комбинация превзошла GRPO на математических задачах на 49,8%, хотя работа не рецензирована и числа в ней получены самими авторами. Для команд это превращает выбор варианта PPO из перебора эвристик в проверяемую матрицу решений.
Фиксированная отсечка PPO оказалась частным случаем
При обучении с подкреплением модель меняет вероятности следующих токенов так, чтобы чаще получать награду. Если разрешить слишком большой сдвиг за один шаг, обучение становится нестабильным; если ограничить его слишком жёстко, модель перестаёт исследовать редкие, но полезные продолжения.
PPO удерживает новую политику рядом со старой через отсечение отношения вероятностей. Когда отношение выходит за заданный диапазон, соответствующий пример больше не усиливает градиент. Авторы показывают, что такую отсечку можно трактовать как ограничение полного вариационного расстояния, оценённого по одному выбранному токену методом Монте-Карло.
У этой схемы нет кривизны: малые и большие отклонения получают одинаковое предельное сопротивление. Из-за шума одного наблюдения отсечка также может сработать на токене, который сильно изменился относительно своей прежней вероятности, но почти не влияет на распределение целиком.
GPPO — обобщённая проксимальная оптимизация политики — разделяет конструкцию на две независимые оси. Первая задаёт расхождение, то есть меру различия между старым и новым распределением. Вторая определяет, как оценить это различие по токенам, доступным во время обучения.
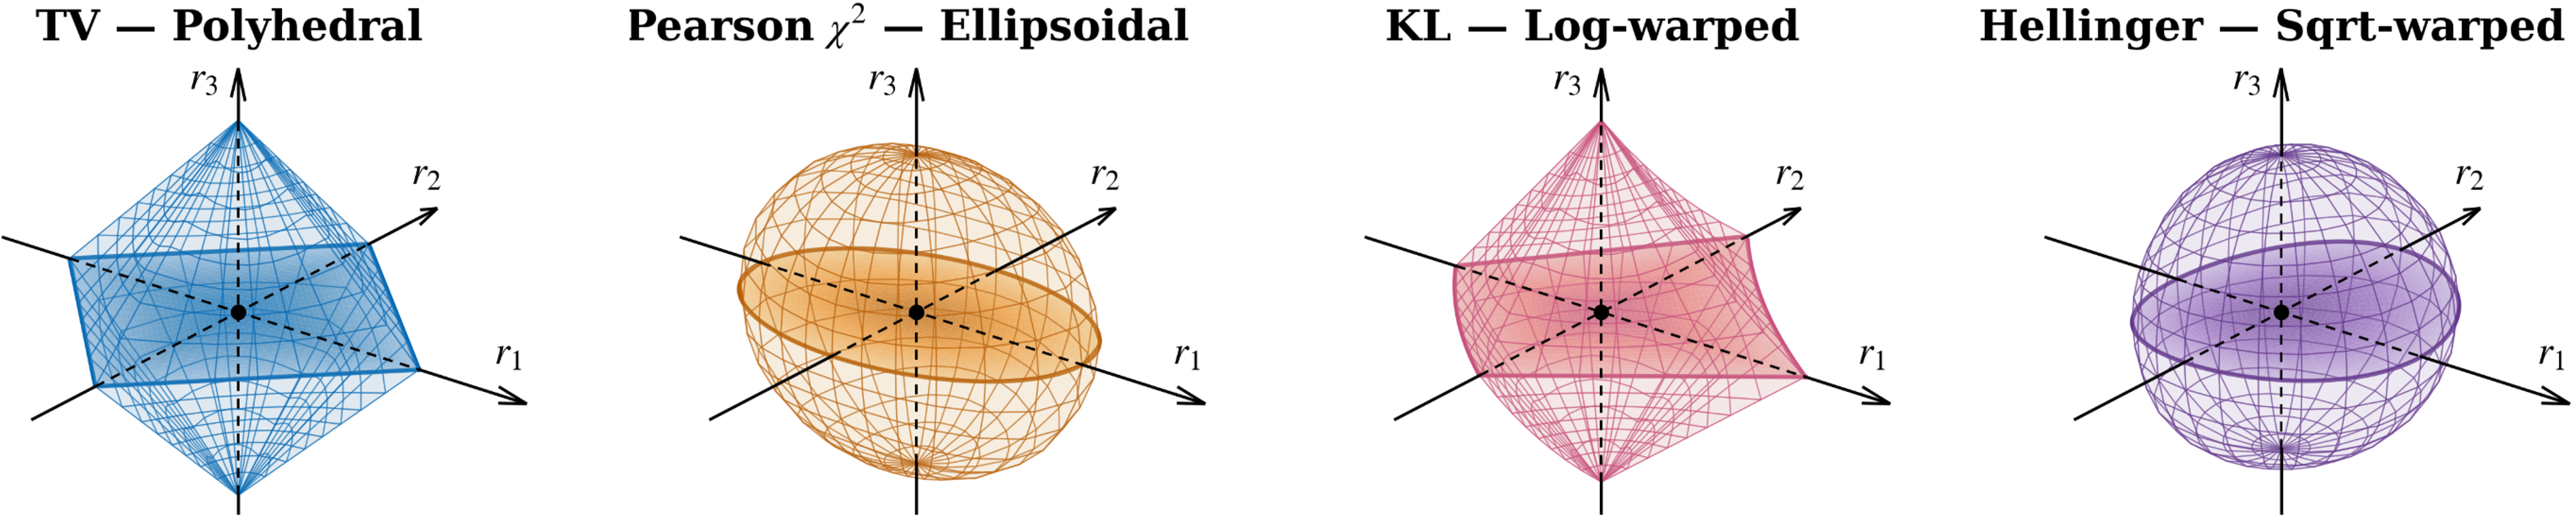
В пространство вариантов входят полное вариационное расстояние, KL-расхождение, расхождение Hellinger и χ² Pearson, а также три схемы оценки. GRPO, DAPO, DPPO и RIPO занимают отдельные клетки этой матрицы, поэтому их отличия больше не выглядят набором несвязанных правил отсечения.
Теоретическая часть распространяет доверительную область на семейство f-расхождений и выводит нижнюю границу, при которой точное ограничение гарантирует монотонное улучшение ожидаемой награды. Практический GPPO не решает такую задачу напрямую: он переносит геометрию выбранного расхождения в доступную для LLM отсечку первого порядка.
Способ оценки решает, какие редкие токены сохранить
Оценка по одному токену подставляет в ограничение только его отношение вероятностей. Она не учитывает, насколько вероятным этот токен был до обновления, поэтому редкое продолжение может попасть под отсечку из-за большого относительного сдвига.
Атомарная оценка умножает вклад токена на его прежнюю вероятность. Большое изменение редкого токена тогда не считается большим сдвигом всего распределения автоматически. Это оставляет модели больше пространства для исследования ветвей, которые прежде имели малую вероятность.
Бинарная оценка делит словарь на выбранный токен и все остальные токены. Она учитывает не только изменение выбранного варианта, но и то, как перераспределилась оставшаяся вероятностная масса. Такой подход ближе к изменению распределения целиком, хотя в экспериментах атомарная схема чаще давала лучший итог.
Геометрия и оценка работают совместно. KL-расхождение сильнее сопротивляется сокращению вероятности и мягче относится к её росту, а атомарная схема дополнительно защищает редкие действия от преждевременной отсечки. Поэтому нельзя выбрать «лучшее расхождение» отдельно от метода, который превращает его в практическое ограничение.
Командам стоит расширить эксперимент, но не менять весь контур обучения
Проверка охватывала восемь соревновательных наборов задач по математике и программированию. Обучали Qwen3-8B-Base на данных с проверяемой бинарной наградой и сравнивали варианты при общей схеме GRPO; радиусы доверительной области калибровали по одной стороне стандартной отсечки, чтобы отделить геометрию от масштаба ограничения.
Комбинация KL-расхождения с атомарной оценкой улучшила средний результат относительно GRPO на 49,8% в математике и на 13,9% в программировании. Атомарная оценка заняла первое место во всех столбцах таблицы по коду и показала лучший средний результат по математике. При оценке по одному токену энтропия быстрее падала почти до нуля, после чего качество выходило на плато; две вероятностно-зависимые схемы дольше сохраняли разнообразие генераций.
Если команда уже обучает рассуждающую модель с проверяемой наградой, работа меняет план экспериментов. Вместо сравнения только GRPO, DAPO или очередного правила отсечения имеет смысл зафиксировать остальной контур и отдельно перебрать меру расхождения и схему оценки. Сравнивать следует не только итоговый балл, но и энтропию политики: раннее падение покажет, что ограничение подавляет исследование.
Перестраивать хранение данных, вычисление награды или запуск модели не требуется: GPPO меняет функцию потерь и правило отсечения внутри обучения. Границы вывода задаёт сам эксперимент — одна базовая модель, математика и код с автоматически проверяемыми ответами. Для обучения по человеческим предпочтениям, задач с непроверяемой наградой и моделей другого масштаба эта матрица остаётся гипотезой для собственного замера, а не готовой настройкой.
Источники
Иллюстрация: рисунок из статьи «Generalized Proximal Policy Optimization: Unifying LLM RL Algorithms from the Perspective of Divergence», Zhicheng Cai, Xinyuan Guo, Hanlin Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


