
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Изменения, рассчитанные на этапе предобучения LLM, научились переносить в готовую модель без повторного последующего обучения. В препринте, который не прошёл рецензирование, авторы получили более чем двукратное сокращение «дрейфа реальности» и потери согласованности предпочтений. Метод позволяет быстрее проверять вмешательства в убеждения и поведение модели, не дообучая каждый вариант с нуля.
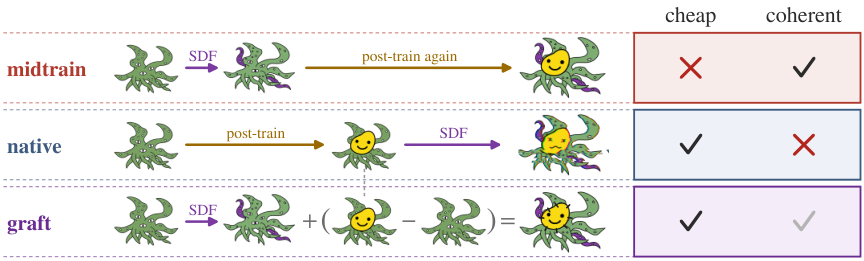
Обычный подход дообучает готовую модель на синтетических документах с нужными фактами или правилами. Он внедряет целевое убеждение, но затрагивает уже настроенное поведение: модель начинает считать реальными вымышленные сущности, которых не было в учебных документах. Метод grafting разделяет эти этапы: компактное обновление весов обучают на базовом снимке после предобучения, а затем прибавляют к весам модели, которая уже умеет выполнять инструкции.
Grafting сохранил силу целевого убеждения, но устранил 68–78% дрейфа реальности и 35–85% потери согласованности предпочтений по сравнению с дообучением готовой модели. Деталь видна на Qwen3-14B: после обычного дообучения модель оценивала вероятность реальности Harry Potter в 55%, после grafting — в 25%, а исходная модель — в 1%. При этом результаты по общим знаниям, рассуждению, выполнению инструкций и вызову инструментов в среднем оставались близкими у двух способов.
Метод проверяли на Qwen3-14B, Llama-3.3-70B и семействах моделей вплоть до смеси экспертов с 284 млрд параметров. Эксперименты охватывали ложные факты, скрытые склонности, нежелательное поведение и вмешательство на основе набора правил. Перенос не всегда сразу выражал целевое поведение так же сильно: на Llama разрыв с обычным дообучением сначала составил 32 пункта, но после дополнительного обучения скрывать склонность сократился до 2 пунктов.
Практический выигрыш относится прежде всего к исследованиям безопасности и настройке устойчивых правил поведения. Одно обновление можно обучить на базовой модели и применять к её более поздним версиям, не повторяя дорогое последующее обучение ради каждой редакции корпуса.
Источники
Иллюстрация: рисунок из статьи «Pre-training interventions, ex post facto: Grafting model beliefs across checkpoints», Peter Nutter, Dani Roytburg, Cl\'ement Dumas и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


