
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
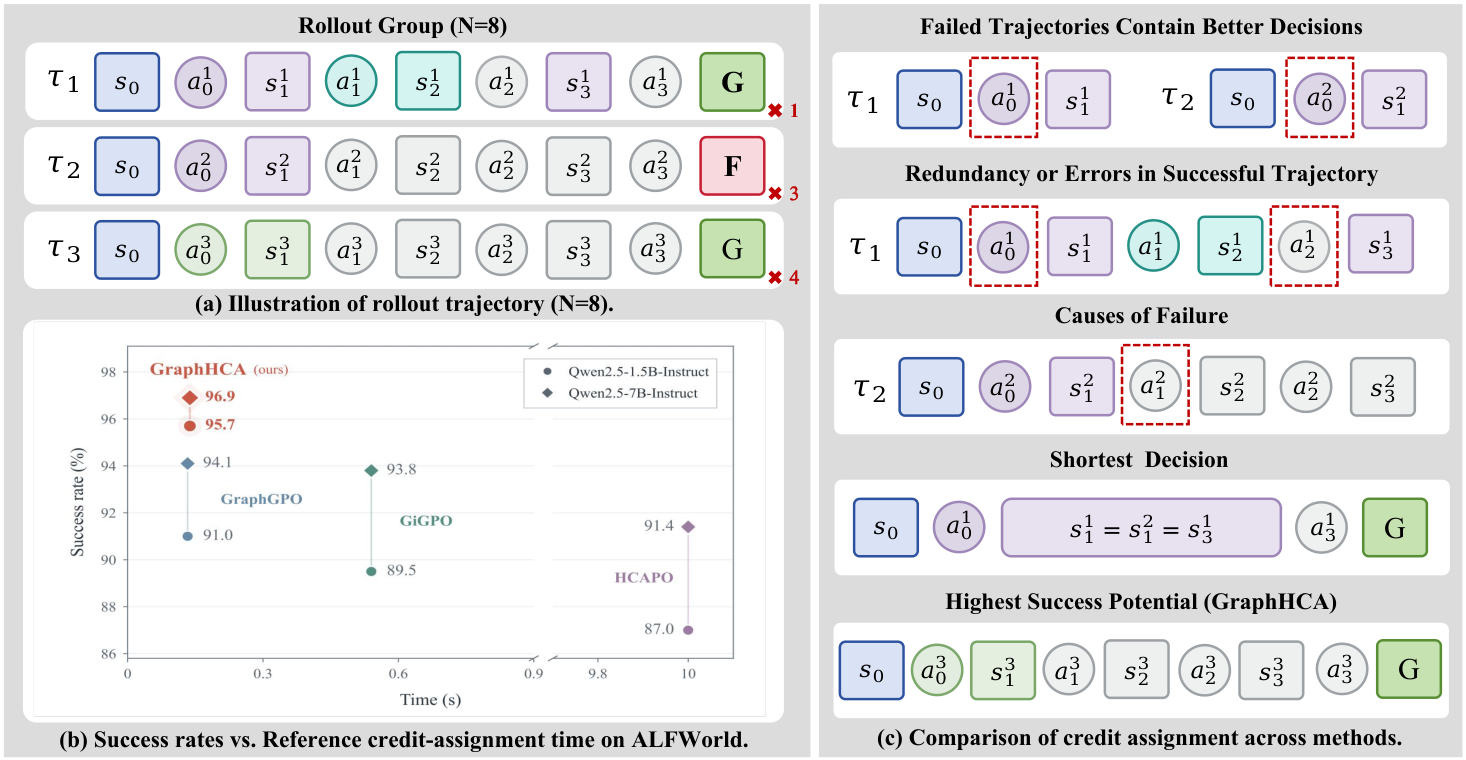
LLM-агентам дали пошаговый сигнал обучения там, где среда сообщает только итоговый успех или провал. GraphHCA обошёл GRPO и другие способы распределять награду между действиями, хотя препринт не рецензирован и все числа в нём получили сами авторы. Такой сигнал можно добавить к уже собранным траекториям без отдельной модели и повторного вызова LLM.
Как итоговый успех превращают в оценку отдельного шага
В длинной задаче агент выполняет цепочку действий, а награду получает только в конце. Если заказ оформлен или головоломка решена, успешной считается вся траектория. По такому ответу трудно понять, какое действие помогло, какое оказалось лишним, а какое едва не сорвало результат.
GRPO решает проблему грубо: запускает несколько траекторий для одной задачи, сравнивает их итоговые награды и присваивает всем шагам внутри каждой траектории одинаковое преимущество. Поэтому полезное действие из неудачной попытки получает отрицательный сигнал, а ошибка внутри успешной — положительный.
Ретроспективное распределение награды HCA оценивает действие иначе. Оно сравнивает обычную вероятность выбрать действие с вероятностью выбрать его при условии, что агент впоследствии достиг цели. Такое сравнение лучше связывает шаг с результатом, но обычно требует обучить вспомогательную модель либо ещё раз запустить основную модель с известным исходом.
GraphHCA убирает этот дополнительный расчёт для задач с однозначными переходами и двумя конечными исходами: успехом и провалом. После действия состояние среды известно, поэтому вклад шага можно выразить через отношение вероятностей будущего успеха до и после перехода. Логарифм этой вероятности авторы называют потенциалом успеха, а его изменение между соседними состояниями становится пошаговой наградой.
Чтобы оценить потенциал, алгоритм объединяет собранные траектории в граф. Одинаковые состояния становятся одной вершиной, действия — рёбрами, а частота наблюдавшихся действий задаёт их вес. Итоговые успехи и провалы распространяются назад по графу с ослаблением, которое учитывает длину пути и обеспечивает единственное решение даже при циклах.
Полученные оценки сравнивают только между действиями из одного состояния. Затем пошаговый сигнал складывают с преимуществом всей траектории. Если этот добавочный вес выключить, обучение снова становится обычным GRPO.
Где оценка вероятности оказалась полезнее кратчайшего пути
На ALFWorld GraphHCA повысил общую долю успешных задач на 24,6 процентного пункта относительно GRPO и на 4,7 пункта относительно сильнейшего пошагового метода. Наибольший выигрыш пришёлся на длинные подзадачи, где между исходным состоянием и целью лежит больше решений.
На WebShop прибавка к GRPO составила 17,2 пункта для младшей модели и 7 пунктов для старшей. Это согласуется с основной идеей работы: по мере удлинения траектории единая награда для всех действий даёт всё менее точный сигнал.
В визуальном Sokoban агент с GraphHCA решил 84% задач и также обошёл остальные проверенные способы обучения. Метод переносится с текстовых состояний на изображения, если среда всё равно позволяет определить состояние и однозначный результат действия.
Отдельное сравнение показывает, зачем графу нужны частоты переходов. GraphGPO оценивает продвижение по кратчайшему найденному пути к цели, тогда как GraphHCA учитывает ожидаемый успех по всем наблюдавшимся продолжениям. Поэтому редкий удачный маршрут не заслоняет частые действия, которые обычно ведут к провалу.
Когда GraphHCA меняет план обучения агента
Метод стоит рассматривать как надстройку над групповым обучением, а не как замену агентной архитектуры. Он использует уже собранные траектории, не требует критика или модели ретроспективных вероятностей и не добавляет вызовов основной LLM. Расчёт графа занял 0,062% измеренного времени одной итерации, тогда как основная стоимость пришлась на получение траекторий и обновление модели.
Проверка охватывает ALFWorld, WebShop и Sokoban. В текстовых средах обучали Qwen2.5-1.5B-Instruct и Qwen2.5-7B-Instruct, в визуальной — Qwen2.5-VL-3B-Instruct; для каждой задачи собирали группу из восьми траекторий. Это эксперименты на исследовательских интерактивных средах, а не на производственных цепочках вызовов API.
Теоретическое упрощение опирается на более важную границу: переход после действия должен быть однозначным, а вероятность успеха — зависеть от текущего состояния, а не от скрытой истории или оставшегося времени. Задача также должна завершаться проверяемым успехом либо провалом. Если процесс стохастический, промежуточные награды имеют самостоятельный смысл или состояние нельзя надёжно сопоставить между траекториями, вывод формулы напрямую на него не переносится.
Для подходящих задач работа меняет прежде всего план эксперимента. Команде не нужно сразу добавлять обучаемого критика или оплачивать повторный проход LLM ради пошаговой оценки. Сначала можно сохранить состояния и переходы из групповых запусков, построить общий граф и проверить GraphHCA поверх GRPO; отключаемый пошаговый вес оставляет прямую контрольную конфигурацию.
Источники
Иллюстрация: рисунок из статьи «GraphHCA: Closed-Form Hindsight Credit Assignment for Long-Horizon LLM Agents», Haodong Zhu, Yangyang Ren, Changbai Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


