
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Персонализированную LLM научили учитывать подробные требования пользователя во время обучения, но отвечать без этих требований после запуска. В препринте Yilun Qiu и соавторов, который не прошёл рецензирование и приводит замеры самих авторов, GRASP на Gemma2-9B дал средний относительный прирост 14% к сильнейшему конкуренту. Для продукта это вариант перенести персонализацию из планировщика или награды за готовый ответ непосредственно в модель.
Рубрика подсказывает модели каждый следующий токен
Рубрика здесь — перечень аспектов, которые конкретный пользователь ожидает увидеть в ответе. Один человек может предпочитать проверенные варианты, другой — новые; фактически верный ответ не будет персонализированным, если раскроет не те аспекты.
Прежние подходы используют такую рубрику целиком. Отдельный планировщик сначала выбирает нужные аспекты, после чего генератор пишет ответ по плану. Другой вариант превращает покрытие аспектов в одну итоговую награду и обучает модель с подкреплением. В обоих случаях генератор получает слабую подсказку о том, какие именно решения внутри ответа приблизили его к требованиям пользователя.
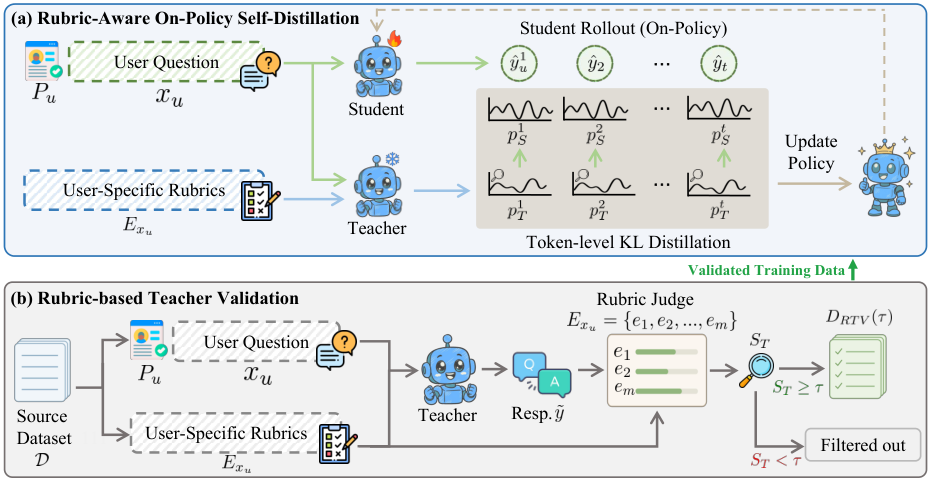
GRASP создаёт учителя и ученика из одной исходной модели. Ученик видит вопрос и историю пользователя, а замороженный учитель дополнительно получает целевую рубрику. При эксплуатации остаётся только ученик, поэтому рубрику не нужно передавать при каждом запросе.
Ответ генерирует сам ученик. На каждом уже созданном фрагменте учитель и ученик рассчитывают вероятности следующего токена по всему словарю. Обучение уменьшает расхождение между этими распределениями: ученик перенимает предпочтения учителя именно в тех состояниях, в которые попадает при собственной генерации.
Это отличает GRASP от обучения на готовых ответах учителя. Модель не копирует отдельную эталонную последовательность, а узнаёт, какие продолжения лучше соответствуют рубрике после каждого своего шага. В обучающем наборе при этом нет эталонных ответов: нужны вопрос, профиль пользователя и критерии желаемого ответа.
Проверка учителя отсекает плохие подсказки
Доступ к рубрике ещё не означает, что учитель ей следует. Он может пропустить один из аспектов, а ученик затем закрепит эту ошибку через подробный сигнал на каждом токене.
Перед основным обучением GRASP отдельно генерирует ответ учителя и передаёт его модели-оценщику. Та проверяет, насколько ответ покрывает каждый пункт рубрики. В основной набор попадают только примеры, где учитель раскрыл все требуемые аспекты; проверку выполняют один раз при подготовке данных.
Строгий отбор улучшил результат на всех четырёх проверенных моделях. Более мягкие пороги давали нестабильный эффект: частично подходящие ответы учителя сохраняли сигнал, который уводил ученика от целевых требований.
Дополнительный опыт подтвердил, что работает именно связь рубрики с вопросом. Когда наборы критериев случайно переставляли между примерами, качество падало на каждой модели. Значит, прирост нельзя объяснить тем, что учителю просто добавили больше текста в контекст.
Менять стоит обучение, но не доставку профиля
GRASP проверили на LaMP-QA — наборе персонализированных вопросов из трёх тематических областей. В опытах участвовали Gemma2-9B, Qwen2.5-7B, Qwen2.5-14B и Qwen3-4B, а ответы оценивал Qwen2.5-32B-Instruct по покрытию пользовательских аспектов. Поэтому вывод относится к длинным персонализированным ответам, которые можно проверить по заранее сформулированным критериям.
Механизм сработал так, как предполагала схема обучения. Направление изменения вероятности совпало с подсказкой рубрики для 79,2% проверенных токенов. Среднее расхождение между распределениями учителя и ученика сократилось с 1,101 до 0,444, причём каждый проверенный ответ приблизился к учителю.
Работа меняет планы команд, у которых уже есть рубрики для обучающих примеров: требования редакторов, настройки клиента или критерии ответа можно использовать не только для итоговой оценки. Они становятся подробным обучающим сигналом без отдельного планировщика и без рубрики в рабочем запросе.
Однако GRASP не отменяет доставку пользовательского контекста. При каждом ответе ученик по-прежнему получает вопрос и профиль; из рабочего контура исчезает только рубрика. Команде также понадобится дополнительный этап подготовки данных: сгенерировать ответы учителя, проверить их и отбросить примеры с неполным покрытием.
Если продукт персонализирует ответы только через динамический контекст и не располагает критериями для каждого обучающего вопроса, схема не даёт готовой замены. Если такие критерии уже собирают, разумный следующий опыт — сравнить GRASP с текущим дообучением на собственном наборе, сохранив одинаковые профили и модель-оценщик.
Источники
Иллюстрация: рисунок из статьи «Rubric-Aware On-Policy Self-Distillation for LLM Personalization», Yilun Qiu, Xiaoyan Zhao, Chengbing Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


