
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Повторяющиеся решения ИИ-агента удалось перенести из запросов к модели в код, который сохраняется между задачами. Growing Harness сократил число обращений к LLM на 76–92%, хотя препринт не проходил рецензирование и содержит замеры самих авторов. Подход позволяет оставить модели смысловые решения, а проверку, восстановление после ошибок и остановку выполнять обычной программой.
Агент учится менять управляющий код, а не модель
Управляющий код агента (harness) определяет, когда вызвать модель или инструмент, как обработать ответ, что делать после ошибки и в какой момент завершить задачу. Обычный агент часто поручает эти решения LLM заново: добавляет инструкции в контекст, получает очередной ответ и переносит всю историю в следующий запрос.
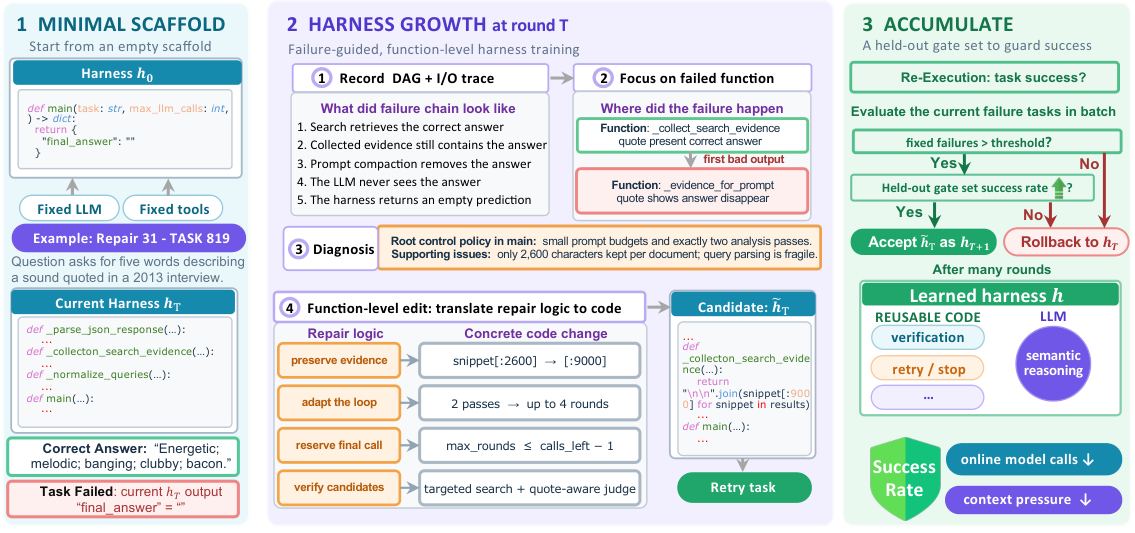
Growing Harness начинает с каркаса, где заданы только интерфейсы модели, инструментов и точки входа. Готовой стратегии решения задач в нём нет. Модель и инструменты во время обучения не меняются — система редактирует только программу вокруг них.
После неудачного запуска система записывает путь исполнения по функциям, обращения к модели и инструментам, ошибки и промежуточные результаты. Оптимизатор получает несколько таких неудач одновременно и создаёт новую версию программы. Он может менять только функции, которые участвовали в проблемных запусках, и добавлять небольшие вспомогательные функции.
Так в код переходят операции с однозначными правилами: разбор ответа, проверка результата, обновление состояния, уточнение запроса, повтор после ошибки и условие остановки. Интерпретацию текста, поиск смыслового соответствия и подготовку итогового ответа по-прежнему выполняет LLM.
Кандидат сначала должен собраться и сохранить прежние интерфейсы. Затем его повторно запускают на текущих неудачах и на отдельной контрольной выборке. Если исправление портит уже освоенное поведение, всю последовательность изменений откатывают.
Меньше вызовов модели без обмена качества на экономию
Growing Harness сравнили с Tool-Calling и другими агентами на BrowseComp-Plus и WebArena-Verified. Первый набор требует искать и проверять сведения, второй — управлять браузером в задачах, связанных с Shopping, Reddit и Map.
Число обращений к LLM снизилось на 76–92%, а стоимость работы развёрнутого агента — до 99%. При этом Growing Harness показал лучший средний результат почти во всех сочетаниях модели и набора задач, а в оставшемся уступил лидеру в пределах одного процентного пункта.
На WebArena-Verified доля успешно выполненных задач держалась около 45% при разных размерах модели. У Tool-Calling с самой компактной моделью она упала до 7%. Повторяющееся управление браузером оказалось той частью работы, которую небольшой модели особенно трудно каждый раз восстанавливать из текстовых инструкций.
Проверка отдельных компонентов подтверждает, что результат даёт не только генерация кода. Если разрешить оптимизатору переписывать программу без привязки к пути исполнения, поиск исправлений работает хуже. Если убрать контрольную выборку, новые изменения могут уничтожить прежние навыки. Ремонт нескольких неудач вместе чаще создаёт общее правило, чем исправление одной задачи.
Эксперименты охватывают два семейства веб-задач и три модели для исполнения — от компактной до крупной. Каждой тестовой задаче давали одну попытку, результаты усредняли по независимым запускам. В расчёт онлайн-стоимости вошли только обращения рабочего агента: расходы на отдельную модель-оптимизатор и проверяющие системы туда не включали.
Планы стоит менять там, где агент повторяет один класс работы
Работа предлагает рассматривать контекст модели не как единственное место для логики агента. Если продукт регулярно обрабатывает однотипные обращения через стабильные инструменты, повторяющиеся решения можно накапливать в программе. Контекст тогда содержит сведения конкретной задачи, а не заново описывает весь порядок действий.
Для архитектуры это означает разделение двух слоёв. Код отвечает за проверяемые переходы, ограничения и восстановление после известных сбоев; LLM — за решения, которые зависят от смысла входных данных. Трассировка должна связывать ошибку с конкретными функциями, иначе оптимизатору придётся каждый раз просматривать и переписывать весь агент.
Нужен и независимый набор регрессионных задач. Успех на текущей ошибке ещё не означает, что версия стала лучше: изменение принимают только после проверки ранее освоенного поведения. В рабочей системе к этому добавляются изоляция исполняемого кода, явные границы разрешений и обычная проверка изменений перед выпуском.
Экономика зависит от повторного использования. Growing Harness тратит ресурсы на офлайн-оптимизацию, поэтому выигрыш появляется, когда выросшая программа обслуживает достаточно много новых задач того же семейства. Для разовых или сильно различающихся процессов работа не показывает такого преимущества.
Источники
Иллюстрация: рисунок из статьи «Grow the Harness, Not the Context: From Strategy-Free Scaffolds to Reusable Specialist Agents», Laizhen Li, Jiarui Li, Juanjuan Zhao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


