
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
GUI-агента научили пользоваться старыми траекториями действий, не доверяя им без проверки. В нерецензированном препринте, где все числа получили сами авторы, команда Xi’an Jiaotong University, MiLM Plus и Xiaomi показала: при переносе между наборами задач средняя прибавка к точности выросла с 3,19 до 6,81 процентного пункта по сравнению с обычной донастройкой. Для продукта это предлагает другой подход к памяти агента: хранить опыт как подсказку, а не как готовый сценарий.
Агент сам строит карту приложения
Работа посвящена агентам, которые управляют Android-приложениями через снимки экрана и сведения о доступных элементах. Таким системам часто не хватает знаний о конкретном приложении: где спрятан раздел, какое условие открывает настройку и ведёт ли заметная кнопка к нужной функции или к рекламе.
Эти знания можно извлекать из прошлых запусков. В статье такую найденную раньше траекторию называют приором: это последовательность состояний интерфейса, действий и результатов, которая может помочь выполнить новую задачу.
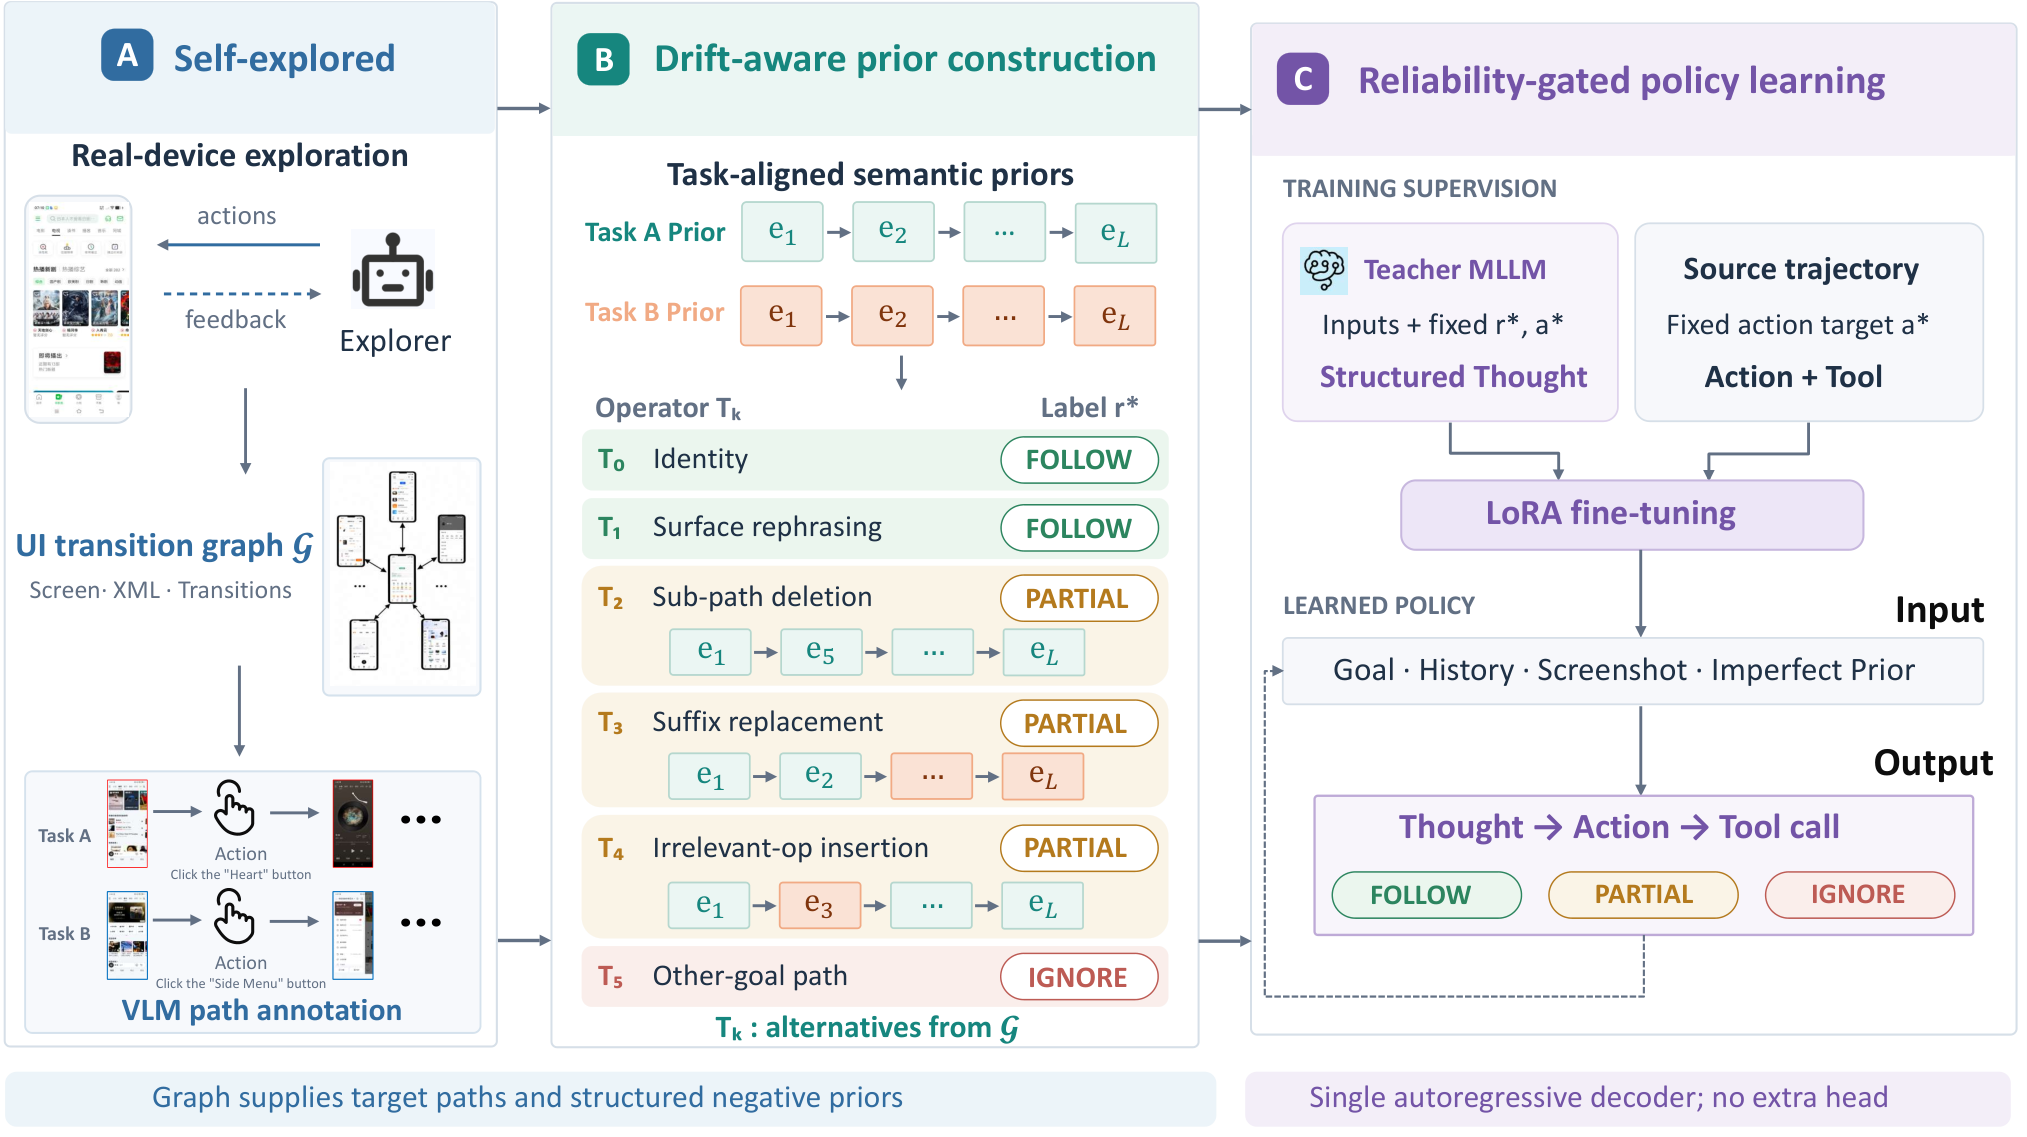
SAGE собирает приоры без пользовательских демонстраций. Исследователь интерфейса нажимает доступные элементы, записывает переходы и собирает из них граф: вершинами становятся экраны, рёбрами — действия. Мультимодальная модель затем формулирует для пройденных путей подходящие пользовательские задачи.
Исследователь не перебирает все элементы одинаково. Он отдаёт приоритет навигации и функциональным кнопкам, сокращает число переходов по однотипному содержимому и пропускает отвлекающие области. Если возврат приводит не на ожидаемый экран, система записывает новый переход и пытается восстановить путь по графу, а не сразу перезапускает приложение.
Динамические рекомендации и реклама могут создавать десятки визуально разных копий одного состояния. SAGE объединяет экраны, если совпадает их структура и мультимодальная модель считает их функционально одинаковыми. Поэтому в память попадает связная карта действий, а не набор почти повторяющихся снимков.
Старую траекторию проверяют перед каждым действием
На выборке из 176 задач в 20 приложениях только 44% траекторий не изменились после обновления. Остальные расходились со старой версией: появлялся или исчезал шаг, менялась точка входа, переименовывался элемент либо возникал отвлекающий переход.
Из этих случаев собрали учебные искажения. Чистую траекторию перефразируют, удаляют из неё промежуточный шаг, заменяют продолжение другой веткой, вставляют нерелевантное действие или целиком подставляют путь к чужой цели. Последние два варианта берут из того же графа приложения, поэтому ошибка выглядит правдоподобно, а не как случайный текст.
Перед действием модель должна выбрать один из трёх режимов: следовать приору, использовать его частично или игнорировать. Для этого она сопоставляет траекторию с целью, уже выполненными действиями и текущим экраном. При частичном совпадении модель также отмечает, каким участкам пути можно доверять.
Эту проверку обучают вместе с выбором следующего действия. SAGE использует донастройку LoRA, а решение о надёжности и команда интерфейсу выходят из одного декодера. Отдельная модель-оценщик или второй этап исполнения не нужны.
Метод проверяли на Qwen3-VL трёх размеров, MAI-UI и GELab-Zero. Обучение и перенос сравнивали на CUTG, CMGUI и ChiM-Nav, а выполнение целых задач — на MobileWorld, AndroidLab и AndroidWorld, на физических устройствах и в эмуляторах. SAGE превзошёл обычную донастройку в 28 из 30 сочетаний модели и направления переноса; при этом на AndroidWorld несовершенные приоры всё ещё ухудшали результат у обоих подходов.
Что меняется в планах продуктовой команды
Работа касается прежде всего систем, которые повторно используют накопленные траектории. Если агент действует только по текущему экрану и не извлекает прошлый опыт, SAGE не предлагает ему отдельного улучшения распознавания или планирования.
Для агента с памятью меняется сам контракт с базой знаний. Траектория должна описывать состояние до действия, смысл элемента и полученный результат, а не только координаты на старом экране. При извлечении её нельзя безусловно добавлять в запрос модели: сначала агенту нужен явный выбор между следованием, частичным использованием и отказом.
В план обучения стоит включить изменения, похожие на эксплуатационные: пропущенный шаг, новую ветку, переименованный элемент, рекламу и путь к другой цели. Такой набор проверяет не способность копировать демонстрацию, а умение заметить расхождение до ошибочного нажатия.
Результаты не означают, что память стала безопасной по умолчанию. Эксперименты охватывают Android-приложения и заданные типы искажений, а в одном из онлайн-бенчмарков найденные траектории по-прежнему вредили выполнению задач. Практический вывод уже применим: качество агента надо измерять отдельно с верным, частично устаревшим и ошибочным опытом.
Источники
Иллюстрация: рисунок из статьи «Learning Reliable GUI Agents under Imperfect Priors», Bo Han, Qianyi Wang, Shuai Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


