
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Предсказание следующего экрана не улучшило выбор действий GUI-агента, если кандидатов уже оценивала обученная ранжирующая модель. Хотя препринт George Washington University и AWS не рецензирован и все числа получили сами авторы, DAR повысил долю выполненных задач AndroidWorld на 5,8–16,4 процентного пункта относительно выбора по уверенности исходного агента. Для продукта это повод сначала проверить прямой оценщик действий, а не добавлять генерацию будущих экранов в контур принятия решений.
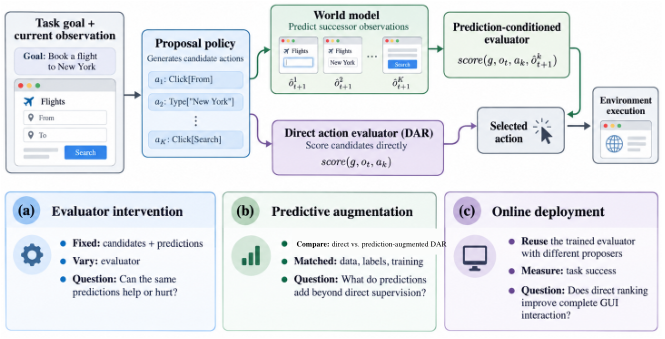
Обычная схема сначала предлагает несколько действий, затем модель мира интерфейса прогнозирует результат каждого, а отдельный оценщик выбирает лучший вариант. Авторы разделили эти компоненты: зафиксировали кандидатов и прогнозы, меняли способ оценки, а затем обучили Direct Action Ranking, или DAR. Эта модель получает цель, текущий экран и описание действия, после чего ранжирует кандидатов без генерации будущего состояния.
При одинаковых кандидатах, разметке, архитектуре и обучении прогноз следующего экрана изменил AUROC менее чем на 0,001. Эта метрика показывает, насколько хорошо модель ставит подходящие действия выше неподходящих. Само обучение на эталонных действиях прибавило к AUROC 0,17–0,18 относительно уверенности исходного агента, поэтому измеренный сигнал пришёл почти целиком от прямого оценщика.
В полном взаимодействии DAR без дообучения ранжировал действия трёх разных моделей на 116 задачах AndroidWorld. Он превзошёл схемы с прогнозом экрана на 4,3–11,5 процентного пункта; разница статистически значима во всех парных сравнениях. На 14 незнакомых корейскоязычных приложениях DAR также оказался лучшим, тогда как каждый вариант с прогнозом уступил обычной уверенности исходного агента.
Работа охватывает одношаговый выбор действий. Офлайн-проверку проводили на AndroidControl, мобильное взаимодействие — на AndroidWorld, а для веб-задач обучали отдельный оценщик и тестировали его на MiniWob. Там прямое ранжирование не победило во всех конфигурациях: результат зависел от модели, которая предлагала действия. Поэтому вывод касается прежде всего мобильных агентов и не доказывает, что прогнозы экранов бесполезны для длинного планирования или обучения.
Источники
Иллюстрация: рисунок из статьи «Beyond Next-Screen Prediction: The Decision Value of GUI World Models», Sizhe Tang, Hanhan Zhou, Jeffrey Svajlenko и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


