
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Диффузионные трансформеры удалось перевести на четырёхбитные веса и активации с меньшей потерей качества, не увеличивая вспомогательную точную ветку. В работе The University of Hong Kong и Huawei, которая не прошла рецензирование и содержит замеры самих авторов, H-SVDQuant с рангом 4 обошёл SVDQuant с рангом 32 на SANA и FLUX. Командам, которые уже рассматривают SVDQuant, стоит проверить совместную калибровку до того, как компенсировать ошибку большим рангом.
Почему точная ветка не устраняет всю ошибку
Квантование после обучения уменьшает точность весов и промежуточных активаций без повторного обучения модели. Режим W4A4 хранит и те и другие в четырёх битах, поэтому снижает объём вычислений и обмен данными, но добавляет ошибку почти в каждый линейный слой.
Для диффузионных трансформеров эта ошибка особенно заметна: модель многократно применяет одни и те же типы преобразований, пока очищает изображение от шума. Небольшое искажение может накапливаться по ходу генерации.
SVDQuant отделяет часть матрицы весов в точную низкоранговую ветку, а оставшийся массив переводит в четыре бита. Ранг здесь показывает, сколько независимых направлений может сохранить такая ветка. Чем он выше, тем больше сложной ошибки можно вынести из квантованного остатка, но тем тяжелее дополнительное вычисление.
Проблема возникает из-за последовательной настройки. Сначала метод выбирает направления для точной ветки, затем отдельно квантирует остаток. Квантовщик при этом может тратить доступные значения на ошибку, которую точная ветка всё равно исправит, а искажения активаций остаются за пределами основной цели оптимизации.
Как дефляция Гессиана разделяет работу веток
H-SVDQuant рассматривает точную ветку, квантованный остаток и ошибку активаций как одну задачу калибровки. Для каждого линейного слоя метод собирает статистику входных активаций и оценивает, какие изменения весов сильнее повлияют на выход слоя.
Роль Гессиана играет матрица этих статистик. Она задаёт геометрию ошибки: одинаковое отклонение веса может быть почти безвредным в одном направлении входных данных и заметным в другом.
Сначала H-SVDQuant выбирает защищённое подпространство не по величине весов самой по себе, а с учётом калибровочных активаций. Затем метод аналитически исключает выходной множитель точной ветки из задачи. Получается дефлированный Гессиан, который присваивает нулевой вес ошибкам внутри уже защищённого подпространства.
После этого квантователь настраивает остаток только для направлений, которые точная ветка не покрывает. Выходной множитель ветки пересчитывается по готовому остатку в закрытой форме, без отдельного перебора. Две части слоя перестают конкурировать за исправление одной и той же ошибки.
Дополнительный член цели оценивает шум от квантования активаций. Он меняет и меру ошибки, и матрицу, которую должен приблизить квантованный остаток. В экспериментах умеренный вес этого члена помогал, но лучший уровень зависел от модели, поэтому его нельзя переносить между архитектурами без калибровки.
Перед квантованием метод также перераспределяет диапазоны между весами и активациями с помощью диагонального масштабирования. Полноточное преобразование слоя не меняется, но выбросы становятся удобнее для низкой разрядности. Масштабы вычисляются формулой вместо перебора по сетке.
Что меняется в плане квантования
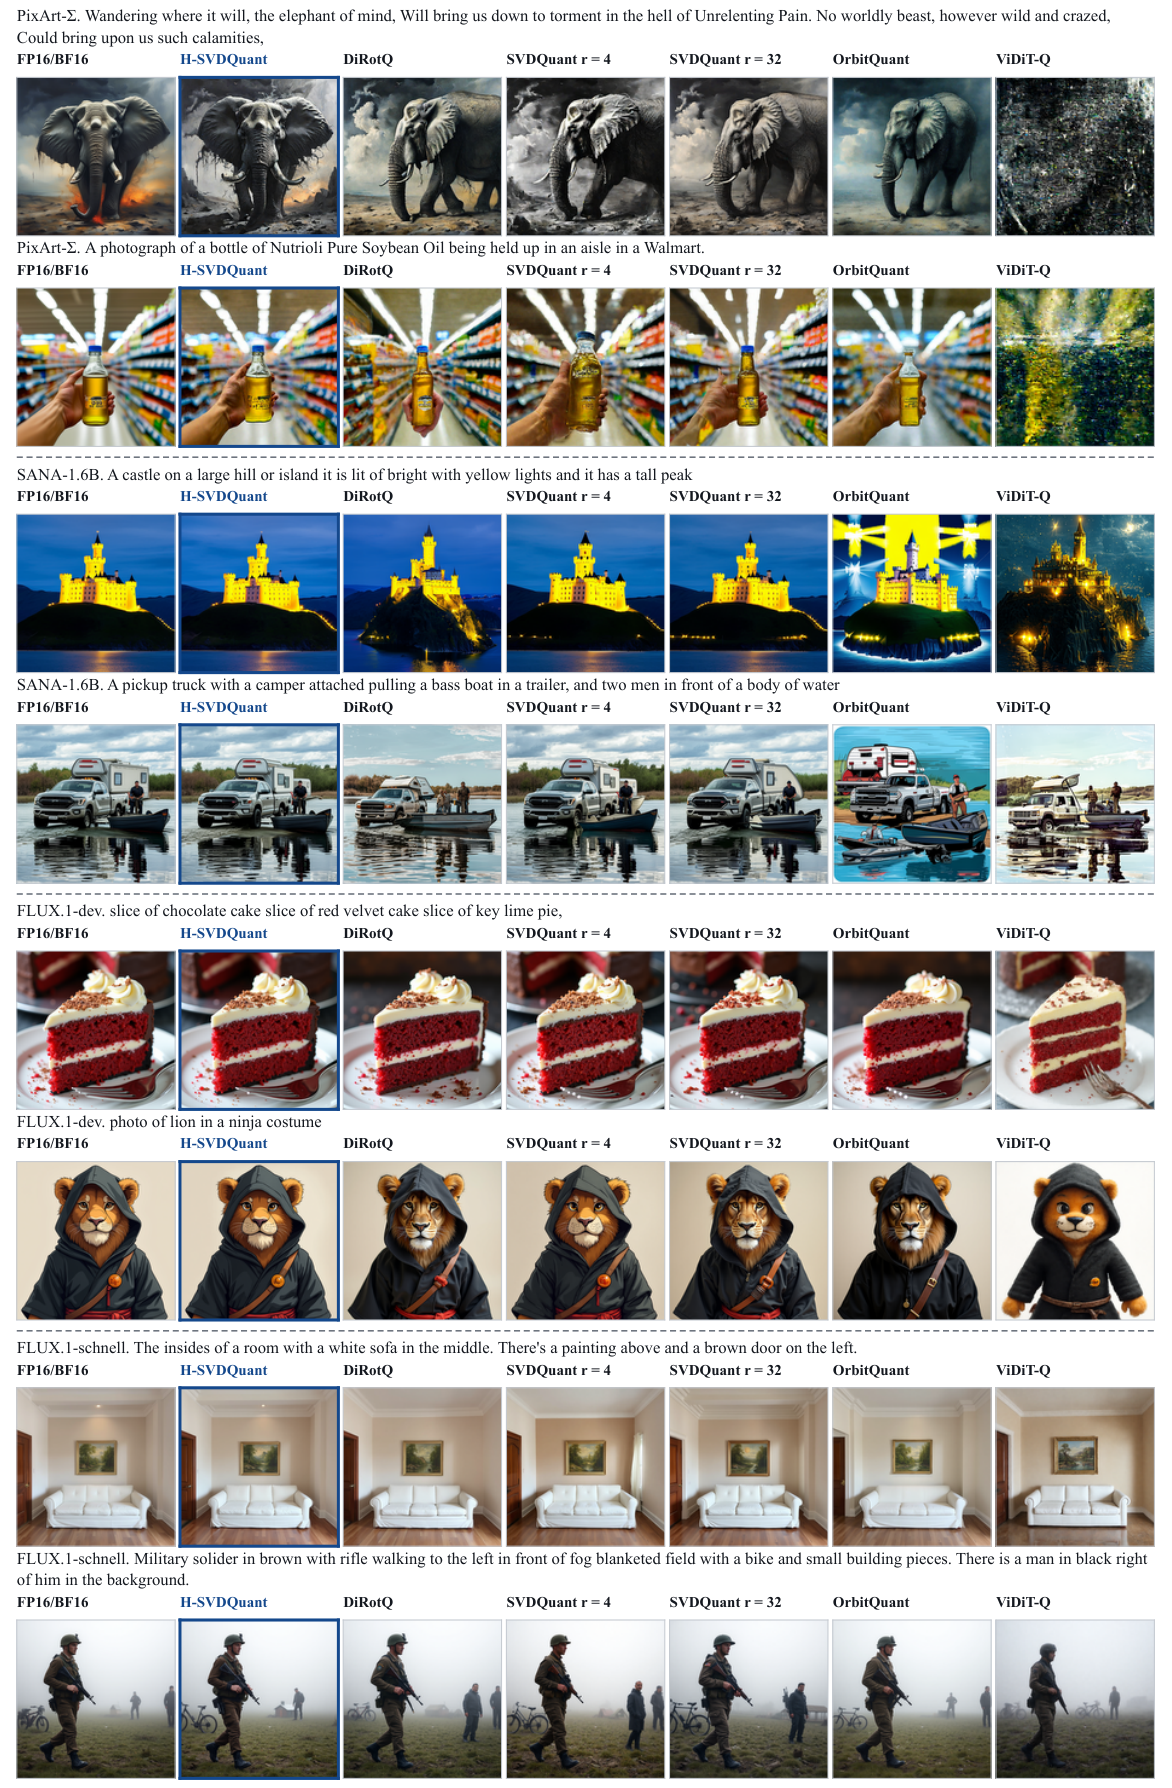
Метод проверили на пяти диффузионных основах: PixArt-Σ, SANA-1.6B, двух вариантах FLUX.1 и Qwen-Image. Квантованные результаты сопоставляли с полноточной моделью на одинаковых запросах, начальном шуме и шагах генерации. Для переноса за пределы генерации изображений использовали одну языковую модель Qwen3-8B.
На всех диффузионных основах H-SVDQuant лучше сопоставимого SVDQuant по PSNR и LPIPS. Первая метрика показывает численную близость к изображению полноточной модели, вторая оценивает различия в воспринимаемых признаках. Максимальный прирост PSNR составил 1,61 дБ, а офлайн-калибровка занимала до 6,25 раза меньше времени, чем у SVDQuant с крупной точной веткой.
На Qwen3-8B точность MMLU выросла с 61,50% до 68,17% относительно SVDQuant с крупной веткой. Это подтверждает, что идея работает не только на диффузионной траектории, но одного языкового эксперимента недостаточно, чтобы считать результат общим для LLM.
Работа меняет порядок проверки решений. Если базовый план предполагает W4A4 и увеличение ранга SVDQuant ради качества, сначала имеет смысл протестировать совместную калибровку: она может сохранить меньшую точную ветку. Если команда ещё выбирает сам подход к квантованию, H-SVDQuant пока остаётся кандидатом для собственного сравнения, а не готовым вариантом по умолчанию.
Замеры показывают качество реконструкции и время офлайн-калибровки, но не задержку готового сервиса. H-SVDQuant также не стал лидером по каждой метрике качества: на отдельных моделях DiRotQ давал лучший результат. Решение о внедрении поэтому должно опираться на целевой ускоритель, реальные запросы и нужный баланс между сходством с исходной моделью и визуальным качеством.
Источники
Иллюстрация: рисунок из статьи «Deflating the Hessian: Rank-4 W4A4 Quantization for Multimodal Diffusion Transformers», Shiwen Wang, Pengxiang Zhao, Xiaoming Yuan, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


