
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили сначала собирать нужные факты из длинного документа, связывать их между собой и только затем отвечать. Работу Peking University, Baidu и Tsinghua University пока не рецензировали, а все числа получили сами авторы: H2S-14B опередила Qwen3.8-27B на 10,17 пункта при одинаковом лимите ответа. Для команд это аргумент в пользу отдельного промежуточного представления между исходным контекстом и ответом, а не просто более длинной цепочки рассуждений.
Модель выделяет факты и собирает из них рабочее резюме
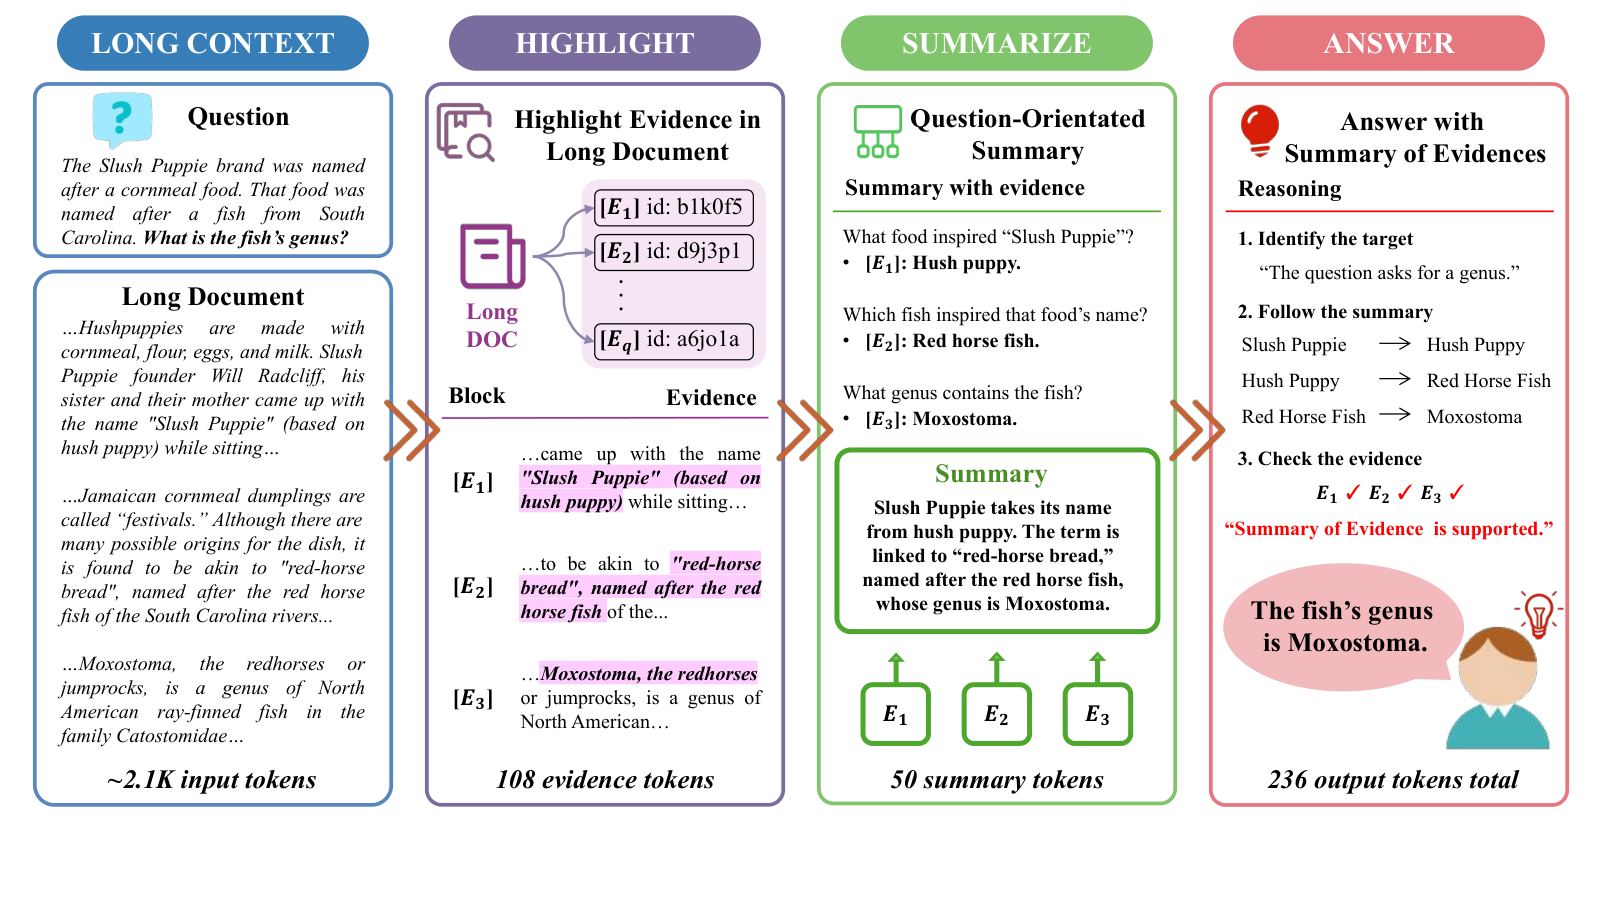
Highlight-Then-Summarize делит ответ на три последовательных этапа. Сначала модель выделяет относящиеся к вопросу фрагменты и сохраняет идентификаторы исходных блоков. Затем превращает разрозненные фрагменты в краткое резюме под конкретный вопрос. После этого строит окончательный ответ.
Резюме здесь не пересказывает документ целиком. Оно связывает факты, которые могут находиться в разных разделах: сопоставляет сущности, восстанавливает порядок событий, собирает числовые условия или соединяет определение API с реализацией и конфигурацией. При этом исходный документ остаётся в контексте модели, поэтому H2S организует информацию, а не отбрасывает её.
Все этапы выполняет одна модель в одной последовательности генерации. Выделенные фрагменты дают проверяемую связь с источником, а резюме превращает их в состояние, пригодное для рассуждения. Это отличает подход от простого поиска: найти несколько подходящих отрывков недостаточно, если модель не понимает, как они связаны.
Для обучения собрали H2S-Dataset из 6 647 примеров со средней длиной контекста 43,9 тысячи токенов. Каждый пример содержит документ, вопрос, привязанные к источнику доказательства, краткое резюме и ответ. При подготовке данных вопросы разбивали на отдельные информационные потребности, для каждой находили подтверждение, удаляли повторы и проверяли, можно ли получить ответ только из собранного резюме.
Промежуточную работу оценивают отдельно от ответа
Обычное обучение по итоговой награде сообщает модели только то, верен ли последний ответ. H2S-RL дополнительно проверяет процесс: существуют ли указанные блоки и фрагменты в документе, покрывают ли они эталонные доказательства, совпадает ли резюме с целевым и соблюдена ли структура «доказательства — резюме — ответ».
Награда рассчитывается программно, без модели-оценщика. Качество доказательств и резюме объединяют так, чтобы хороший результат на одном этапе не скрывал провал другого. Если модель нашла правильные фрагменты, но плохо связала их, или написала гладкое резюме без опоры на источник, общая награда остаётся низкой.
Обучение начинали с полного дообучения Qwen2.5-Instruct, затем применяли GRPO — метод обучения с подкреплением, который сравнивает несколько ответов на один запрос. Длину контекста увеличивали постепенно. Поиск использовали при подготовке обучающих примеров, но во время проверки H2S получала документ целиком и не обращалась к отдельному внешнему поисковику.
Резюме дало больший вклад, чем само выделение фрагментов
Модели проверяли на задачах с числовыми расчётами, несколькими документами, цитированием, точным поиском, сбором распределённых фактов, общим пониманием длинного контекста и суммаризацией. Все участники получали одинаковые запросы и документы с входным лимитом 128 тысяч токенов и выходным лимитом 4 тысячи токенов.
Удаление промежуточного резюме снизило средний результат H2S-14B на 8,47 пункта. Удаление выделенных доказательств стоило 4,25 пункта. Значит, основной эффект дал не только поиск релевантных мест, но и явная сборка этих мест в компактную структуру перед ответом.
Сравнение охватывает две обученные модели и набор открытых базовых моделей. Оно не показывает универсального превосходства над любым длинноконтекстным решением: результаты относятся к выбранным задачам, метрикам и общей схеме подачи документов.
Когда подход меняет архитектурный план
Работа меняет планы команд, которые дообучают собственную модель для анализа документов, истории диалогов или репозиториев. В обучающих данных стоит хранить не только вопрос и правильный ответ, но и два наблюдаемых промежуточных результата: подтверждённые источником фрагменты и краткое представление фактов под задачу.
Это также меняет распределение бюджета генерации. При расширении лимита ответа до 16 тысяч токенов результат H2S-14B вырос лишь на 0,96 пункта. Модель получила основную пользу от организации доказательств, а не от возможности рассуждать в четыре раза дольше.
Перестраивать систему целиком стоит не во всех случаях. Эксперимент относится к полному дообучению моделей, а сам подход требует эталонных доказательств и резюме для процессной награды. Он также хуже подходит задачам, где ответ должен равномерно учитывать почти весь документ: сжатие под конкретный вопрос полезнее, когда нужные факты редки и разбросаны.
Практический вывод для собственного конвейера — сделать переход от найденных фрагментов к ответу отдельным обучаемым этапом. Такой этап можно проверять независимо: подтверждены ли факты источником, покрыт ли вопрос и сохранились ли связи, необходимые для окончательного вывода.
Источники
Иллюстрация: рисунок из статьи «Highlight-Then-Summarize: Learning to Compress Evidence for Long-Context Understanding», Zhaoyuan Xia (Peking University, Baidu Inc), Qinghongbing Xie (Tsinghua University) и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


