
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Небольшого агента научили перенимать у большой модели только то, чего не даёт общая программная обвязка. В препринте KAIST AI, который ещё не рецензировали, авторы сами получили все числа и показали, что HAD успешнее обычной дистилляции на состояниях ученика. Для команд это меняет схему обучения: состояние среды можно оставить снаружи, а модель учить реагировать на него.
Как отделили возможности модели от обвязки
Агент работает не сам по себе. Его окружает программная обвязка: она собирает контекст, показывает доступные инструменты, хранит состояние среды и отмечает бесполезные повторы. При замене большой модели на небольшую эта часть системы обычно остаётся прежней.
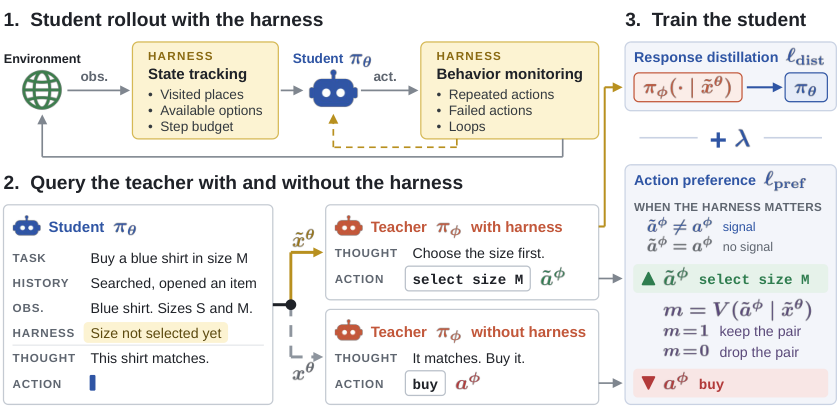
Обычная дистилляция на состояниях ученика устроена так: небольшой агент проходит задачу, а модель-учитель показывает желаемый ответ в каждой посещённой точке. Если обе модели видят одну обвязку, обучение копирует весь ответ учителя, но не выделяет решения, которые изменились именно благодаря внешней информации.
HAD запрашивает одну и ту же модель-учителя с обвязкой и без неё. Из истории убирают только добавленные обвязкой строки, но сохраняют уже совершённые действия и полученные наблюдения. Если учитель выбирает разные действия, ученик получает явный сигнал: сведения об окружении должны были повлиять на следующий шаг.
Метод сравнивает только действия, а не полные рассуждения. Оценку считают после собственного рассуждения ученика, потому что при работе агент принимает решение именно в таком контексте. Полный ответ учителя всё равно используют для обычной дистилляции, поэтому HAD дополняет её, а не заменяет.
Обвязка также проверяет предпочтительное действие. Если оно противоречит известному состоянию — например, требует предмет, которого нет в инвентаре, — такую пару исключают из сравнения. Проверка не доказывает, что оставшееся действие верно, но отсеивает цели, которые явно расходятся с наблюдаемыми фактами.
Для обучения не нужны награда за задачу, метка успешного эпизода или сведения из будущих шагов. Обвязка служит источником контраста и проверкой допустимости, но не выбирает действие за агента.
Метод проверяли в текстовых средах ALFWorld, WebShop и ScienceWorld. Ученики содержали до 2 млрд параметров, учителя — до 30 млрд; эксперименты охватили семейства Qwen3 и Gemma-4. Одна и та же вручную заданная обвязка работала при обучении и оценке: она отслеживала доступные действия, местоположение, инвентарь, историю посещений, запас шагов и признаки зацикливания.
Контраст действий помогает выйти из бесполезного цикла
На ALFWorld HAD довёл долю успешно завершённых задач до 57,4% против 43,5% у дистилляции полных ответов с той же обвязкой. Простое добавление внешней информации в обучающие состояния почти не улучшило результат: агент видел подсказку, но не обязательно менял из-за неё действие.
Согласованность действий с записями обвязки выросла с 73,1% до 81,0%. Эта метрика показывает, как часто агент действует в соответствии с известным состоянием среды, а не игнорирует сведения о посещённых местах, предметах и неудачных шагах.
Разница проявилась и после зацикливания: HAD вышел из 59,7% отмеченных обвязкой остановок, тогда как базовые методы не дали явного улучшения относительно необученного ученика. Модель не просто стала чаще повторять ответ учителя, а научилась использовать сигнал о том, что прежняя стратегия перестала продвигать задачу.
Удаление любого элемента ухудшало результат. Без контраста между действиями с обвязкой и без неё ученик слабее использовал внешние сведения, а без проверки допустимости чаще перенимал ошибки учителя. Сравнение полных ответов тоже работало хуже: длинные рассуждения заслоняли короткий, но важный сигнал в действии.
Эффект сохранился при переходе с Qwen3 на Gemma-4: HAD снова оказался лучшим среди обученных учеников. Это не доказывает перенос на любые модели, но показывает, что результат не привязан к одному семейству.
Когда HAD меняет план разработки агента
Подход стоит учитывать, если обвязка останется частью продукта после дистилляции. Тогда незачем заставлять небольшую модель запоминать текущее состояние, историю посещений или список доступных действий. Полезнее учить её распознавать моменты, когда эти сведения требуют сменить план.
Цена такого сигнала — два обращения к учителю в каждом состоянии: с обвязкой и без неё. Авторы отдельно увеличили бюджет базовых методов, но дополнительные запросы сами по себе не закрыли разрыв. Значение имеет не объём ответов учителя, а их противопоставление.
Из работы следует и практическое разделение ответственности. Обвязка должна выдавать проверяемые факты и отмечать сбои, а модель — выбирать действие на их основе. Жёстко блокировать нежелательные действия оказалось менее полезно, чем передавать состояние агенту и учить его учитывать.
Перестраивать обучение крупных производственных агентов только по этой работе рано. Эксперименты ограничены небольшими моделями, текстовыми средами и вручную созданной обвязкой; программных агентов с вызовом инструментов не проверяли. Кроме того, HAD не устраняет зависимость от внешнего состояния: после обучения агент по-прежнему особенно нуждался в сведениях о местоположении, посещениях и инвентаре.
Для пилота достаточно изменить сбор обучающих данных: сохранять состояния, которые посещает ученик, дважды запрашивать учителя и проверять выбранное действие по фактам из обвязки. Если система уже умеет фиксировать зацикливание и противоречия, HAD использует эти записи без отдельной функции награды.
Источники
Иллюстрация: рисунок из статьи «Harness-Aware Distillation for Small Language Model Agents», Moonseok Choi, Taehong Moon, Giung Nam и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


