
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
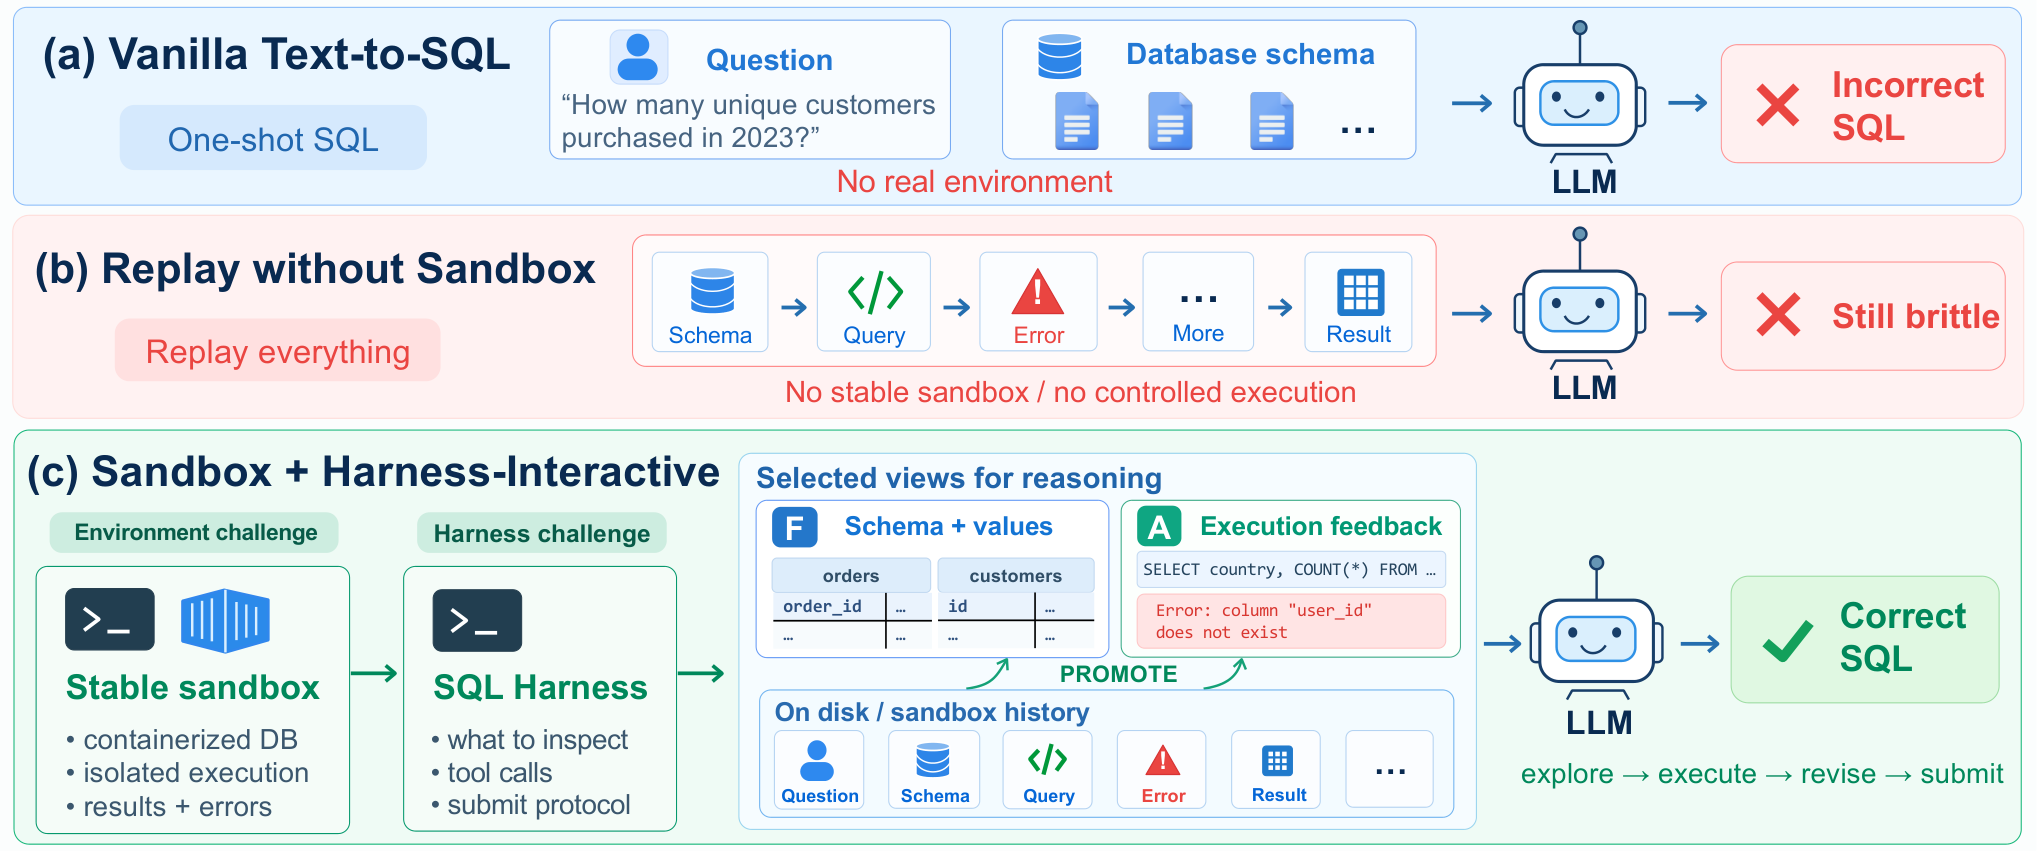
SQL-агентов научили не только писать итоговый запрос, но и искать таблицы, проверять гипотезы, разбирать ошибки базы и исправлять SQL. В нерецензированном препринте, где все числа получили сами авторы, HarnessSQL поднял точность исполнения Qwen3-8B с 15,5% до 45,2%. Для продуктовой команды это меняет единицу обучения: сохранять нужно не пары «вопрос — запрос», а полный рабочий цикл агента в том интерфейсе, где он будет запущен.
Почему правильного SQL недостаточно
Обычную модель перевода текста в SQL учат на статических примерах. Она получает вопрос, описание схемы и должна сразу выдать запрос. В реальной системе между вопросом и ответом появляется контур исполнения (harness): он открывает модели инструменты, возвращает результаты запросов и ошибки, ограничивает время работы и определяет момент завершения.
Из-за этого модель решает уже другую задачу. Она не всегда знает, в какой таблице лежат нужные данные, как связаны ключи и какие значения встречаются в столбцах. Сначала агент изучает схему, затем запускает пробный запрос, получает ошибку или пустой результат, меняет предположение и только после этого отправляет итоговый SQL.
Если обучение показывает лишь правильный финал, модель не узнаёт, когда вызывать инструмент и как реагировать на ответ базы. Добавление инструментов после обучения не устраняет разрыв: агент видит состояния, которых не встречал в учебных данных, и должен сам освоить правила интерфейса.
HarnessSQL рассматривает агентом всю связку из модели, базы и протокола взаимодействия. Успех означает не текстовое совпадение с эталоном, а одинаковый результат исполнения. Отдельно проверяется соблюдение протокола: запросы должны оставаться доступными только для чтения, агент не должен зацикливаться на одинаковых вызовах и обязан завершить работу предусмотренной командой.
Как воспроизвели рабочий цикл при обучении
Для каждой задачи создаётся изолированная исполняемая база со скрытым эталоном результата. Генератор сначала строит рабочий SQL, а затем превращает его в вопрос на естественном языке. Заготовки отсеивают, если запрос содержит синтаксическую ошибку, возвращает пустой результат, использует бессодержательное соединение таблиц или плохо различает верные и неверные решения.
Агенту оставили четыре действия: получить список таблиц через sql_list_tables, изучить схему и примеры значений через sql_schema, выполнить пробный запрос через sql_exec и отправить ответ через sql_submit. Оболочка обрезает слишком длинные результаты, напоминает о повторных вызовах и сжимает контекст в длинных эпизодах. Командная строка, файловая система и среда запуска кода отключены, поэтому учебная траектория соответствует задаче SQL-агента, а не универсального программного помощника.
На первом этапе экспертная модель проходит задачи внутри этого интерфейса. В набор попадают только траектории, которые завершились правильным результатом и не нарушили протокол: получилось 2512 эпизодов из 79 баз. При обучении с учителем (SFT) студент воспроизводит все решения и вызовы инструментов, но ответы самой среды не входят в целевую функцию — модель учится действовать с учётом этих ответов, а не генерировать их.
Затем обучение с подкреплением продолжает работу в той же среде. Скрытый проверяющий модуль выдаёт награду только за корректный результат и допустимую траекторию. Это позволяет модели находить собственные способы исследования и исправления ошибок, не ограничиваясь маршрутами экспертной модели.
Рабочий контур становится частью модели
На Spider 2.0-SQLite точность исполнения Qwen3-8B выросла с 15,5% до 45,2%, а Qwen3-14B — с 22,2% до 54,8%. Улучшение перенеслось на BIRD-Interact Mini и LiveSQLBench Base-Lite, хотя там отличаются базы и протокол взаимодействия. Перенос не означает независимости от оболочки: работа показывает, что модель усваивает общую последовательность исследования и исправления, когда её учат на реальном исполнении.
Для команды, которая строит SQL-агента, интерфейс инструментов теперь стоит фиксировать до сбора учебных данных. Названия действий, формат ошибок, обрезка результатов, правила завершения и предел контекста влияют на поведение модели. Если эти детали поменять после дообучения, часть собранных траекторий перестанет описывать рабочую среду.
Практический контур выглядит так: изолировать базы, записывать полные эпизоды, проверять итог исполнением и отбрасывать нарушения протокола. Сначала модель получает устойчивый сценарий работы из проверенных демонстраций, затем улучшает его по награде за исполнение. Учить только финальный SQL имеет смысл для однократной генерации, но не для агента, который должен исследовать незнакомую схему и восстанавливаться после ошибок.
Границы результатов задаёт сам эксперимент: проверяли две компактные модели преимущественно на SQLite и трёх наборах задач. Другие диалекты меняют синтаксис, команды метаданных, клиенты и ответы среды, поэтому для PostgreSQL, Snowflake или BigQuery потребуется отдельный исполняемый контур и новые проверенные траектории.
Источники
Иллюстрация: рисунок из статьи «HarnessSQL: Harness-Native Training for SQL Agents in Realistic Database Environments», Haolin Yang, Jipeng Zhang, Jian Xie и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


