
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили сокращать неподтверждённые утверждения, не превращая ответы в короткие и осторожные отписки. В препринте с участием Huawei, который не проходил рецензирование и приводит замеры самих авторов, доля ответов с галлюцинациями на MultiHopRAG снизилась с 3,29% до 1,02%. Работа предлагает не искать постоянный баланс между достоверностью и стилем, а включать награду за качество текста только после проверки фактов.
Оценщик ищет ошибку и указывает её границы
В основе HARPO лежит HA-GRM — генеративная модель-оценщик. Она решает три задачи: определяет, содержит ли весь ответ неподтверждённые сведения, отмечает конкретные ошибочные фрагменты и сравнивает два варианта текста по полезности, уместности, краткости, полноте и выразительности.
Оценщик обучали на Qwen3-4B с помощью GRPO. Для проверки достоверности он получал правильную метку ответа и размеченные границы галлюцинаций. За верный вывод начислялась награда, а точное выделение ошибочного фрагмента увеличивало её. Для оценки текста модель выбирала лучший вариант из пары и получала награду за совпадение с человеческим предпочтением.
Разметка фрагментов оказалась полезнее одной бинарной метки. На RAGTruth итоговая F1 выросла на 11,71 процентного пункта относительно обучения с учителем. F1 объединяет точность и полноту: высокая оценка требует не только находить большинство ошибок, но и не объявлять ошибочными корректные ответы.
Совместное обучение всё же оставило конфликт между задачами. Когда к поиску галлюцинаций добавили предпочтения по качеству текста, оценщик лучше выбирал удачный ответ, но немного хуже распознавал галлюцинации. HARPO не устраняет этот конфликт внутри оценщика, а меняет способ, которым его сигналы влияют на основную модель.
Награда за стиль открывается после проверки фактов
Обычная схема складывает награду за достоверность и награду за качество с постоянными весами. Модель может компенсировать неподтверждённое утверждение подробным и убедительным изложением. Тогда формально высокий общий балл не означает, что ответ опирается на источник.
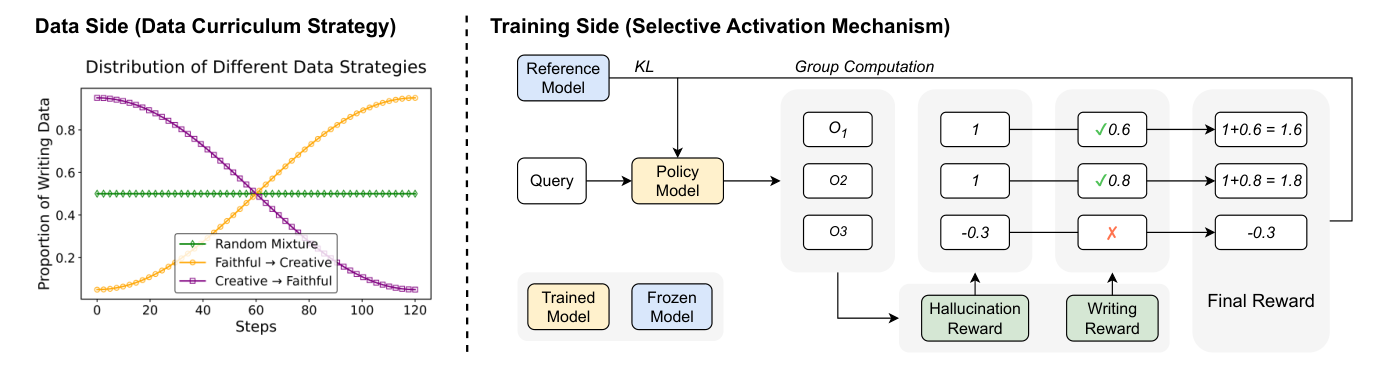
HARPO ставит между двумя наградами условный шлюз. HA-GRM сначала ищет неподтверждённые фрагменты. Если находит их, модель получает штраф, который зависит от доли ошибочного текста, а награда за стиль не учитывается. Если оценщик считает ответ достоверным, к награде добавляется оценка качества письма.
Это не гарантирует истинность: пропущенная оценщиком галлюцинация всё равно откроет награду за стиль. Но схема задаёт понятный приоритет — выразительность нельзя использовать как компенсацию за нарушение проверяемого ограничения.
Второй элемент HARPO — расписание обучающих данных. В начале преобладают задания на творческое письмо, затем обучение плавно смещается к пересказу источников и ответам на вопросы по контексту. Небольшая доля творческих заданий сохраняется до конца, чтобы модель не забыла навыки письма после перехода к строгой проверке.
На Arena-Hard-v2.0 оценка творческого письма выросла с 16,95% до 27,54%. Однако сравнение с линейным смешиванием наград не дало победы по всем показателям: HARPO лучше справился с достоверностью пересказа и общими заданиями, но немного уступил в многошаговых вопросах и творческом письме. Условный шлюз меняет компромисс, а не отменяет его.
Командам стоит заимствовать приоритеты, а не весь конвейер
Работа меняет планы команд, которые дообучают модели сразу под проверяемые ограничения и субъективное качество. Вместо долгого подбора коэффициентов для общей награды можно формализовать порядок: сначала обязательное условие, затем оптимизация предпочтений. Такой подход подходит не только для галлюцинаций, но и для формата ответа, соблюдения политики или наличия обязательных данных — если проверку можно превратить в достаточно надёжный сигнал.
HARPO требует отдельного оценщика, размеченных границ ошибочных фрагментов и генерации нескольких ответов во время обучения. Авторы отдельно отмечают, что такая разметка дороже бинарных меток, а генеративный оценщик увеличивает вычислительные затраты по сравнению с классификатором.
Проверка охватила Qwen2.5 и Qwen3 размером от 1,7 до 8 млрд параметров, а задания относились к пересказу, ответам по контексту и творческому письму. Все эксперименты запускали по одному разу. Доля галлюцинаций также измерялась тем же HA-GRM, который выдавал награду при обучении, поэтому перед внедрением понадобится независимый оценщик на данных продукта.
Практический вывод — не переносить HARPO целиком, а сначала проверить условную схему наград на одном жёстком ограничении. Если независимая проверка подтвердит, что модель перестала обменивать корректность на убедительный стиль, тогда оправданы собственный оценщик, разметка фрагментов и расписание данных.
Источники
Иллюстрация: рисунок из статьи «HARPO: Hallucination-Aware Reinforcement Learning for Faithful and Creative Language Generation», Tiezheng Yu, Yuxin Jiang, Jinpeng Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


