
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Разреженное внимание научились подстраивать под то, как отдельные головы модели ищут связи в контексте. Хотя работа University of Houston и University of Oklahoma не прошла рецензирование, её авторы сами получили приведённые числа: HASA ускорила расчёт внимания до 14,07 раза относительно плотного варианта. Метод можно применить к готовой модели без дополнительного обучения, если команда контролирует её среду выполнения.
Почему всем головам не подходит одно разрежение
Плотное внимание сопоставляет каждый новый запрос со всеми доступными ключами в контексте. С ростом последовательности увеличиваются вычисления и обмен данными с кэшем ключей и значений. Разреженные методы сокращают работу: сначала находят потенциально полезные участки, затем рассчитывают точное внимание только для них.
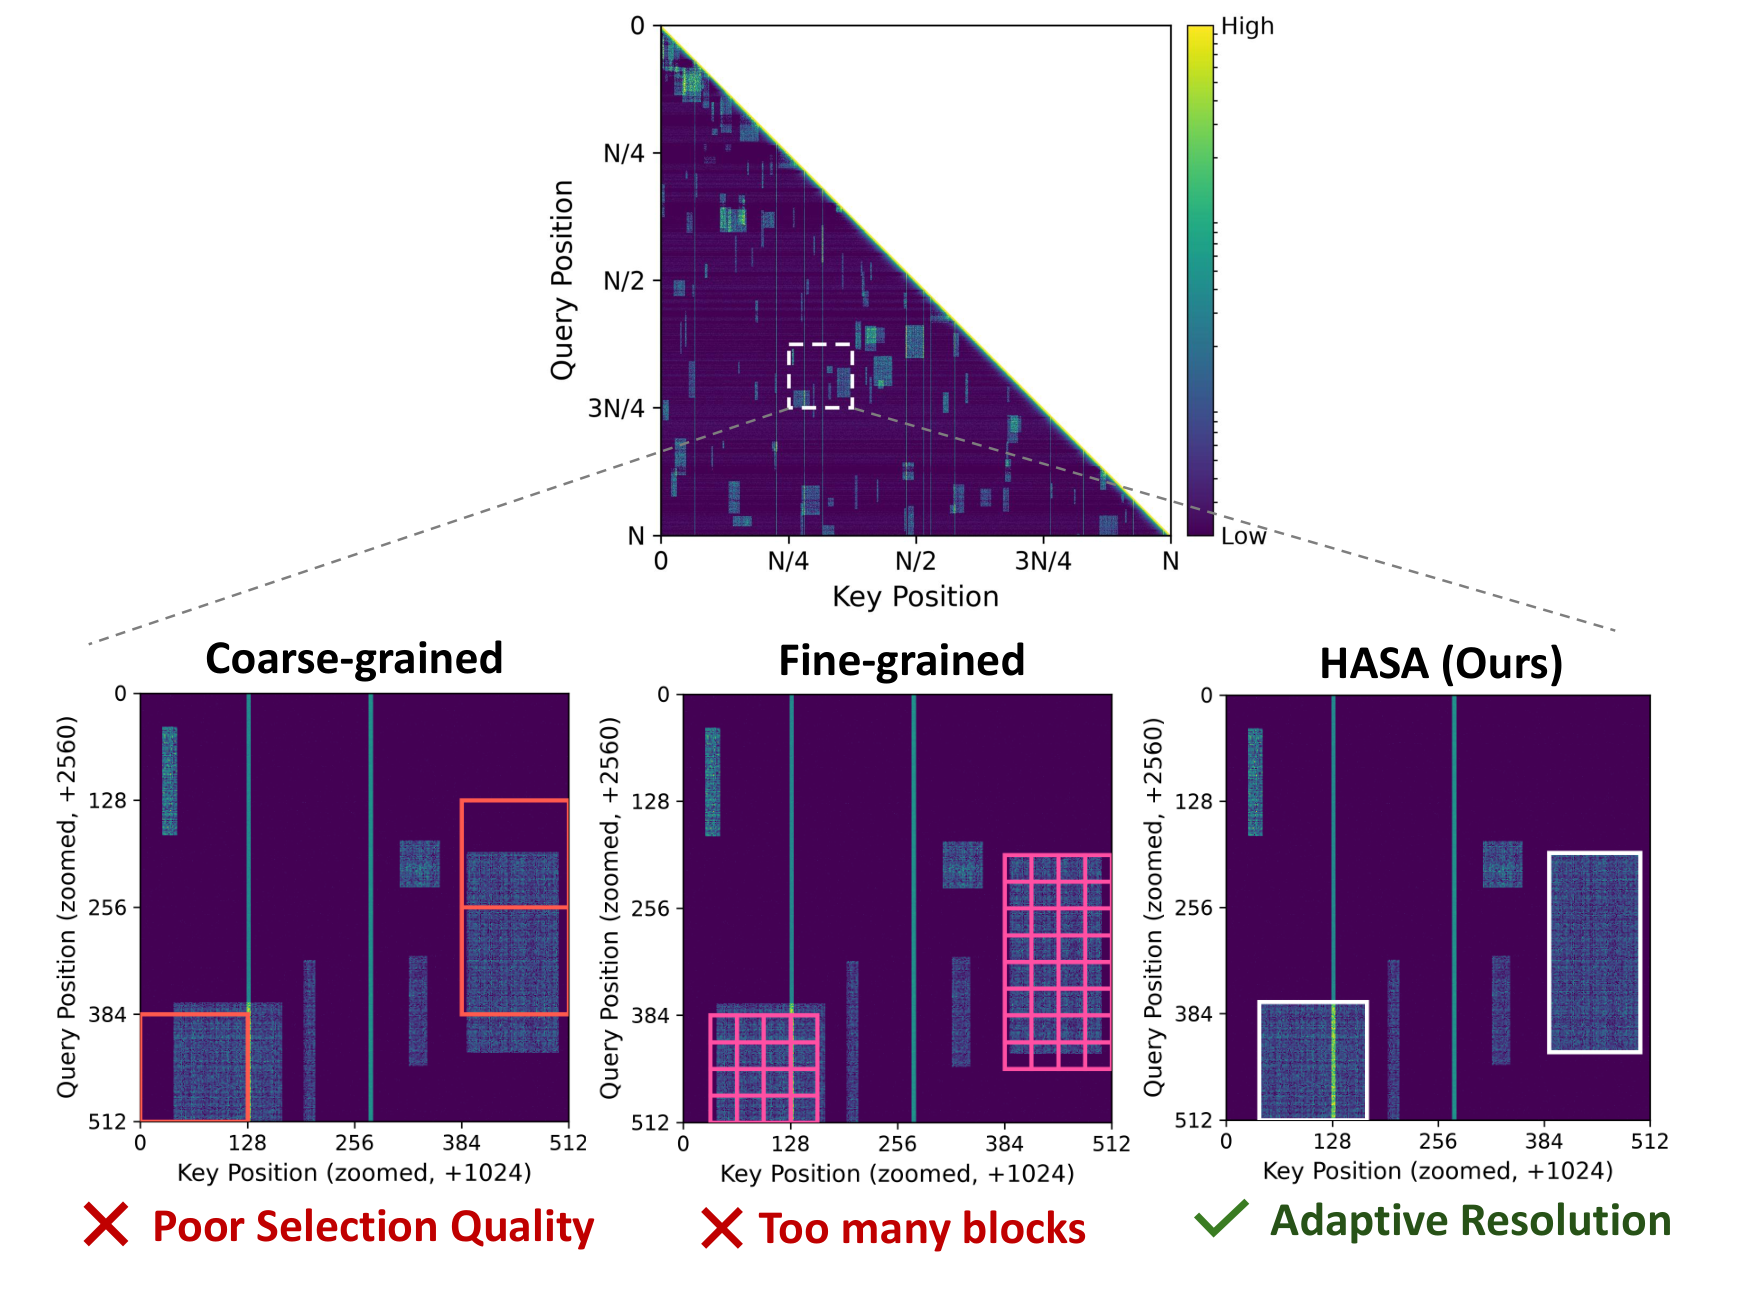
Такой поиск сам требует ресурсов. Если делить контекст на крупные блоки, полезные и бесполезные токены попадают в одну область. Если использовать мелкие блоки, модель точнее локализует нужный фрагмент, но должна оценить больше кандидатов.
HASA исходит из того, что подходящий масштаб зависит от головы внимания. Одна голова реагирует на небольшое число направлений в скрытых представлениях, другой нужна более подробная картина. Поэтому общий размер блока и одинаковая размерность поиска заставляют часть голов работать либо слишком грубо, либо с лишними вычислениями.
Для каждой головы метод заранее объединяет матрицы преобразования запросов и ключей в один оператор. Затем сингулярное разложение показывает, по каким направлениям этот оператор реагирует сильнее. Концентрированный спектр позволяет оставить меньше направлений, а равномерный требует сохранить больше. Число сохранённых направлений авторы ограничивают также допустимой ошибкой усечения.
Этот анализ выполняется один раз по весам модели. Во время вывода HASA переводит запросы и ключи в полученное компактное пространство, но использует его только для выбора контекста. Финальное внимание рассчитывается по исходным полноразмерным ключам и значениям.
Контекст тоже делится по-разному для каждой головы. Метод объединяет соседние области, если их компактные представления направлены сходным образом, и оставляет неоднородные области раздельными. Каждый получившийся участок описывают средним представлением и мерой разброса: среднее отражает типичный отклик, а разброс не даёт скрыть отдельный важный токен.
Адаптация сохранила больше полезного контекста
HASA проверяли на вариантах Ministral и Qwen3 с 8 млрд параметров. В эксперименты вошли RULER-32K и LongBench-Pro, несколько ограничений на объём доступного KV-кэша, плотное внимание и разреженные методы Quest, H2O, InfLLM и UNIQUE. Максимальная длина проверенного контекста составляла 32K токенов.
При одинаковом бюджете KV-кэша HASA сохранила 88,1% массы плотного внимания. Вариант с общей размерностью для всех голов и фиксированными блоками сохранил 80,7%. Разница показывает, что выигрыш даёт не только разрежение само по себе, но и выбор его масштаба.
По точности HASA обошла UNIQUE на RULER максимум на 3,47 пункта; на LongBench-Pro преимущество оказалось меньше. Относительно UNIQUE расчёт внимания ускорился до 1,32 раза. Это существеннее для практической оценки, чем сравнение только с плотным вниманием: UNIQUE уже сокращает число обращений к контексту.
Проверка охватывает две модели сходного размера и задачи на длинный контекст. Метод описывает голову через постоянную структуру её весов и поэтому не учитывает всю чувствительность во время выполнения: нормализацию softmax, представления значений и последующие вычисления модели. На других архитектурах баланс между точностью выбора и затратами нужно измерять заново.
Когда HASA меняет планы внедрения
Работа меняет планы команд, которые разворачивают модели самостоятельно и упираются именно в расчёт внимания на длинном контексте. HASA не требует дообучения маршрутизатора или изменения весов: спектральный анализ можно провести заранее, а затем добавить компактные представления и адаптивное объединение областей в среду вывода.
Это не означает автоматического ускорения после замены конфигурации. Среда должна уметь хранить сводки областей, выбирать разные разбиения для голов и выполнять разреженное внимание по выбранным полноразмерным состояниям. Поэтому метод стоит рассматривать как изменение ядра вывода, а не как параметр запуска готового сервера.
Для продукта, который обращается к модели через внешний API, работа планов не меняет: команда не управляет матрицами внимания и способом доступа к KV-кэшу. То же относится к системам, где задержку определяют генерация коротких ответов, сетевой обмен или другая часть конвейера.
Если длинный контекст уже стал узким местом, практический следующий шаг — снять профиль плотного и текущего разреженного внимания на собственных запросах. HASA имеет смысл прототипировать там, где стоимость выбора областей заметна, а фиксированные блоки теряют точность или обращаются к лишним состояниям. Главная идея работы для архитектурного плана состоит не в конкретной эвристике, а в отказе от единого разрешения для всех голов.
Источники
Иллюстрация: рисунок из статьи «Attend at the Right Resolution: Head-Adaptive Sparse Attention via Query-Key Interaction Structure», Wajih Hassan Raza, Ahsan Bilal, Yidan Shen и др., CC BY-SA 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


