
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили превращать собственные неудачные решения в подсказки для дальнейшего обучения, а затем постепенно отказываться от этой помощи. В нерецензированном препринте авторы сами получили прирост точности над GRPO до 6,18 процентного пункта. Метод может пригодиться при обучении рассуждающих моделей с автоматической проверкой ответа, но заметно увеличивает число генераций.
Подсказка возвращает сигнал, но меняет цель обучения
Групповая относительная оптимизация стратегии, или GRPO, обучает модель на нескольких решениях одной задачи. Автоматический проверяющий модуль отмечает правильные ответы, после чего алгоритм усиливает удачные варианты и подавляет неудачные.
Для этого внутри группы нужны разные результаты. Если модель решила задачу во всех попытках, дополнительный сигнал почти не нужен. Если она ошиблась во всех, GRPO также нечего сравнивать: одинаковые награды не указывают, в какую сторону менять модель.
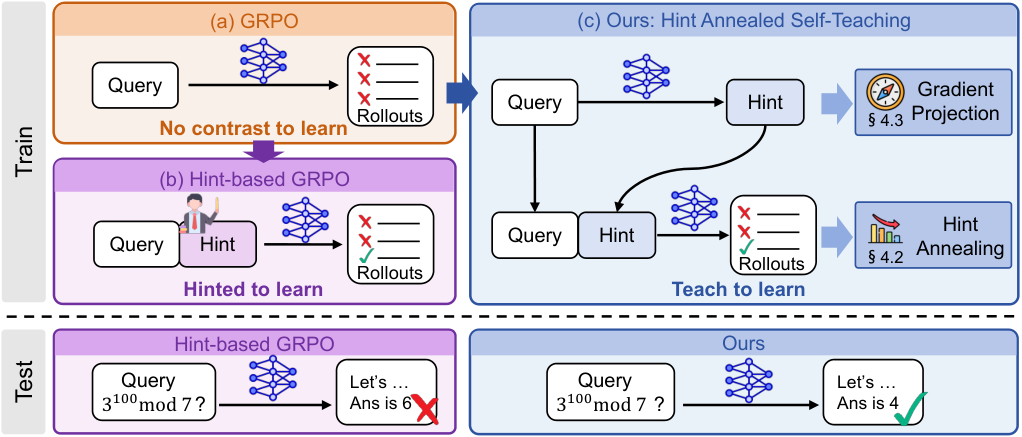
Подсказки возвращают контраст. Модель получает часть полезного рассуждения, повторяет попытку и иногда выдаёт смесь правильных и неправильных ответов. Эти траектории уже можно использовать для обучения.
Проблема возникает, если считать решения с подсказкой обычными. На проверке модели снова дают только исходную задачу, поэтому обучение и применение проходят в разных условиях. Авторы называют это сдвигом вознаграждения из-за подсказок: обновления улучшают прежде всего работу с дополнительной опорой, а не самостоятельное решение.
Больше подсказок ускоряло рост точности в начале эксперимента, но позднее результат ухудшался. Градиенты от самостоятельных и подсказанных решений часто шли почти перпендикулярно друг другу. Значит, полезный сигнал от подсказки не обязательно улучшает то поведение, которое потребуется после обучения.
HATCH ослабляет помощь по мере роста модели
HATCH использует одну модель в трёх ролях. Она решает исходную задачу, создаёт подсказку по задаче и эталонному решению, а затем решает задачу ещё раз с этой подсказкой. Качество повторных попыток одновременно показывает, полезно ли было само указание.
Для каждой задачи, которую модель не решила ни разу, система генерирует четыре подсказки. Под каждой она запускает восемь повторных решений, вдобавок к восьми исходным попыткам. HATCH сохраняет все полученные группы, а не выбирает одну лучшую подсказку, как некоторые сравниваемые методы.
Первый механизм регулирует вес решений с подсказками. Пока большинство сложных задач не даёт ни одного правильного ответа, такие решения сильно влияют на обучение. Когда в самостоятельных группах появляются и успехи, и ошибки, их вес автоматически снижается. Расписание заранее не задают: оно зависит от текущего распределения результатов.
Второй механизм согласует обучение генерации подсказок с основной задачей. HATCH сравнивает направления обновлений от подсказок и от решений. Если обучение подсказкам толкает модель против направления, полезного для самостоятельного решения, алгоритм удаляет только конфликтующую часть градиента. Совместимая часть остаётся.
Это не дистилляция из отдельной крупной модели: подсказки создаёт та же стратегия, которую обучают. Однако во время их генерации HATCH использует эталонное решение. При итоговой проверке модель не получает ни его, ни подсказку.
Планы менять рано, но схему обучения стоит пересмотреть
HATCH проверяли на девяти математических бенчмарках и трёх моделях семейств Llama и Qwen. Прирост над GRPO составил 1,70 процентного пункта на младшей модели, 3,56 на следующем масштабе и 6,18 на старшей. Метод также обошёл QuESTA и HiLL на всех проверенных масштабах.
Разбор компонентов подтверждает, что результат даёт не просто дополнительный объём генераций. Фиксированный вес подсказанных решений оказался хуже автоматического ослабления, а удаление проекции градиента снизило итоговую точность. Отдельная более крупная модель для создания подсказок тоже не воспроизвела результат совместного обучения.
Для команд, которые уже обучают LLM через проверяемую награду, работа меняет постановку эксперимента. Подсказанные траектории нельзя без поправок смешивать с самостоятельными: полезно отслеживать, сколько исходных групп уже дают контраст наград, и снижать вес вспомогательных данных по этому показателю.
Цена подхода — дополнительные генерации для каждой полностью проваленной задачи. Эксперименты запускали на 32 NVIDIA H20, поэтому перенос HATCH требует заранее оценить бюджет вычислений и выигрыш относительно более простого GRPO.
Границы проверки узкие: математические задачи имели эталонные решения и автоматически проверяемые ответы. Работа не показывает, что та же схема сохранит преимущество при вызове инструментов, диалоговом управлении процессами или работе с изображениями, где результат промежуточного шага меняет следующую подсказку.
Источники
Иллюстрация: рисунок из статьи «Teach to Learn: Hint Annealing for Self-improving LLM Reasoning», Zile Wang, Zijian Li, Haodong Wang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


