
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
LLM научили самостоятельно решать, когда открыть новый контекст для отдельной попытки, проверки или продолжения длинного решения. Хотя препринт не прошёл рецензирование и числа получили сами авторы, после Hermes-Learn точность Qwen3-4B выросла с 16,2% до 47,3%. Для команд, которые строят агентов с долгими цепочками рассуждений, управление контекстами становится отдельным навыком модели, а не только логикой управляющей оболочки.
Контекстное рассуждение управляет ходом решения
Дополнительные вычисления во время ответа помогают, только если модель умеет ими распорядиться. Когда задача не помещается в одно окно, системе приходится решать, какую работу вынести в новый контекст и какую часть уже найденного результата передать дальше. Авторы называют этот навык контекстным рассуждением.
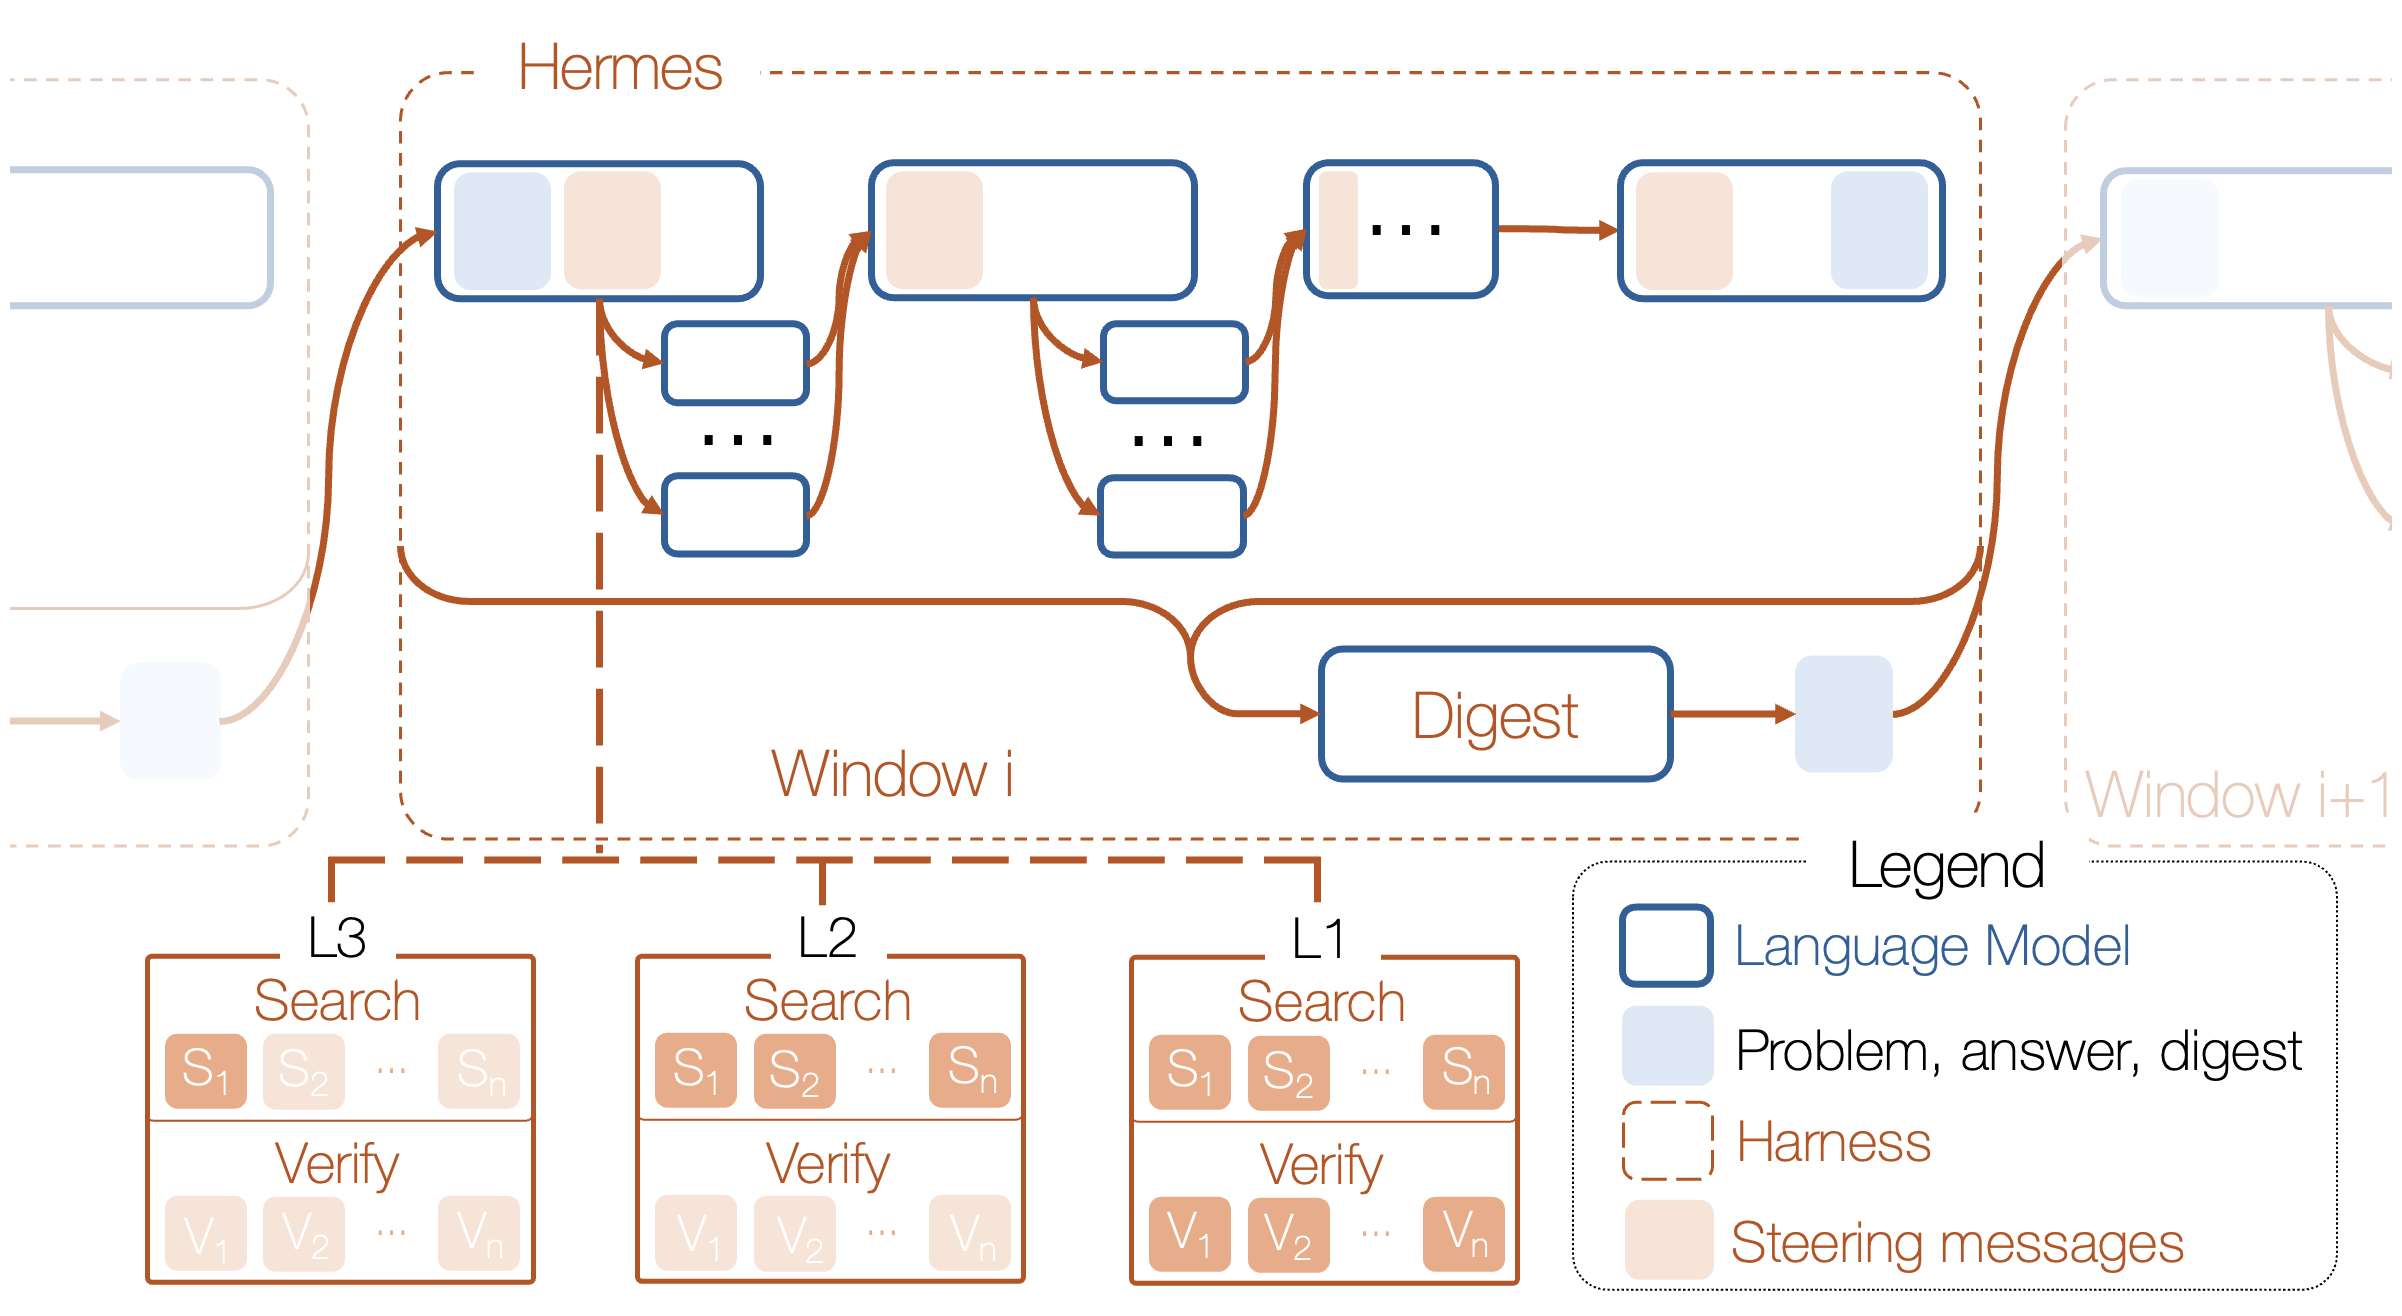
Hermes сводит управление к двум операциям. Делегирование запускает субагента в свежем контексте: тот может независимо решить всю задачу, проверить спорный шаг, попробовать другой подход или разобрать подзадачу. Сжатие собирает накопленный прогресс в короткое резюме, после чего модель продолжает работу в новом окне без полной истории.
Управляющая оболочка может сильнее или слабее направлять модель. В самом жёстком варианте она заранее задаёт конкретную стратегию. В промежуточном — указывает только тип действия, например поиск или проверку. В наиболее свободном режиме модель сама выбирает момент, задачу для субагента и способ использовать его ответ.
Такое разделение показывает, почему длинная цепочка вызовов не равна долгому рассуждению. Модель может хорошо решать математику внутри одного окна, но бесполезно расходовать дополнительные контексты: повторять одну попытку, делегировать неподходящую подзадачу или не учитывать ответ субагента.
Hermes-Learn учит делегировать в два этапа
Сначала модель дообучают с учителем на успешных траекториях Claude Sonnet 5 и DeepSeek-V3.2. В выборку попадают решения, где корневой агент хотя бы раз делегировал работу и в итоге дал правильный ответ. Модель видит не только готовый результат, но и момент вызова субагента, формулировку его задачи и дальнейшее использование ответа.
Затем обучение с подкреплением оставляет модели больше свободы. Награда бинарная: правильный финальный ответ приносит единицу, неправильный — ноль. Учебная программа сначала показывает режимы с более явными подсказками оболочки, а затем ослабляет управление, чтобы модель сама выбирала стратегию.
Обучают только действия корневого агента. Субагенты работают на глубине одного перехода, а умение составлять сжатое резюме отдельно не оптимизируют: работа сосредоточена на делегировании. Поэтому Hermes-Learn пока следует рассматривать как способ научить модель распределять задачи, а не как полную программу обучения всех частей многоагентной системы.
Проверка охватывает Qwen3-4B, Olmo-3-7B и более способные модели на AIME, HMMT, BeyondAIME, IMO-AnswerBench и FrontierScience. Один контекст ограничивали 8 тысячами токенов, а стандартная конфигурация Hermes могла распределить до 56 тысяч токенов между агентами. Модели сравнивали с обычным решением внутри одного окна и с разными уровнями управления со стороны оболочки.
Дополнительные контексты придётся учитывать в обучении
Способные модели использовали Hermes без специальной подготовки. У Claude Sonnet 5 средняя точность на объединённом математическом наборе выросла с 55,3% при работе в одном окне до 76,7% в свободном режиме Hermes. Базовые компактные модели, напротив, сначала тратили дополнительные контексты во вред результату.
Эффект перенёсся на другую архитектуру: у Olmo-3-7B точность с Hermes выросла с 4,8% до 40,6% после двух этапов обучения, тогда как качество внутри одного окна осталось почти прежним. Значит, прибавка связана не с новым математическим знанием, а с тем, как модель организует вычисления между окнами.
Обученный навык сохранился и при конфигурациях, которых модель не видела во время подготовки. Когда авторам разрешили более глубокое рекурсивное делегирование, Qwen3-4B достиг 55,6%. Hermes-Learn также сочетался с другими способами масштабировать вычисления во время ответа, включая Recursive Self-Aggregation и DeepSeekMath Agent.
Для архитектуры продукта вывод зависит от выбранной модели. Если система работает через API способной модели, можно сначала вынести поиск, проверку и сжатие истории в простую оболочку и проверить, умеет ли модель сама выбирать между ними. Для небольшой открытой модели добавление параллельных агентов без обучения рискованно: больший бюджет контекста сам по себе не гарантирует прироста.
Команде, которая обучает собственную модель, стоит сохранять успешные траектории работы с инструментами и оценивать не только финальный ответ, но и решения о делегировании. Hermes показывает практичную последовательность: сначала продемонстрировать стратегии под управлением оболочки, затем постепенно передать выбор модели. Работа подтверждает этот подход прежде всего на математических и научных задачах с длинным рассуждением.
Источники
Иллюстрация: рисунок из статьи «Hermes: Learning Contextual Reasoning Unlocks Test-Time Scaling», Xinyu Li, Mononito Goswami, Hao Liu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


