
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Языковую модель научили улучшать проверяемую программу, сохраняя только лучший найденный вариант и предлагая следующие правки к нему. В препринте Oracle, который пока не рецензирован и чьи числа получили сами авторы, Hill Sampling показал лучший опубликованный результат в упаковке окружностей и обошёл ориентир AlphaEvolve в задаче Эрдёша. Для систем с точной автоматической проверкой это даёт простой базовый вариант перед архивами решений, управлением разнообразием и дообучением модели во время поиска.
Лучший вариант становится контекстом следующей попытки
Hill Sampling начинает с исходной программы. Замороженная LLM предлагает пакет правок, проверяющая программа исполняет каждый вариант и присваивает ему числовую оценку. Лучший кандидат заменяет текущую программу, после чего модель редактирует уже его.
Если новая программа получила такую же оценку, её тоже можно сохранить. Это позволяет менять направление поиска, не ухудшая найденный результат. При этом система не хранит архив кандидатов, не скрещивает решения, не задаёт отдельную цель для разнообразия и не меняет веса модели.
Эта деталь отделяет Hill Sampling от обычной повторной генерации. В базовом варианте модель каждый раз редактирует исходный код, поэтому удачная промежуточная находка не влияет на следующие ответы. Здесь у поиска есть только одно состояние — лучшая проверенная программа.
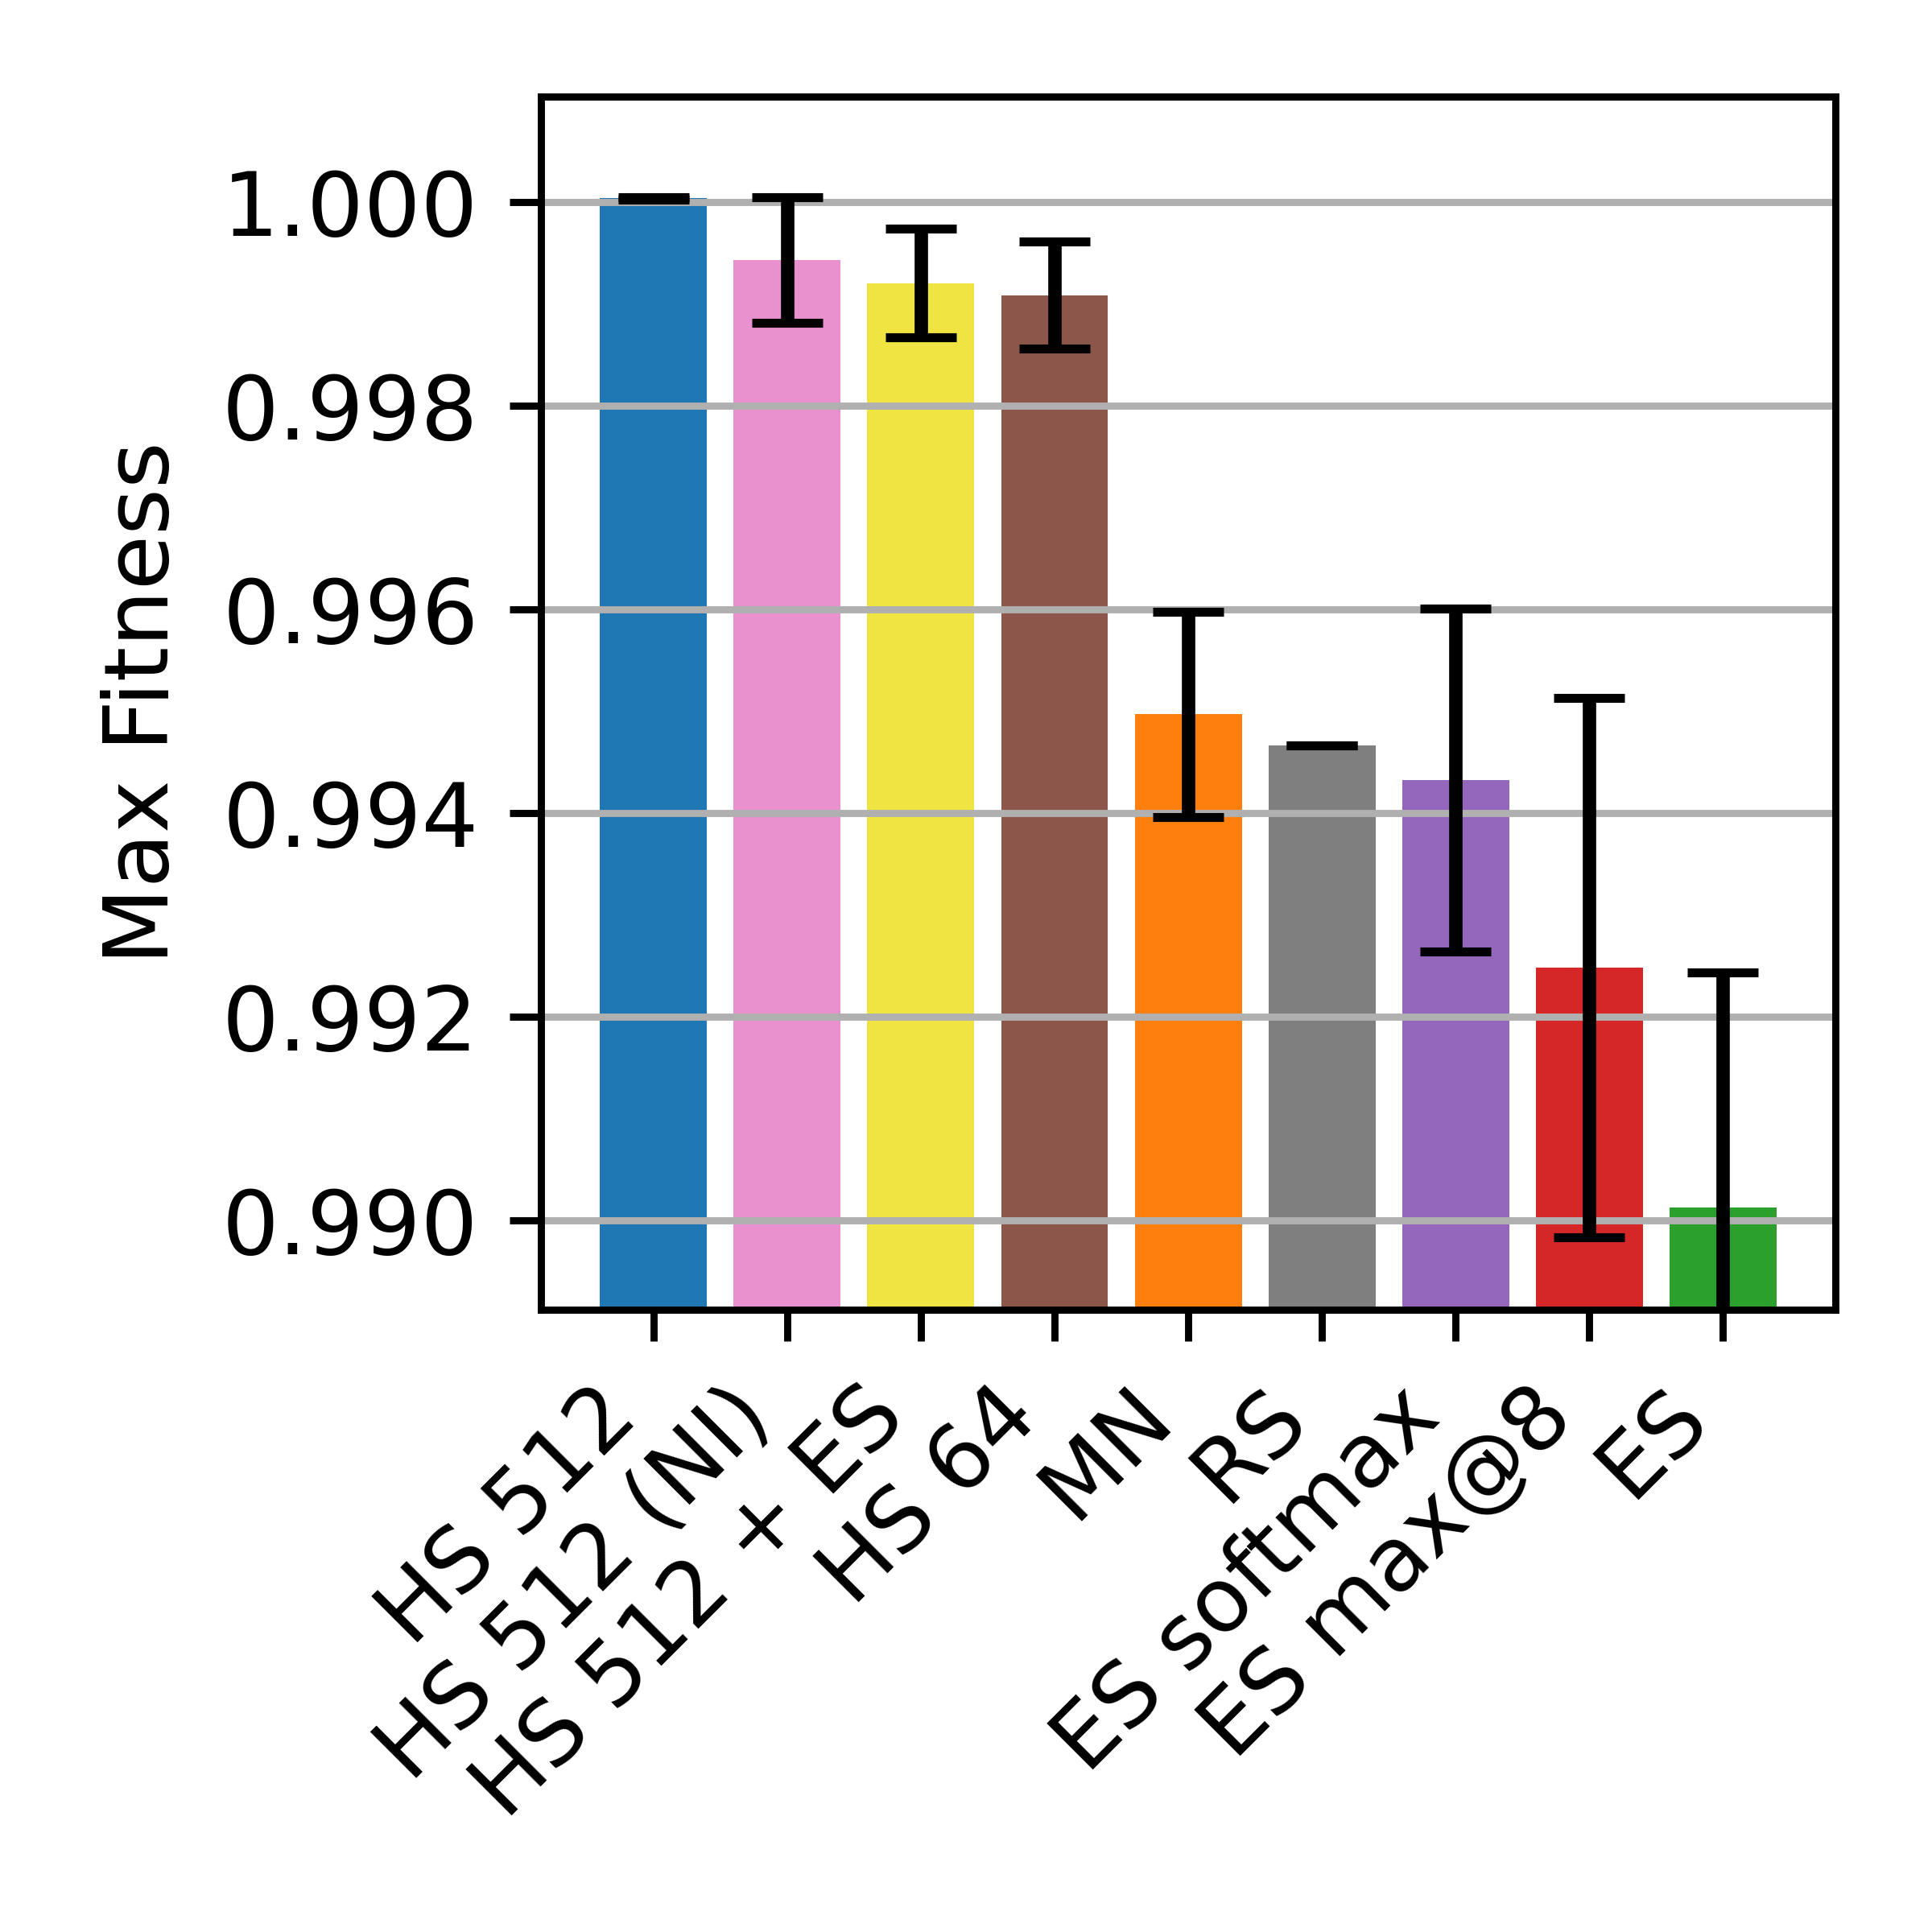
Цель тоже отличается от обычной оптимизации LLM. Система ищет не высокий средний балл ответов, а один максимальный результат за весь вычислительный бюджет. Эволюционные стратегии, которые случайно возмущают веса модели и закрепляют полезные направления, улучшали среднее качество, но снижали шанс получить редкий лучший вариант.
Метод проверили на упаковке окружностей, суммах и разностях конечных множеств и задаче Эрдёша о минимальном пересечении. Для каждой задачи выбрали отдельную модель с открытыми весами: gpt-oss-20b, OLMo-3.1-32B-Instruct и Mistral-Small-3.1-24B-Instruct. Методы сравнивали при одинаковом числе ответов модели, а вычисления распределяли между восемью NVIDIA H100.
Простая память обошла сложные схемы поиска
В упаковке окружностей Hill Sampling превзошёл прежний опубликованный результат только на восьмом знаке после запятой. Разрыв мал, но задача уже плотно оптимизирована, а поиск занял менее пяти часов. Удаление начальной предметной подсказки здесь не ухудшило результат.
В задаче Эрдёша меньшая оценка означает лучшее решение. Hill Sampling получил 0,38089767 против 0,38092304 у ориентира AlphaEvolve за 12 часов, хотя TTT-Discover сохранил лучший опубликованный результат. Без исходного предметного кода качество падало, поэтому метод не отменяет необходимость подготовить постановку и начальное решение.
На конечных множествах Hill Sampling показал сильный результат, но не обошёл AlphaEvolve и Hyra. Разница между исследованными методами там оставалась в пределах погрешности. Это не универсальная победа одной схемы, а свидетельство того, что сложность поисковой обвязки сама по себе не гарантирует улучшения.
Случайные возмущения весов давали полезное разнообразие, но обычная случайность при выборе токенов работала лучше. Обновление весов повышало среднюю оценку ответов, однако не улучшало максимум. Контроль разнообразия, несколько родительских программ, подгруппы кандидатов, обратная связь от исполнения и дополнительное управление температурой также не дали статистически значимого преимущества над Hill Sampling в расширенном сравнении на задаче Эрдёша.
Когда команде менять план поиска
Работа поддерживает конкретный порядок разработки для задач, где результат можно точно проверить кодом. Сначала стоит собрать цикл из генерации правок, исполнения кандидатов, выбора лучшего и передачи его в следующий запрос. Архивы, несколько ветвей поиска и изменение весов модели имеет смысл добавлять после того, как этот вариант упёрся в измеримый предел.
Такой подход сокращает число движущихся частей. Не нужно синхронизировать популяции решений, хранить историю происхождения кандидатов или обслуживать обучение во время выполнения. Ошибки проще локализовать: отдельно проверяются запрос к модели, исполнитель кода, функция оценки и правило замены текущего решения.
Размер пакета остаётся инженерным компромиссом. Большой пакет лучше загружает GPU, но найденное улучшение позже попадёт в контекст следующих генераций. Малый пакет чаще обновляет текущую программу, зато хуже использует параллельное оборудование.
Вывод относится к программам с числовой оценкой и исполняемой проверкой. В работе не исследовали диалоги, тексты с субъективной оценкой или процессы, где ошибку нельзя определить автоматически. Авторы также выбирали практическое время до сильного результата, а не минимальное число запросов, поэтому для дорогого внешнего API экономику поиска придётся считать отдельно.
Источники
Иллюстрация: рисунок из статьи «Hill Sampling for Test-Time Scaling: A Simple and Better Alternative to Repeated Sampling, Evolution, and Training», Jacob Beck, Philip V. Ogren, Ari Kobren, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


