
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для GRPO можно выбирать точность сохранённых активаций по их вкладу в текущее обновление модели, а не только по цене памяти и пересчёта. Команда Xinrui Chen, Mengyang Li, Ou Wu и Ji Zhang показала на HiLoRe ускорение шага обновления до 13,5% относительно схемы с контрольными точками в препринте, который не прошёл рецензирование и содержит замеры самих авторов. Подход позволяет использовать свободную память GPU, не увеличивая пакет данных и не меняя задачу обучения.
Точность активаций привязали к текущему обновлению
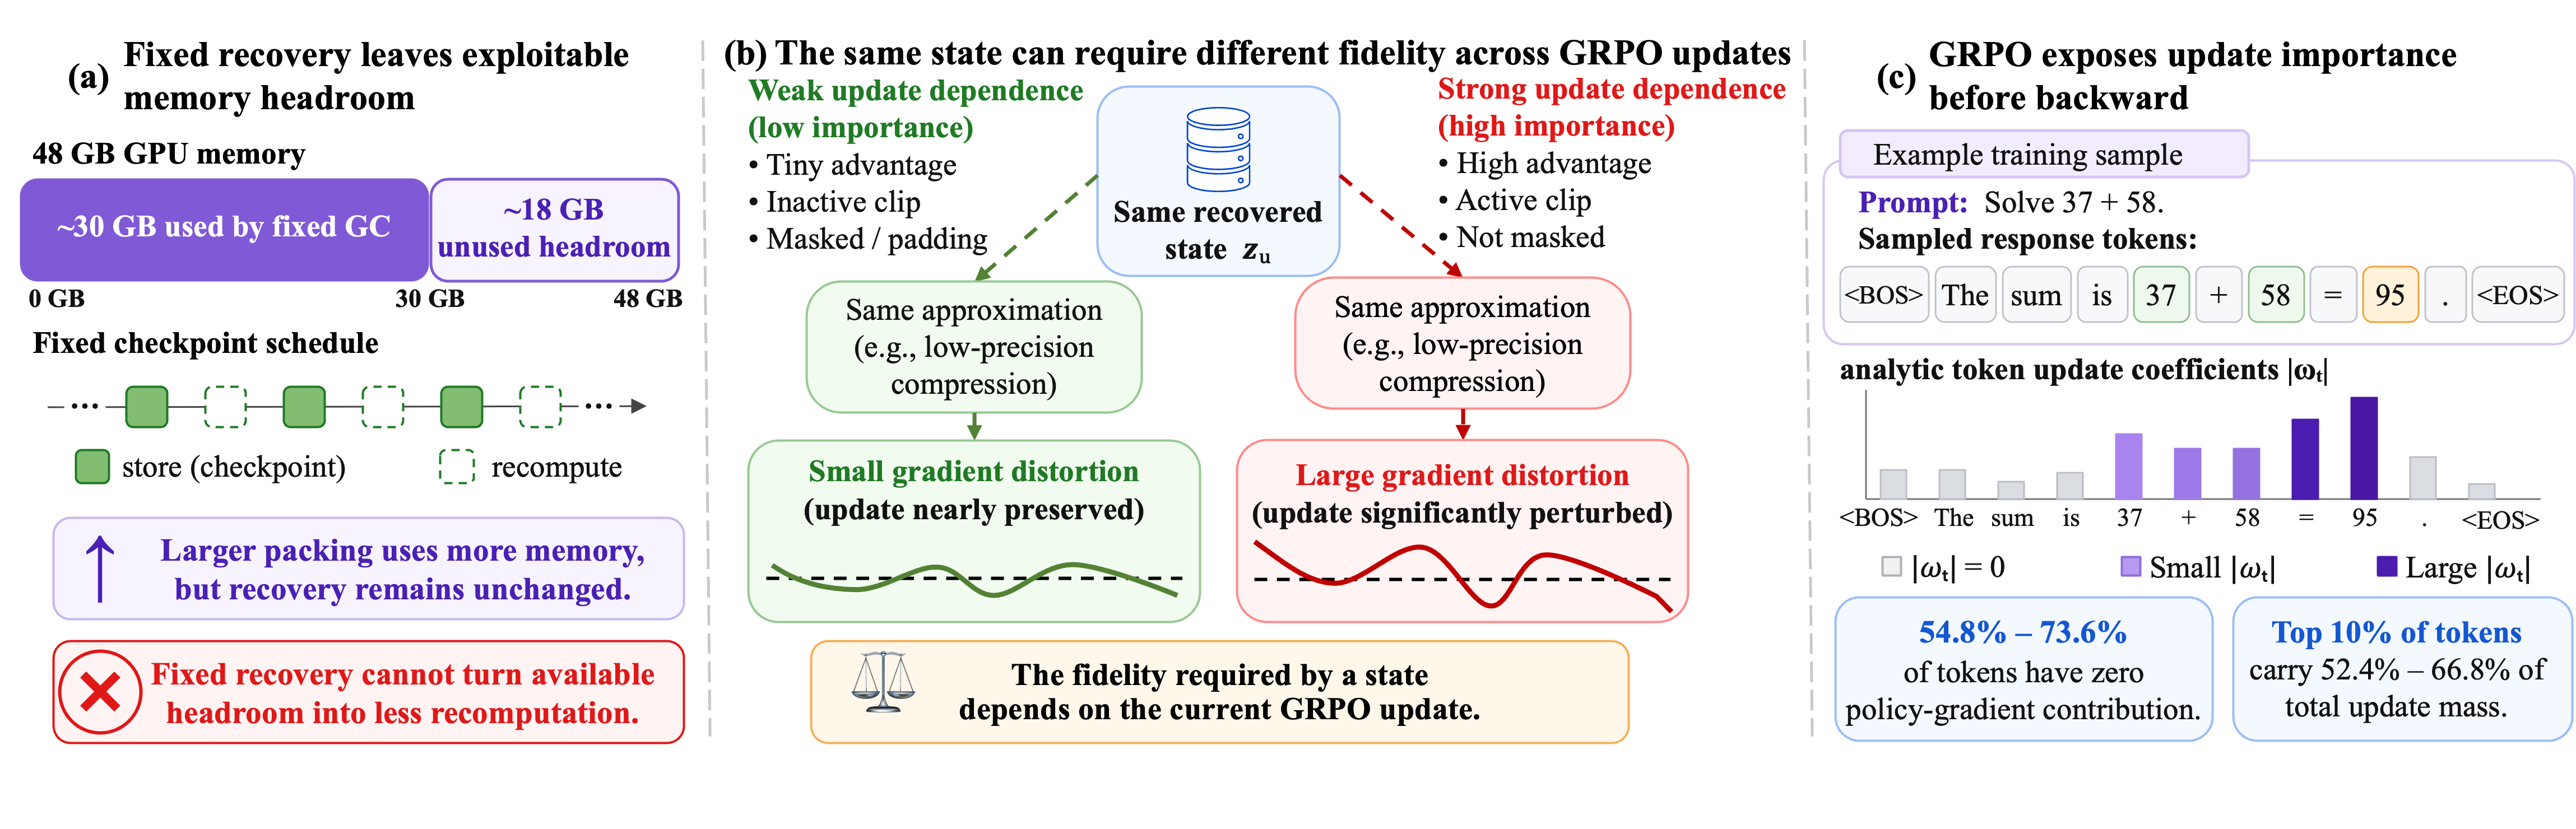
GRPO обучает модель по группе ответов на один запрос. Во время прямого прохода модель создаёт промежуточные тензоры — активации, которые затем нужны для вычисления градиентов. Если хранить их все, быстро заканчивается память GPU; если удалить, часть прямого прохода приходится повторять.
Обычная схема с контрольными точками заранее определяет, какие активации сохранить, а какие пересчитать. Такой график не учитывает, насколько конкретный тензор важен для текущего шага обучения. В результате GPU может одновременно тратить время на повторные вычисления и оставлять часть памяти незанятой.
HiLoRe использует коэффициент обновления для каждого токена. Он объединяет преимущество ответа относительно других ответов группы, отношение вероятностей старой и текущей политики, отсечение слишком больших изменений, маску обучения и штраф за отклонение от опорной модели. Все эти величины известны после прямого прохода и до вычисления градиентов, поэтому отдельный обратный проход для оценки важности не нужен.
Затем HiLoRe связывает токены с активациями через граф вычислений. Чем больше активное обновление зависит от тензора и чем чувствительнее к нему градиент, тем выше его экспозиция обновлению. Для участков с малым вкладом допустимо более грубое восстановление; участки, через которые проходит значимая часть обновления, получают точное хранение или пересчёт.
При этом прямой проход остаётся точным. Приближение появляется только во время восстановления части активаций для вычисления градиентов, поэтому механизм не меняет вероятности, на которых рассчитана функция потерь.
План хранения выбирается после прямого прохода
Авторы делят граф на единицы восстановления. Каждая включает полный набор тензоров, который нужен обратному проходу для конкретного участка графа. Это важное отличие от выбора отдельных массивов по размеру: неполный набор может занимать память, но не устранять повторное вычисление.
Для каждой единицы доступны три действия: сохранить активации в исходной точности, сжать их до низкой точности или удалить и детерминированно пересчитать. Хранение и пересчёт сохраняют исходное обновление, но по-разному расходуют память и вычисления. Сжатие экономит оба ресурса ценой небольшой ошибки в градиенте.
Перед обучением HiLoRe профилирует граф: измеряет выигрыш во времени и расход памяти для каждого варианта. На отдельных пакетах система также проверяет, как ошибка восстановления меняет градиент, и калибрует риск для разных групп активаций.
До прямого прохода система готовит допустимые представления в пределах памяти. После него пересчитывает экспозицию по текущему обновлению и решает задачу распределения ресурсов: выбирает по одному действию для каждой единицы так, чтобы получить максимальную экономию времени и не превысить бюджеты памяти и ошибки. Время на сбор статистики, распаковку и само распределение входит в экспериментальные замеры.
Работа меняет план оптимизации, но не обещает ускорить весь цикл GRPO
При потолке памяти не выше 1,10 от пика схемы с контрольными точками HiLoRe обошёл быстрейшую из проверенных альтернатив на 7,9%. Средняя разница в итоговых оценках моделей осталась меньше 0,6 процентного пункта.
Отдельный эксперимент показывает вклад привязки к текущему обновлению. Полная версия HiLoRe ускорила шаг на 10,16%, тогда как вариант с неизменной оценкой риска — на 8,31%. Значит, выигрыш даёт не только сочетание хранения, сжатия и пересчёта: решение действительно использует структуру конкретного обновления.
Проверки охватывают Qwen2.5, Phi-3.5 и Llama-3.1 размером от 3 до 8 млрд параметров, задачи по математике, программированию и логике, а также ответы длиной 2K токенов. Основной сценарий использует LoRA, а сравнения проводят при фиксированной нагрузке GRPO, чтобы отделить управление активациями от изменения пакета или отбора ответов.
Для команды, которая уже упирается в память на шаге обновления политики, работа добавляет практический вариант между двумя крайностями — хранить всё или постоянно пересчитывать. Однако HiLoRe нельзя свести к одному параметру запуска: потребуются разбор графа, профилирование полезности, калибровка ошибки и поддержка трёх способов восстановления в обучающем контуре.
Замеры относятся к обновлению политики, а не ко всему циклу с генерацией ответов. Если основное время уходит на получение ответов от модели, такое ускорение не переносится на полный запуск напрямую. Если же узкое место находится в обратном проходе, HiLoRe даёт основание сначала измерить свободную память и повторные вычисления, а затем испытать динамическое распределение точности на собственном графе.
Источники
Иллюстрация: рисунок из статьи «HiLoRe: What to Store, Compress, or Recompute for Efficient GRPO Training», Xinrui Chen, Mengyang Li, Ou Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


