
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Два LLM-агента могут по очереди улучшать модель, сохраняя код и результаты, но начиная каждую сессию с чистым контекстом. В работе Tsinghua University, NVIDIA, Zhejiang University и MIT, которая не проходила рецензирование и приводит замеры самих авторов, HMA получила медаль на 78,2% задач MLE-bench и опередила сильнейший открытый вариант на 8 процентных пунктов. Для продуктовой команды это переносит точку оптимизации с инструкций отдельному агенту на порядок передачи работы между агентами.
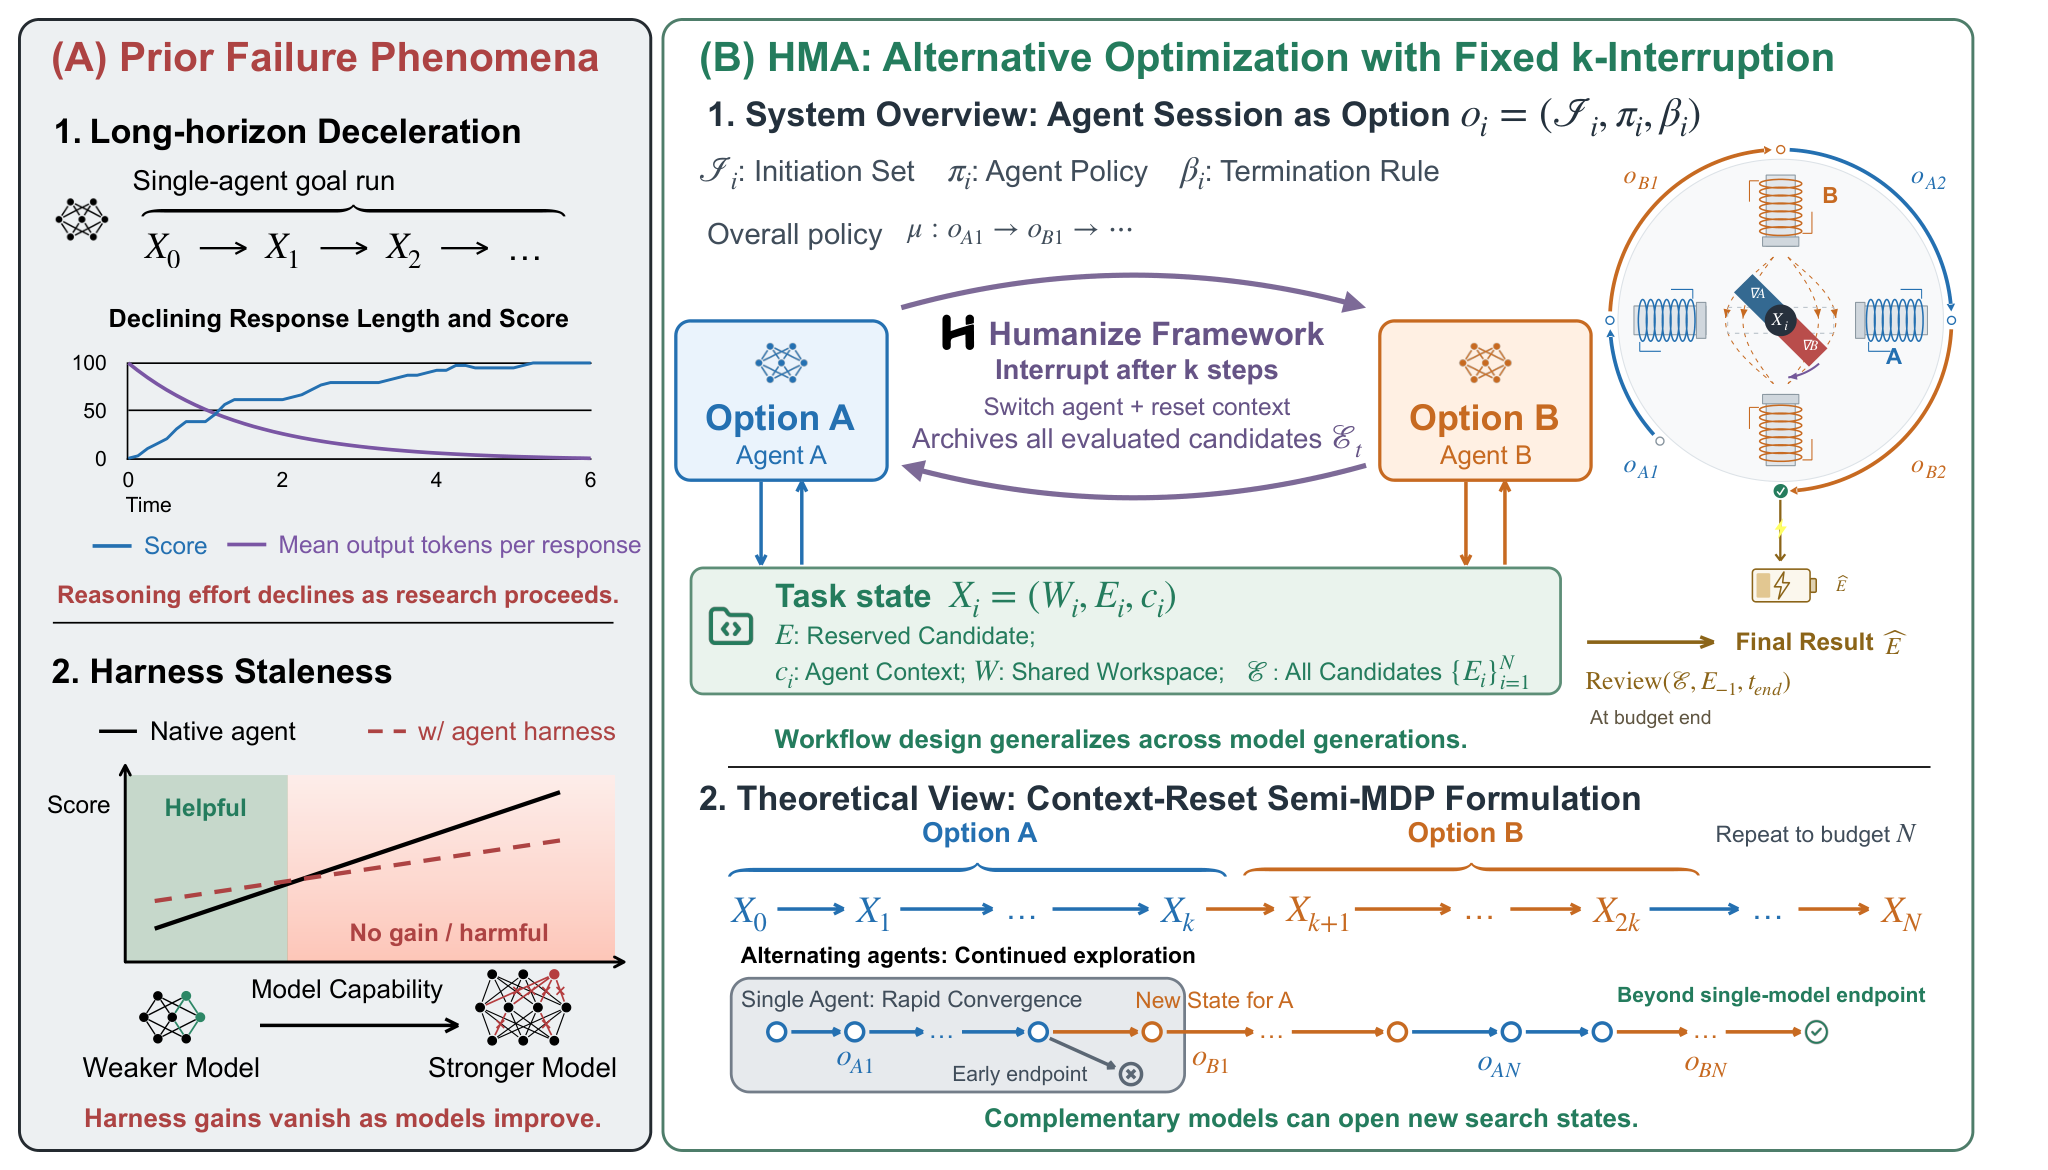
Длинная сессия замедляет поиск улучшений
В инженерии машинного обучения агент пишет код, запускает обучение, оценивает результат и выбирает следующий эксперимент. Рабочее решение появляется сравнительно рано, после чего агенту приходится искать всё менее очевидные улучшения.
Среднее число выходных токенов в ответе использовали как косвенный показатель того, сколько рассуждений агент тратит на следующий шаг. От ранней к поздней части сессии этот показатель снижался на 29,8–45,0%, а прирост качества одновременно замедлялся. Продление одной и той же сессии не поддерживало прежнюю интенсивность поиска.
Специализированная исполнительная обвязка тоже не давала устойчивого преимущества. Инструкции, навыки и накопленные подсказки помогали более слабой базовой модели, но теряли пользу или мешали после её замены на более способную версию. Команде в таком случае приходится заново настраивать не только модель, но и слой правил вокруг неё.
HMA не меняет внутреннюю работу агентов. Каждый использует собственную штатную обвязку, а координация происходит уровнем выше: через общую папку с кодом, обученными моделями, оценёнными кандидатами и журналом экспериментов.
Как сброс контекста превращается в управляемый процесс
Схему описали как полумарковский процесс принятия решений со сбросом контекста (CR-SMDP). Отдельная сессия здесь считается действием переменной длины. Состояние включает общую рабочую среду, лучший сохранённый результат и контекст активного агента.
На границе сессий файлы и лучший кандидат сохраняются, а контекст очищается. Следующий агент получает фактический результат предыдущей работы, но не наследует всю историю диалога. Так система отделяет полезное состояние проекта от контекста, который разрастается и может направлять поиск по уже исчерпанной траектории.
Теоретическая гарантия держится на двух содержательных условиях. Во-первых, процесс сохраняет лучший найденный результат и не заменяет его худшим. Во-вторых, один агент с ненулевой устойчивой вероятностью создаёт состояние, которое другой способен превратить в решение выше предела одиночных вариантов.
При этих условиях вероятность не достичь целевого качества геометрически уменьшается после каждого полного цикла. Требуемый бюджет растёт вместе с лимитом экспериментов на сессию и падает по мере роста совместной вероятности успеха. Это не доказывает пользу любой пары моделей: формализм показывает, какое именно взаимное дополнение должно существовать.
Жёсткое прерывание сессии сохраняет преимущество, если ожидаемая польза от переключения выше пользы от продолжения текущей ветки. Для практической настройки HMA выбрали лимит k=5: такой короткий префикс сохранял 97,83% наблюдаемого прироста при выполнении 73,77% экспериментов внутри сессии. Лимит считают по завершённым экспериментам, а не по ответам модели.
Командам стоит тестировать передачу работы до переписывания обвязки
Основная проверка охватила 75 соревнований Kaggle из MLE-bench. Запуски шли на одной NVIDIA A10 с одинаковым шестичасовым бюджетом; в разных сочетаниях участвовали агенты GPT, Kimi, GLM, DeepSeek и Claude. Тестовые оценки были скрыты от агентов и использовались только после завершения работы.
Средний прирост доли задач с медалью относительно исходных одиночных вариантов составил 6,4 процентного пункта, причём улучшение появилось во всех проверенных сочетаниях. Это существеннее одного удачного союза моделей: результат показывает, что полезен сам шаблон с общей средой, ограниченными сессиями и регулярной сменой исполнителя.
В рабочей системе понадобятся общий репозиторий, хранилище кандидатов, воспроизводимый запуск экспериментов и правило, которое не позволяет потерять лучший результат. После каждой серии запусков оркестратор завершает сессию, очищает контекст и передаёт среду другому агенту. В конце агент, который не создавал последний кандидат, просматривает архив и выбирает итоговый вариант.
Работа меняет планы прежде всего там, где агент часами улучшает измеримый результат и оставляет проверяемые артефакты. Перед разработкой новых подсказок и памяти имеет смысл сравнить одиночный запуск с чередованием двух штатных агентов при равном бюджете. Дополнительный опыт с оптимизацией вычислительного ядра показывает применимость схемы за пределами MLE-bench, но там проверен только один длительный запуск, поэтому сравнительного вывода пока нет.
Источники
Иллюстрация: рисунок из статьи «Humanize MLE Agents: Multi-Agent Session Alternation Beyond Single-Agent Limits», Changye Li, Zijian Zhang, Muheng Li и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


