
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Значения атрибутов товара научились извлекать быстрее, не заставляя языковую модель генерировать то, что уже написано в карточке. В нерецензированном препринте Amazon, где числа получены самими авторами, гибридный декодер сократил среднюю задержку на 44% по сравнению с полностью генеративной моделью. Такой подход меняет архитектуру конвейера: частые значения можно копировать из исходного текста, а генерацию оставить для неоднозначных случаев.
Копируемые значения отделили от тех, которые нужно сформулировать
Обычный генеративный экстрактор получает описание товара и выводит пары вроде brand: Mrs Ball’s токен за токеном. Он умеет нормализовать значения, находить неявные признаки и создавать редкие названия атрибутов, но тратит время даже на дословное повторение текста.
Разметчик последовательности работает иначе: находит начало и конец значения прямо во входном тексте. Он быстрее и не перефразирует источник, но ограничен фиксированным набором атрибутов и не справляется со значениями, которых в тексте нет в готовом виде.
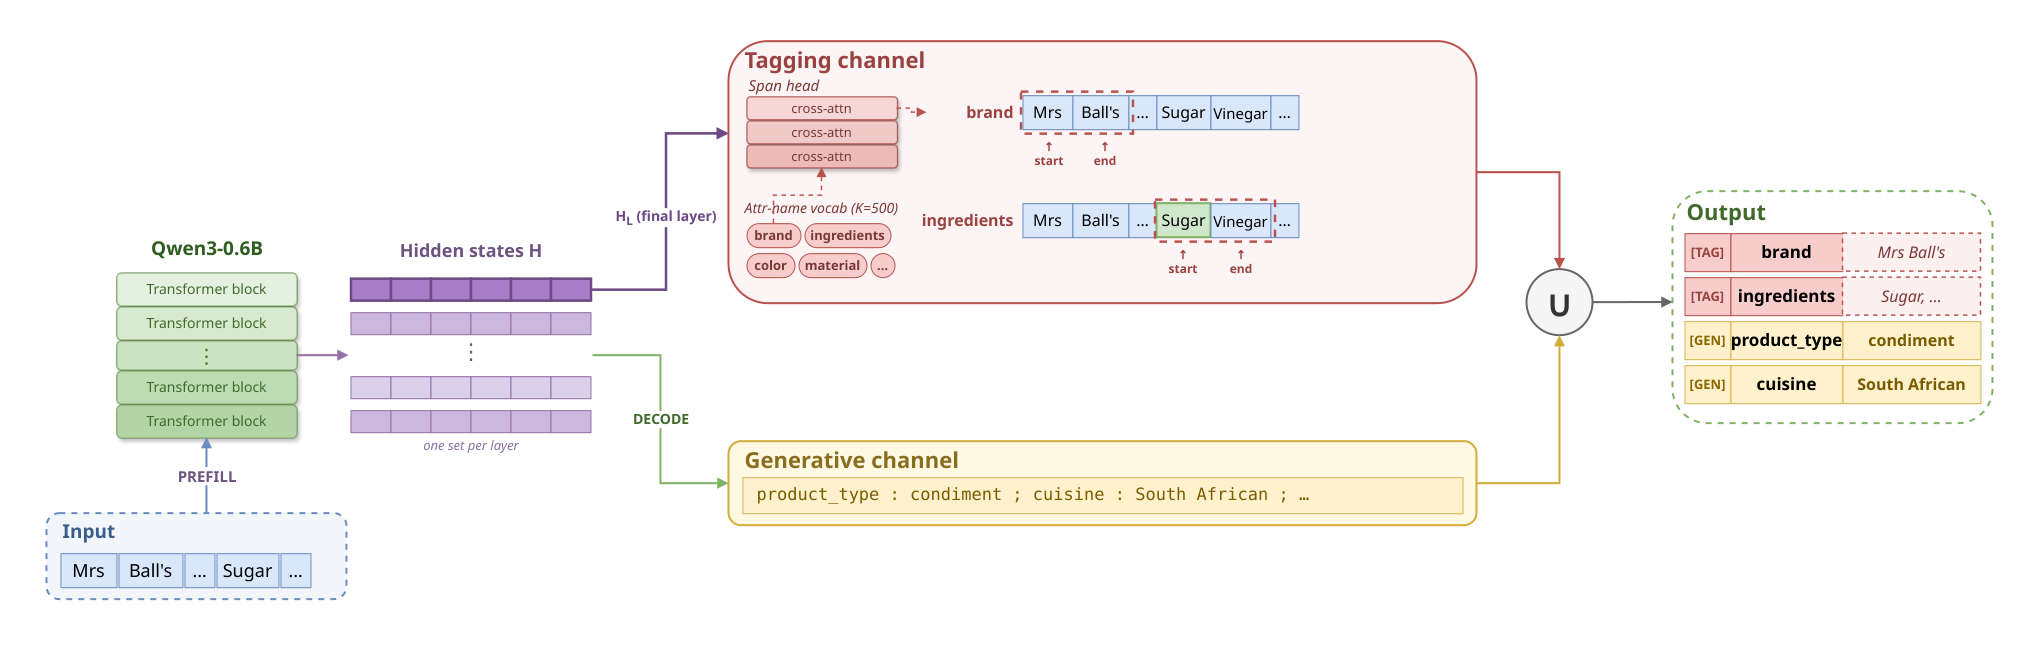
Гибридный декодер запускает оба канала поверх одного предварительного прохода модели. Разметчик проверяет 500 частых атрибутов и копирует найденные фрагменты, а генератор обрабатывает всё остальное: редкие атрибуты, нормализованные значения и признаки, которые приходится выводить из контекста.
Например, из строки с названием соуса можно напрямую скопировать бренд и список ингредиентов. Тип товара «condiment», кухню «South African» и диету «vegetarian» приходится сформировать или вывести по косвенным признакам. В рабочем корпусе 81% значений можно было скопировать, поэтому разделение каналов снимало с генератора основную часть вывода.
Для каждого известного атрибута разметчик сравнивает позиции текста с отдельным вариантом NULL. Если значение найдено, два указателя определяют начало и конец фрагмента; если уверенность ниже NULL, канал пропускает атрибут. Все атрибуты проверяются параллельно, без дополнительных шагов генерации. При конфликте между каналами система оставляет значение генератора.
Полнота выросла за счёт параллельной проверки атрибутов
Основной эксперимент провели на более чем ста тысячах текстовых карточек Amazon для рынка США. Разметку подготовила Kimi-K2.5, базовой моделью служила Qwen3-0.6B, а вывод запускали через vLLM на одной A100. Корректность пар оценивала модель-оценщик, которую отдельно сверили с людьми.
Полнота — доля эталонных атрибутов, которые система нашла, — выросла с 69,8% у генеративной модели до 80,2% у гибрида. Доля правильных пар среди всех выданных осталась около 97%. В среднем генеративная модель находила 20,7 правильной пары на товар, гибридная — 33,8.
Разница возникает не только потому, что разметчик быстрее копирует текст. Генеративная модель склонна пропускать редкие атрибуты ближе к концу длинного ответа, тогда как второй канал независимо проверяет каждое название из своего словаря. Одновременно генератор получает более короткую задачу и не повторяет ингредиенты, размеры и другие длинные фрагменты.
Схему также проверили на нескольких моделях семейств Qwen3 и Gemma-3, а также на публичных наборах AE-110K и OA-Mine. Направление результата сохранилось, но публичные наборы состоят из полностью копируемых значений: там чистый разметчик изначально находится в более выгодных условиях, чем в реальном каталоге со скрытыми и нормализованными признаками.
Границы проверки проходят по текстовым атрибутам одного каталога. Изображения, другие языки и перенос на каталоги с иным распределением атрибутов не изучались. Метрики также зависят от автоматически созданной разметки и модели-оценщика, поэтому абсолютные значения нельзя считать независимой проверкой качества.
Архитектура полезна там, где генератор в основном переписывает источник
Работа меняет планы команд, которые собирались решать извлечение атрибутов одним запросом к LLM. Если большая часть значений дословно присутствует в карточке, генеративный вывод для всех полей расходует задержку на задачу поиска. Разделение на копирование и генерацию позволяет ускорить систему и одновременно проверить больше частых атрибутов.
Это не приём для текста запроса и не готовая замена модели через API. Потребуются собственное обучение, разметка маршрута для каждой пары, дополнительная головка поиска фрагментов и интеграция с сервером вывода. Фиксированный словарь разметчика также нужно строить по распределению атрибутов конкретного каталога.
Первый практический шаг — измерить, какая доля целевых значений встречается в исходном тексте непрерывным фрагментом. Затем частые копируемые поля можно передать разметчику, а генератору оставить нормализацию, вывод по косвенным признакам и открытый набор редких атрибутов. Чем больше ответ состоит из дословных фрагментов, тем убедительнее основание менять архитектуру.
Для каталогов, где значения почти всегда нужно вычислять, переводить единицы или собирать из нескольких частей текста, выигрыш менее очевиден. В таком случае дополнительный канал усложнит обучение и обслуживание, но снимет с генератора лишь небольшую часть работы.
Источники
Иллюстрация: рисунок из статьи «Hybrid Generative-Tagging Decoding for Efficient Product Attribute-Value Extraction», Keshav Kolluru, Manas Gupta, Maroof Ahmad и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


