
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Одну предобученную языковую модель научились запускать в нескольких вариантах ширины без смены набора весов. В работе TUHH, Kiel University и UNU-INWEH, которая пока не прошла рецензирование и приводит замеры самих авторов, четверть полной ширины ускорила генерацию токенов на 75,3%. Один файл модели может обслуживать серверы и менее производительные устройства с разными требованиями к задержке.
Одна настройка сужает модель целиком
HydraLLM строится на многозапросном внимании (MQA), где головы запросов используют общие ключи и значения. Во время запуска система выбирает число активных голов, а вместе с ним пропорционально сужает представления токенов, проекции внимания, полносвязные слои и слой, который предсказывает следующий токен.
Каждый меньший вариант использует начало тех же матриц весов, что и полный. Поэтому варианты вложены друг в друга: отдельные модели извлекать и хранить не нужно, а ширину можно выбрать непосредственно перед запуском.
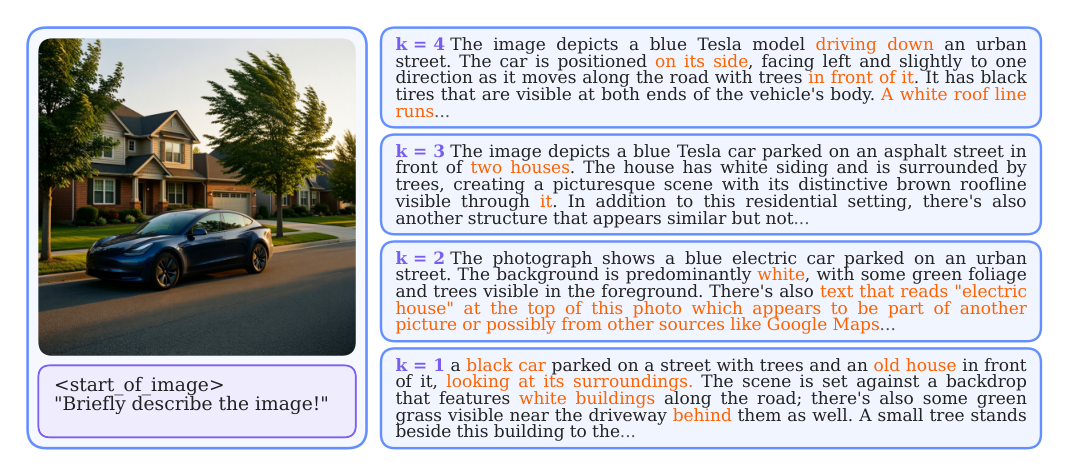
Для мультимодальной версии авторы добавили проекцию, которая переводит признаки изображения в пространство языковой модели. Её выход сужается вместе с текстовой частью, поэтому одна настройка управляет вычислениями сразу для изображения и текста.
Подход проверяли на Gemma 3 270M с четырьмя режимами ширины. Текстовую часть оценивали на ARC-Easy, TriviaQA и по способности предсказывать тексты Шекспира; сравнивали с MatFormer, который меняет только полносвязные слои. Скорость измеряли через llama.cpp на одной NVIDIA RTX PRO 4000. Мультимодальную модель обучали на наборах подписей, вопросов и текстов, а затем проверяли на COCO и MMMU.
Перестановка весов сохраняет качество узких подсетей
Обычный набор весов нельзя просто обрезать по ширине. Важные элементы распределены по всей матрице, поэтому первые строки или каналы не образуют самостоятельную модель и после такого среза качество резко падает.
Перед обучением HydraLLM переставляет элементы так, чтобы наиболее полезные оказались в начале каждой размерности. Для представлений токенов важность определяют по величине активаций. Для голов внимания и полносвязных слоёв лучше сработал CETT — показатель вклада элемента в итоговый выход слоя.
Перестановку согласованно проводят во всех связанных матрицах, поэтому полный вариант модели сохраняет прежнюю функцию. Затем на каждом шаге обучения случайно выбирают одну ширину и обновляют только её активные параметры. Начальные элементы участвуют в большем числе режимов и получают больше обновлений.
Дополнительно узкие варианты учатся повторять распределение ответов замороженной полной модели. Без такой дистилляции знаний они заметно хуже справлялись с TriviaQA. С тремя активными головами HydraLLM обошла сопоставимый вариант MatFormer на 2,2 процентного пункта, хотя у MatFormer было на 17,25% больше активных параметров. При полной ширине преимущество оставалось у MatFormer, поэтому HydraLLM выигрывает не во всех режимах.
Планы меняются для разнородного парка устройств
HydraLLM имеет смысл учитывать, если один продукт должен работать на нескольких классах оборудования или поддерживать режимы «быстрее» и «точнее». Вместо обучения и доставки нескольких моделей команда получает один набор весов и выбирает вычислительный бюджет при запуске. Это также упрощает обновление модели: все варианты меняются вместе.
Но метод нельзя добавить к произвольной LLM одной настройкой. Нужны совместимая архитектура, перестановка весов и дополнительное обучение всех вариантов ширины. Работа показывает это на одной небольшой базовой языковой модели и одном типе многозапросного внимания, поэтому перенос на более крупные модели остаётся отдельной инженерной задачей.
Мультимодальный результат пока требует особенно осторожной трактовки. HydraLLM получила CLIPScore 66,9 против 65,3 у в семь раз более крупной Gemma 3 4B, но эта метрика сравнивает подпись с изображением и чувствительна к стилю ответа. На MMMU модель отвечала примерно на уровне случайного выбора, а в примерах путала объекты, их свойства и положение.
Для текстовых сервисов работа даёт практическую схему: сначала определить, нужен ли один набор весов для разных бюджетов, затем проверить несколько фиксированных ширин на собственных задачах и оборудовании. Для распознавания документов и других сценариев, где требуется надёжная связь изображения с текстом, текущая мультимодальная версия служит скорее проверкой архитектурной идеи, чем готовой заменой отдельным моделям.
Источники
Иллюстрация: рисунок из статьи «HydraLLM: Adaptive Width Slicing for Elastic Text and Vision-Language Models», Oscar Kemme, Janek Haberer, Ali Hojjat и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


