Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Оркестратор многоагентной LLM-системы научили находить полезные связки вызовов, даже если каждый вызов по отдельности выглядит невыгодным. В препринте Kaixuan Liu и Guojun Xiong, который не прошёл рецензирование и где все числа получили сами авторы, удаление учёта таких связок снизило точность на задачах по коду на 7–17 процентных пунктов. Для команд это меняет подход к обучению адаптивных процессов: оценивать нужно не только отдельные решения, но и их сочетания.
Почему полезный шаг может выглядеть ошибкой
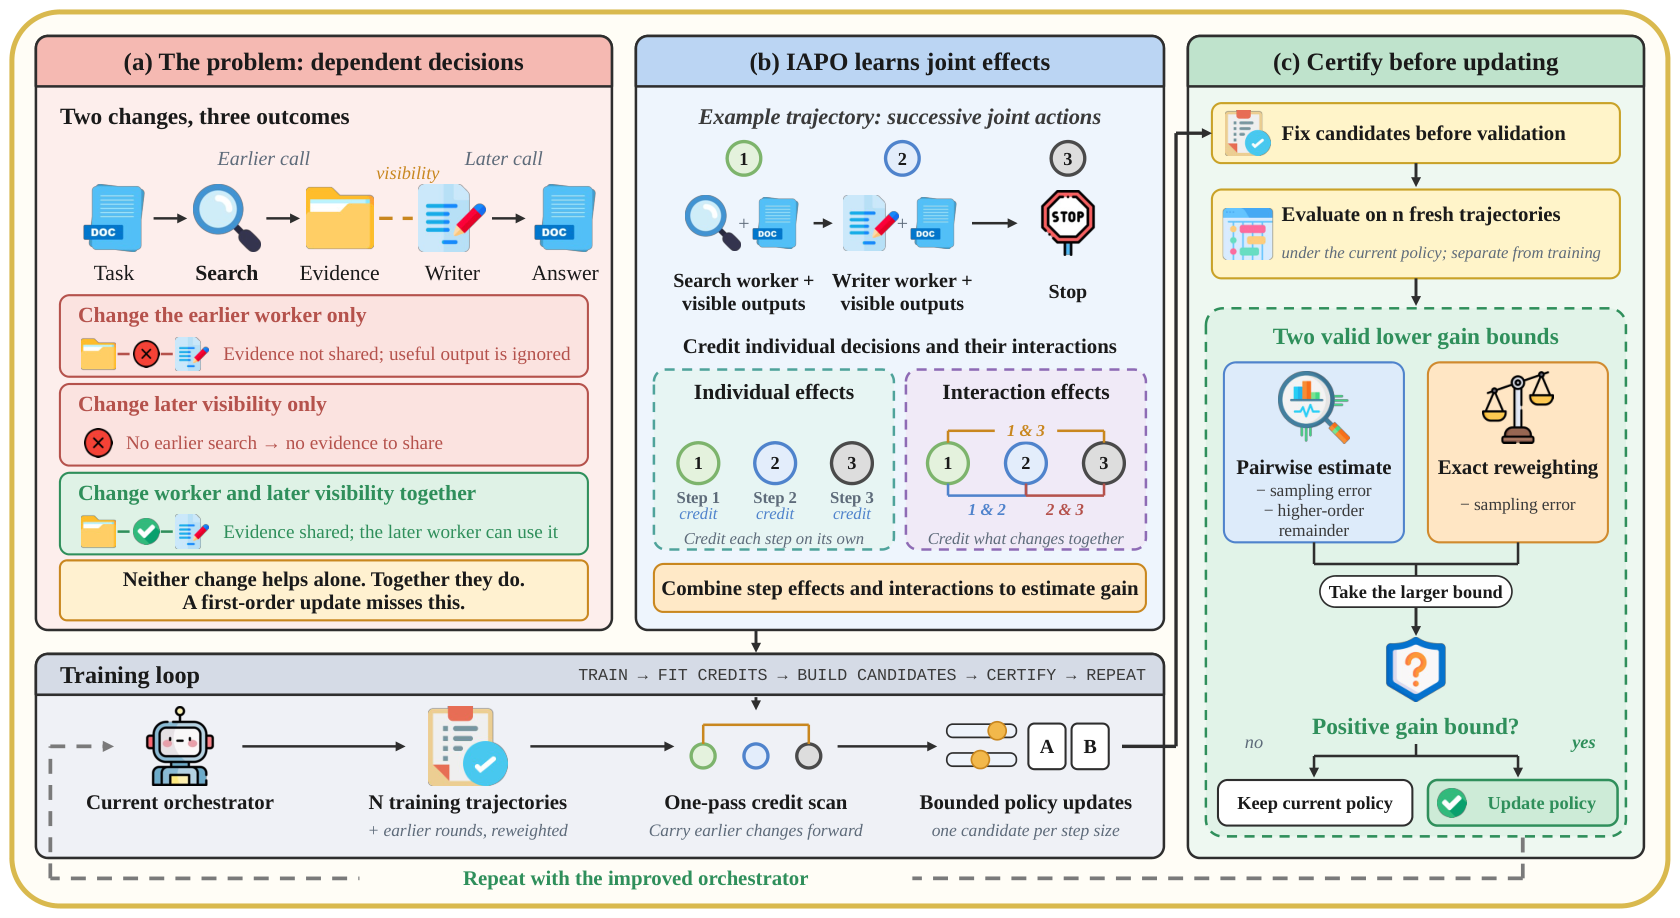
Оркестратор последовательно решает, какого исполнителя вызвать, какие предыдущие ответы ему передать и когда завершить работу. Обычные методы обучения с подкреплением приписывают каждому решению собственный выигрыш, как будто остальные решения в эпизоде не меняются.
Для многоагентного процесса это предположение часто не выполняется. Проверка и исправление программы полезны только после того, как другой исполнитель написал программу. Поиск фрагмента документа может не улучшить ответ сам по себе, но становится полезным, если следующий аналитик прочитает найденный фрагмент.
Пошаговая оценка отклонит первый элемент такой пары, если тот отдельно ухудшает итог. Она также не увидит совместный выигрыш двух изменений: сумма эффектов отдельных решений не равна эффекту всей цепочки.
IAPO раскладывает разницу между старой и новой стратегией на эффекты отдельных решений и их взаимодействия. Полное разложение включает связи любого порядка, но алгоритм при обучении оставляет одиночные и парные эффекты. Остаток от более сложных сочетаний он ограничивает математической верхней границей.
Обе части оценки вычисляются за один проход по траектории. Модель-оценщик не требуется: алгоритм использует итоговую награду, стоимость последующих вызовов и отношение вероятностей действий при старой и новой стратегиях.
IAPO отдельно подбирает кандидатов для нескольких размеров шага, а затем проверяет их на свежих траекториях. Обновление принимают, только если статистическая нижняя граница выигрыша положительна. Гарантия действует с заданной высокой вероятностью при условиях работы: действия новой стратегии должны оставаться возможными при старой, а награда и размер изменения стратегии — оставаться ограниченными.
Метод проверяли с фиксированными исполнителями на Qwen2.5-7B-Instruct, длинных версиях пяти наборов задач по математике, вопросам к тексту и программированию. Сравнение охватило пятнадцать опубликованных одноагентных, многоагентных и автоматически найденных процессов, запущенных на той же модели.
Связи между шагами повысили точность и сократили расход токенов
При бюджете токенов сильнейшего конкурента IAPO сравнялся с ним или превысил его точность — долю задач с правильным ответом — во всех проверенных средах. На отдельных эпизодах развёрнутые стратегии тратили от 2,7 до 24 раз меньше токенов, чем сильнейшие базовые системы.
Удаление парного члена из обучения и выбора плана особенно повредило программированию. Точность упала на 17,3 процентного пункта на MBPP и на 7,2 пункта на HumanEval. При этом вариант без взаимодействий расходовал больше токенов на каждом проверенном наборе задач.
Разница проявилась и в самих планах. Полная версия IAPO ставила проверку и исправление после написания программы, тогда как пошаговый вариант добавлял ещё одного программиста. В вопросах к документам IAPO передавал результат поиска аналитику; аналитик отдельно ухудшал ответ, поэтому метод без парной оценки его не выбирал.
Работа меняет планы только для обучаемой оркестрации
Если процесс заранее задан и не меняется по ходу задачи, добавлять IAPO некуда. Вывод относится к системам, где центральная стратегия несколько раз выбирает исполнителя и доступный ему контекст, а затем обучается по итоговому результату и стоимости вызовов.
Для таких систем пошаговую цель нельзя считать достаточной только потому, что она даёт правильное направление для малого обновления. При конечном шаге она пропускает зависимости между ранними и поздними решениями. Практический минимум — считать парные эффекты на одной траектории и сравнивать кандидатов на независимой проверочной выборке.
Гарантия безопасного обновления не означает, что новая стратегия обязательно будет принята. Если свежих траекторий недостаточно или выигрыш мал, нижняя граница останется неположительной, и алгоритм сохранит прежнюю стратегию. Поэтому в план обучения придётся заложить отдельный поток проверочных запусков, а не расходовать все данные на подбор кандидата.
Переносить результат на другие модели и производственные процессы следует через собственную проверку: эксперименты охватывают один исполнитель и выбранные задачи с длинным входом. Работа показывает не универсальный прирост, а конкретную причину, по которой обучаемый оркестратор может выбрать неверный процесс, если оценивать его решения независимо.
Источники
Иллюстрация: рисунок из статьи «Learning Multi-Agent Orchestration:Higher-Order Interactions in Policy Improvement», Kaixuan Liu, Guojun Xiong, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.