
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Замороженную языковую модель — ту, чьи веса не обновляют, — удалось ускорить и сделать точнее за счёт скрытых промежуточных вычислений. В препринте UT Austin, который не рецензирован и где числа получили сами авторы, задержка Llama-3.2-3B снизилась на 19%. Это даёт отдельный архитектурный вариант для команд, которым нельзя или невыгодно дообучать всю модель.
Как текстовые шаги заменили скрытыми векторами
Обычная модель рассуждает последовательно: пишет промежуточный токен, добавляет его в контекст и только после этого переходит к следующему. Такие цепочки помогают решать математику и задачи на логику, но каждый записанный шаг увеличивает задержку и стоимость вывода.
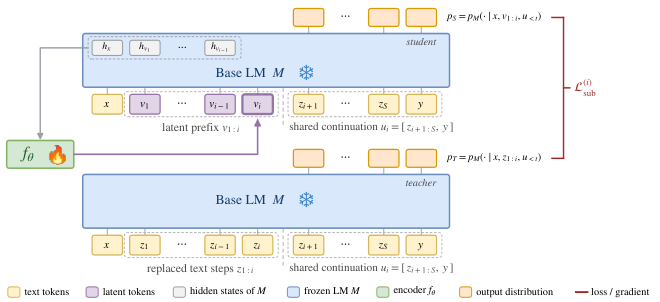
INTACT заменяет начало этой цепочки латентным рассуждением. Вместо текста небольшой внешний энкодер создаёт набор непрерывных векторов, которые базовая модель воспринимает как часть входного контекста. После скрытого префикса модель снова переходит к обычному тексту, дописывает оставшееся рассуждение и ответ.
Энкодер получает не только исходный вопрос, но и внутренние представления, которые вернула базовая модель. Он строит префикс последовательно: добавляет блок, снова пропускает расширенный контекст через модель и использует новые внутренние состояния для следующего блока. В итоговом префиксе 16 векторов, а сам энкодер содержит 107 миллионов обучаемых параметров.
Обучение проходит в два этапа. Сначала энкодер учится заменять скрытым блоком один письменный шаг за другим. Его выход должен влиять на продолжение почти так же, как исходный текстовый ход решения. Дополнительное условие не даёт скрытому префиксу слишком далеко увести поведение модели от версии без вмешательства.
Затем энкодер дообучают по правильности конечного ответа. Для одного вопроса модель создаёт несколько вариантов решения, после чего награда усиливает те скрытые префиксы, которые привели к верному результату. Градиенты проходят через базовую модель, но меняют только энкодер.
Точность выросла вместе с сокращением вывода
На GSM8K точность одной из моделей Llama выросла с 75,8% до 79,3%. На самой крупной Llama прибавка составила 11,3 процентного пункта. Улучшения появились не только на знакомом наборе задач, но и на SVAMP, GSM-Hard и MultiArith, которые не входили в математическое обучение.
Отдельный энкодер обучили на смеси математики, естественных наук и кода, а затем без настройки под конкретные тесты проверили в нескольких областях. Средний результат на задачах здравого смысла вырос на 19 процентных пунктов, хотя таких примеров в обучающей смеси не было. Контроль с одинаковым для всех вопросов префиксом уступил варианту, который строит векторы из содержания вопроса: эффект нельзя свести только к выученной инструкции или формату ответа.
INTACT также обошёл проверенные в работе методы латентного рассуждения на более крупных моделях. При этом сравнение не означает, что скрытые вычисления полностью заменили текстовую цепочку: после префикса модель продолжает писать решение авторегрессионно. Метод сокращает наиболее раннюю часть рассуждения, а не убирает её целиком.
Замороженная модель становится практическим вариантом архитектуры
Метод проверили на четырёх базовых моделях семейств Llama и Qwen размером от одного до восьми миллиардов параметров. Математический вариант обучали на GSM8K-Aug и сравнивали с неизменённой моделью, обычным дообучением и другими способами скрытого рассуждения. Многопредметный вариант проверили на двенадцати наборах по математике, естественным наукам и здравому смыслу.
Работа меняет планы прежде всего там, где базовую модель требуется сохранить. Например, команда может не иметь ресурсов для полного дообучения, поддерживать одну проверенную версию весов или хотеть быстро отключать экспериментальный слой. Удаление энкодера в такой схеме возвращает исходное поведение модели, потому что её параметры не менялись.
Цена этого решения — отдельный энкодер и несколько дополнительных проходов базовой модели перед генерацией ответа. Поэтому сокращение числа выходных токенов не превращается автоматически в такое же сокращение времени работы. Выигрыш зависит от длины вопроса, оборудования, пакетной обработки и того, какую долю цепочки удалось перенести в скрытый префикс.
Для внедрения потребуется обучать свой энкодер под каждую базовую модель: он читает её внутренние состояния и не служит универсальным модулем для разных LLM. Скрытые блоки также нельзя напрямую прочитать как обычные шаги решения. Если продукт требует аудита рассуждений, INTACT оставляет меньше проверяемого текста и не заменяет отдельные механизмы контроля.
Практический вывод узкий: INTACT не делает полное дообучение ненужным, но показывает работающий промежуточный путь. Когда веса трогать нельзя, а задержка длинных рассуждений уже мешает продукту, небольшой обучаемый слой можно оценивать наряду с сокращением подсказок, более короткими ответами и переходом на другую модель.
Источники
Иллюстрация: рисунок из статьи «INTACT: Inducing Latent Reasoning on a Frozen Backbone», Kutay Tire, Atula Tejaswi, Haris Vikalo и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


