
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
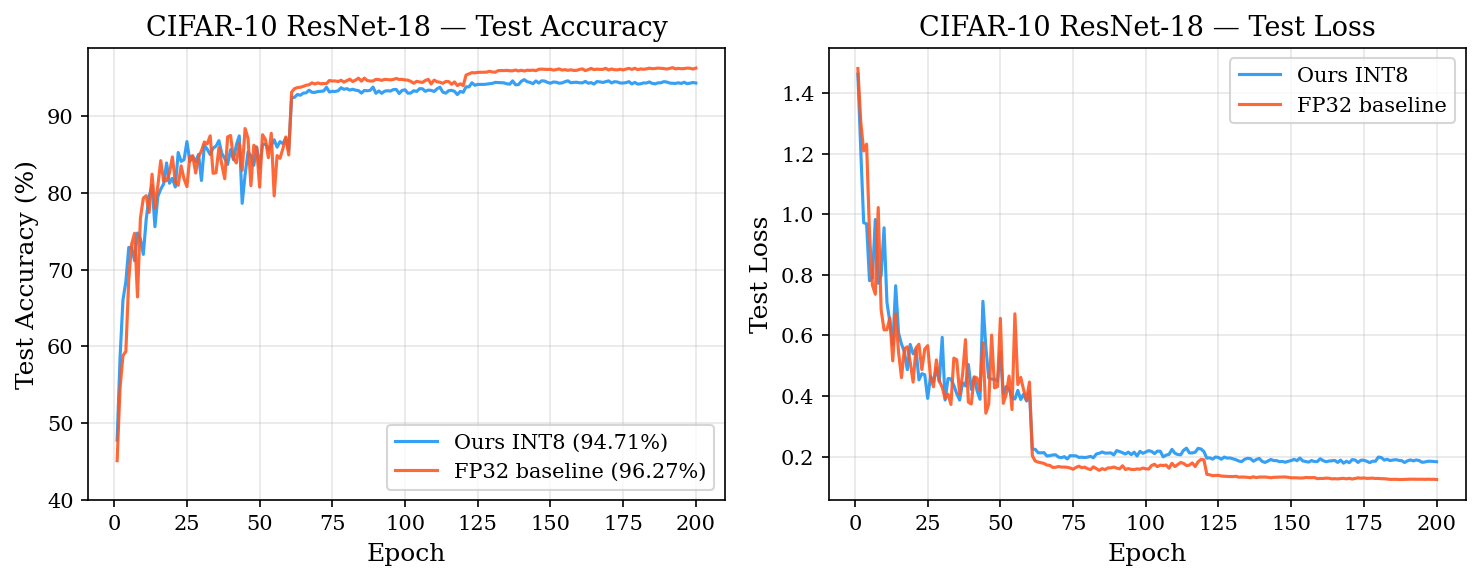
Глубокие нейросети уровня ResNet и ViT удалось обучать без операций с плавающей точкой на любом этапе. На ImageNet обучение ResNet-50 потребовало 5,20 ГБ вместо 20,82 ГБ, а точность классификации составила 76,4% против 76,7% у FP32. Хотя препринт не рецензирован и все числа получили сами авторы, результат показывает практический путь к обучению при жёстком лимите памяти или полном отсутствии поддержки плавающей точки.
Точность хранится в показателях степени
Команда Politecnico di Milano хранит каждый постоянный тензор как целочисленную мантиссу INT8 и отдельный показатель степени двойки. Реальное значение получается умножением мантиссы на эту степень: небольшое целое число отвечает за значащие цифры, а показатель задаёт масштаб всего тензора.
Веса, градиенты, активации и состояние оптимизатора остаются в INT8. Умножения и суммы временно накапливаются в INT32, после чего результат сдвигают по битам и снова упаковывают в INT8. Степени двойки позволяют менять масштаб целочисленным сдвигом, без промежуточного перехода к FP32.
Правый сдвиг теряет младшие биты, поэтому алгоритм применяет случайное округление (stochastic rounding). Оно выбирает соседнее целое с вероятностью, которая зависит от отброшенной части, и не даёт малым обновлениям систематически превращаться в ноль. На ResNet-18 замена такого округления обычным снизила точность на 5,4 процентного пункта — это не вспомогательная оптимизация, а необходимая часть обучения.
Свёртки и линейные слои собираются из целочисленных произведений, сумм и деления на константу. Softmax, GELU и их производные авторы заранее записывают в таблицы значений: во время обучения слой находит результат по целой мантиссе и показателю степени. Так ViT выполняет внимание, нормализацию и обратное распространение без скрытого возврата к плавающей точке.
Отдельная проблема возникает в оптимизаторе. Градиенты разных выходных каналов могут различаться по масштабу, и один общий показатель степени обнулит самые слабые из них. Алгоритм хранит для каждой группы каналов свой масштаб буфера импульса; дополнительные показатели занимают менее 0,1% памяти типичного слоя. После обновления веса автоматически сдвигаются так, чтобы мантисса не переполнялась и использовала доступный диапазон INT8.
Экономия памяти зависит от архитектуры
Метод проверяли на семействах ResNet, MobileNetV2 и ViT. В эксперименты вошли CIFAR-10, CIFAR-100 и ImageNet, обучение с нуля и дообучение готовой модели. Во всех случаях использовали стохастический градиентный спуск с импульсом и заранее рассчитанным изменением шага обучения.
На ResNet результаты ближе всего к FP32: для ResNet-18 на ImageNet разрыв составил 1,2 процентного пункта. При этом постоянные тензоры занимают примерно четверть памяти исходного варианта, поэтому в тот же объём помещается более глубокая сеть или больший пакет примеров.
Архитектура влияет на потери качества. MobileNetV2 на CIFAR-10 уступил FP32 на 3,2 процентного пункта. В этой сети глубинные свёртки дают мало весов на канал, а последовательные блоки требуют частой повторной упаковки значений в INT8; оба свойства усиливают ошибки округления.
Проверка охватывает современные модели компьютерного зрения, но не обучение языковых моделей. ViT также обычно обучают через Adam или AdamW, тогда как текущая реализация поддерживает только SGD с импульсом. Для целочисленного Adam понадобятся квадратные корни, деление и дополнительное согласование масштабов.
Когда работа меняет технический план
Подход меняет расчёт для систем, где обучение упирается в память, а не только в скорость вычислений. Это сервер с ограниченной памятью ускорителя, специализированный целочисленный ускоритель или устройство, на котором плавающая точка недоступна. В таких условиях FP32-состояние оптимизатора перестаёт быть обязательной платой за полноценное обучение.
Перенос потребует собственной реализации операций, таблиц нелинейных функций, случайного округления и управления показателями степени. Обычная замена типа данных в существующем фреймворке такого результата не даст: масштаб приходится отслеживать при каждом сложении, обновлении веса и объединении потоков градиента.
Работа сопоставляет точность и расход памяти, поэтому по ней нельзя закладывать ускорение обучения или снижение энергопотребления на конкретном GPU. Для обычного серверного продукта разумный следующий шаг — проверить метод на целевой архитектуре и оценить стоимость собственных целочисленных ядер. Для команд, которым необходимы AdamW, LLM или обучение через LoRA, вывод пока уже: INT8-состояние оптимизатора выглядит достижимым, но готового подтверждения для этих сценариев работа не даёт.
Источники
Иллюстрация: рисунок из статьи «Memory-Efficient Integer-Only Training of Deep Neural Networks», Hazem Hesham Yousef Shalby, Fabrizio Pittorino, Manuel Roveri, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


