
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Автопилот научили отбрасывать траектории, которые выглядят выгодными сами по себе, но плохо сочетаются с поведением соседних машин в дорожных записях. В работе KTH метод ICDP превзошёл обычное обучение с подкреплением на готовых данных в обоих реактивных тестах nuPlan; препринт не рецензирован, а все числа получили сами авторы. Командам, которые улучшают планировщик на записанных поездках, предлагают контролировать не только действия своей машины, но и всю дорожную сцену.
Почему знакомой траектории своей машины недостаточно
Обучение с подкреплением на готовых данных (offline RL) улучшает стратегию по заранее собранным поездкам, не отправляя новую версию автопилота исследовать дорогу. Модель выбирает траектории с высокой ожидаемой наградой, а критик оценивает их долгосрочную пользу.
Проблема возникает, когда критик получает траекторию, которая редко встречалась в обучающих данных. Его оценка становится ненадёжной, поэтому существующие методы удерживают планировщик рядом с записанным поведением собственной машины. Такая близость называется поддержкой: чем чаще похожее действие встречалось в данных, тем меньше модели приходится экстраполировать.
Для дорожного движения этого условия мало. Перестроение может часто встречаться в записях и потому иметь хорошую поддержку само по себе. Но оно может плохо сочетаться с конкретной траекторией автомобиля в соседнем ряду, которую система видит в текущем фрагменте.
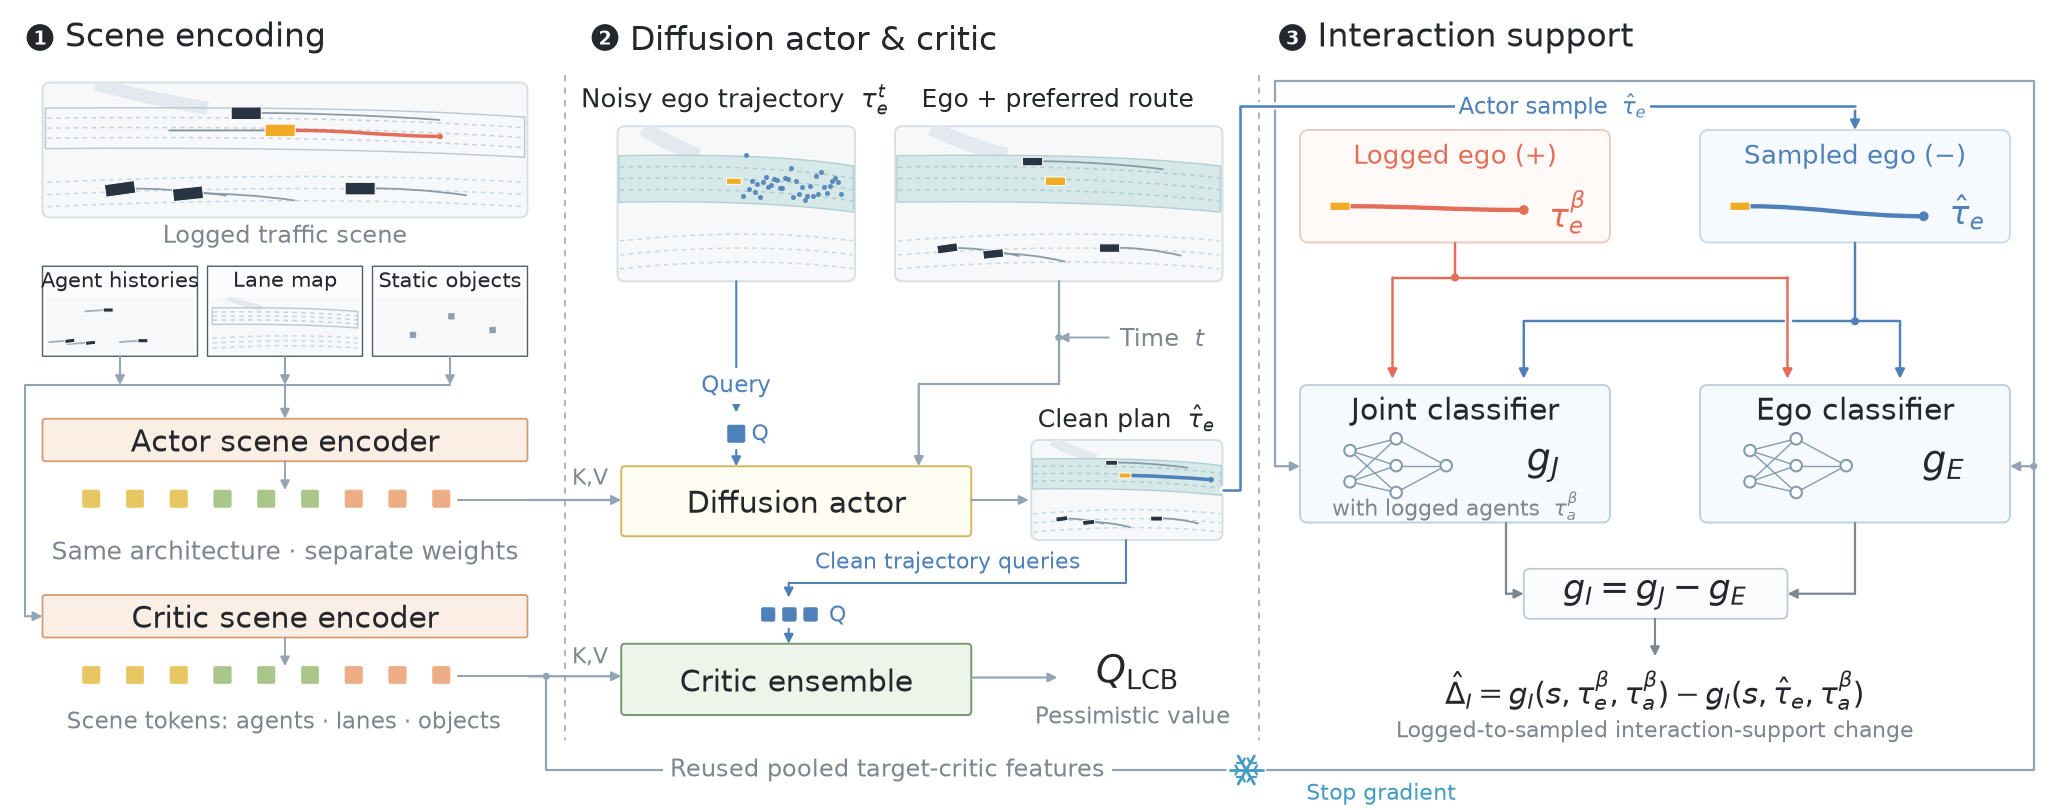
ICDP разделяет потерю совместной поддержки на две части. Первая показывает, насколько новая траектория своей машины отличается от записанных. Вторая показывает, насколько правдоподобно её сочетание с движением окружающих машин. Эту вторую часть авторы называют сдвигом распределения взаимодействий.
Чтобы измерить его, система обучает два классификатора. Один отличает записанные совместные траектории от сочетаний с новой траекторией своей машины. Другой решает ту же задачу, но не видит движение соседей. Разность их оценок убирает эффект необычности самой траектории и оставляет сигнал о взаимодействии.
При этом ICDP не предсказывает ответ каждого участника движения и не разыгрывает сцену в симуляторе во время оптимизации. Он проверяет, встречалось ли похожее сочетание траекторий в данных. Это проверка статистической совместимости, а не модель причинной реакции другого водителя.
Ограничение взаимодействий помогло в реактивной симуляции
ICDP строит кандидатов с помощью диффузионной модели, оценивает их ансамблем критиков и занижает итоговую ценность там, где оценки расходятся. Затем к целевой функции добавляются два штрафа: за отход от поведения своей машины в данных и за потерю поддержки взаимодействия.
В контролируемом сравнении использовались одинаковые архитектура и обучающие данные. На сложной части nuPlan реактивная оценка выросла с 70,07 у обучения без ограничения взаимодействий до 72,87 у ICDP. На случайной части того же теста результат поднялся с 83,02 до 86,34.
Реактивный режим здесь существеннее обычного воспроизведения записей: окружающие машины отвечают на действия автопилота. Именно в нём добавленная проверка дала наиболее последовательный выигрыш. В нерективных режимах обычное обучение с подкреплением улучшало исходную модель не всегда.
Метод проверяли в замкнутом контуре на nuPlan и InterPlan. Его также запускали на полноразмерном автономном грузовике на заснеженной трассе: в работе показаны обгон, движение за ведущей машиной и прохождение поворотов. Эти поездки дают качественную проверку работоспособности, тогда как численное сравнение методов относится к симуляторам.
Когда подход меняет архитектуру проекта
Работа меняет планы команд, которые обучают планировщик на фиксированных журналах и оптимизируют его по награде. Ограничивать только отклонение собственной машины от демонстраций уже недостаточно: в критерий отбора кандидатов стоит добавить совместимость с наблюдаемым поведением окружения.
Для внедрения ICDP нужны синхронизированные будущие траектории своей машины и соседних участников в обучающих фрагментах. Понадобятся отдельный модуль оценки поддержки взаимодействия, единый набор отрицательных примеров для обоих классификаторов и доступ к чистой траектории, которую предлагает генеративный планировщик.
Подход особенно уместен там, где контрфактические ответы других участников нельзя дёшево получить из симулятора или мировой модели. Он использует уже записанные взаимодействия и потому не добавляет реактивные прогоны в цикл оптимизации.
ICDP не превращает журнал поездок в доказательство безопасности для новых сцен. Он лишь снижает вероятность того, что оптимизатор выберет высоко оценённую комбинацию, слабо представленную в данных. Поэтому метод дополняет реактивные испытания и проверку редких сценариев, а не заменяет их.
Практический вывод шире автономного вождения. Если одна обучаемая система действует среди других участников, поддержка отдельного действия может скрывать необычное совместное состояние. Тогда ограничение нужно строить на уровне взаимодействия, даже если остальные участники не управляются обучаемой моделью.
Источники
- Beyond Policy Support: Interaction Constrained Offline Reinforcement Learning for Autonomous Driving
Иллюстрация: рисунок из статьи «Beyond Policy Support: Interaction Constrained Offline Reinforcement Learning for Autonomous Driving», Mahmoud Selim, Cristina Cipriani, Karl Henrik Johansson, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


