
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Замороженные языковые модели научились передавать друг другу вычисленное внутреннее состояние без текстового пересказа. В препринте MIT и IBM Research, который не проходил рецензирование и содержит замеры самих авторов, чужой KV-кэш достиг точности чтения исходного документа при добавлении, а активации лучше сработали при прямой замене. Для архитектуры системы это означает не единый внутренний канал, а два разных интерфейса.
Два носителя требуют противоположного подключения
Обычная система из нескольких агентов передаёт результаты текстом. Модель-источник превращает вычисленное состояние в слова, а модель-получатель читает их и заново строит собственное представление контекста. Часть информации теряется при генерации, а повторное чтение требует вычислений.
Авторы предлагают перейти от попарной передачи к общему пулу. Каждый агент один раз публикует внутреннее состояние (internal state), а остальные читают его через общий механизм. При добавлении агента не приходится обучать отдельный мост между ним и каждым участником системы.
Работа сравнивает два носителя. KV-кэш хранит ключи и значения, которые механизм внимания построил при чтении контекста. Активации — это скрытые векторы, которые переходят между блоками трансформера.
Для каждого носителя проверили два способа подключения. При замене чужое состояние занимает место собственного состояния получателя. При добавлении модель сохраняет своё состояние и получает ещё один источник данных: отдельный механизм внимания читает KV-кэш отправителя либо его активации прибавляются к остаточному потоку.
Эта матрица меняет постановку задачи. Полезность состояния определяет не только его сходство с исходным, но и операция, которая будет его читать. Поэтому один способ подключения не подходит обоим носителям.
KV-кэш не переносит замену, а активации — добавление
Эксперимент построили на переносе коротких фактов из SQuAD. Модель-источник Qwen2.5-1.5B читала полный отрывок, а замороженная модель-получатель — тот же текст с удалённым ответом. Переданный объект считали полезным, если правильный ответ появлялся в генерации и результат нельзя было объяснить копированием видимого фрагмента.
Проверки включали состояние от другого примера, вставку в неверную позицию и разделение ответов между обучающими и проверочными данными. Эти варианты отсекали механизмы, которые игнорируют источник или запоминают ответы вместо передачи факта.
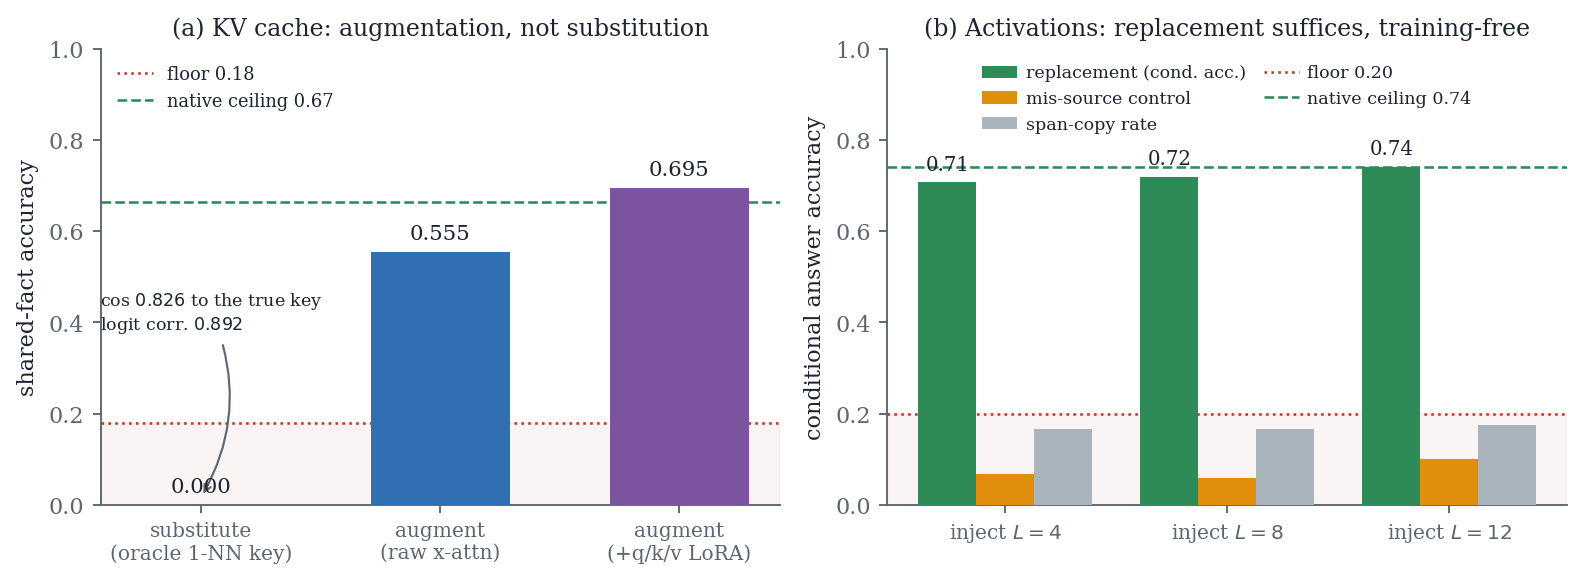
Полная замена KV-кэша ближайшими настоящими ключами, ранее созданными тем же получателем, дала 0% точности. Даже геометрически почти совпадающий кэш менял конкуренцию ключей внутри нормализации внимания: запрос начинал выбирать другие фрагменты контекста.
Добавление с небольшим адаптером на стороне запросов дало 69,5% против 66,5% при чтении исходного документа. Разницу нельзя считать улучшением из-за единственного запуска, но механизм достиг уровня собственного кэша модели, не заменяя его.
У активаций картина обратная. Прямая запись активаций источника в остаточный поток совпала с собственным ориентиром модели — 74,2%. Добавление тех же данных достигло только 43,8%: оно отклоняло состояние получателя, но не устанавливало вычисленное источником представление.
Абсолютные результаты двух носителей нельзя сравнивать между собой: для них использовались разные ориентиры и варианты метрики. Содержательный результат находится внутри каждого сравнения: KV-кэш выдерживает добавление, а активации — замену.
Менять архитектуру стоит только внутри совместимого семейства
Для прототипа из замороженных моделей одной семьи работа даёт практическое правило. Чужой KV-кэш стоит подключать как дополнительную память и адаптировать запросы получателя. Перезаписывать им собственный кэш не стоит, даже если ключи выглядят почти идентичными.
Активации можно записывать напрямую, но эксперимент заранее знал слой и позиции токенов, куда их следует поместить. Это измерение показывает, что правильно выровненное состояние модель способна использовать без обучения. Сам способ найти такое место для произвольного сообщения работа не даёт.
Граница совместимости узкая. Провал замены кэша воспроизвели на семи получателях из трёх семейств, однако положительные результаты получили внутри одного семейства. Передача между Qwen и GPT-Neo не сработала ни для кэша, ни для активаций. Общий адаптер принимал состояния от незнакомых отправителей только тогда, когда они оставались близки к состояниям получателя.
Пул из нескольких источников тоже не превращает опыт в готовую многоагентную систему. Проверка моделирует поиск одного факта, а не планирование, критику или длинный рабочий процесс. Из точности канала также нельзя вывести экономию: эксперимент не учитывает вычисления получателя, пропускную способность и память для общего пула.
Работа меняет планы команд, которые контролируют внутреннее выполнение моделей и собирают агентов на совместимых весах. Им имеет смысл разделить интерфейсы для KV-кэша и активаций уже на уровне прототипа. Для систем из разнородных моделей результат пока задаёт направление эксперимента, но не заменяет текстовый обмен.
Источники
Иллюстрация: рисунок из статьи «Augment the Cache, Replace the Activation: A 2x2 Study of Internal-State Sharing», Adam Deng, Shicheng Liu, Yada Zhu, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


