
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Модель научили убирать лишние шаги рассуждения, не сокращая всю цепочку одинаково. В препринте Harbin Institute of Technology, University of Aberdeen и University of Cambridge, который не проходил рецензирование и содержит замеры самих авторов, метод IGPO уменьшил среднюю длину ответа до 62% и повысил точность до 8,4 процентного пункта относительно базовой модели. Для команд, которые дообучают собственные модели, это предлагает более точную замену общему штрафу за длинный ответ.
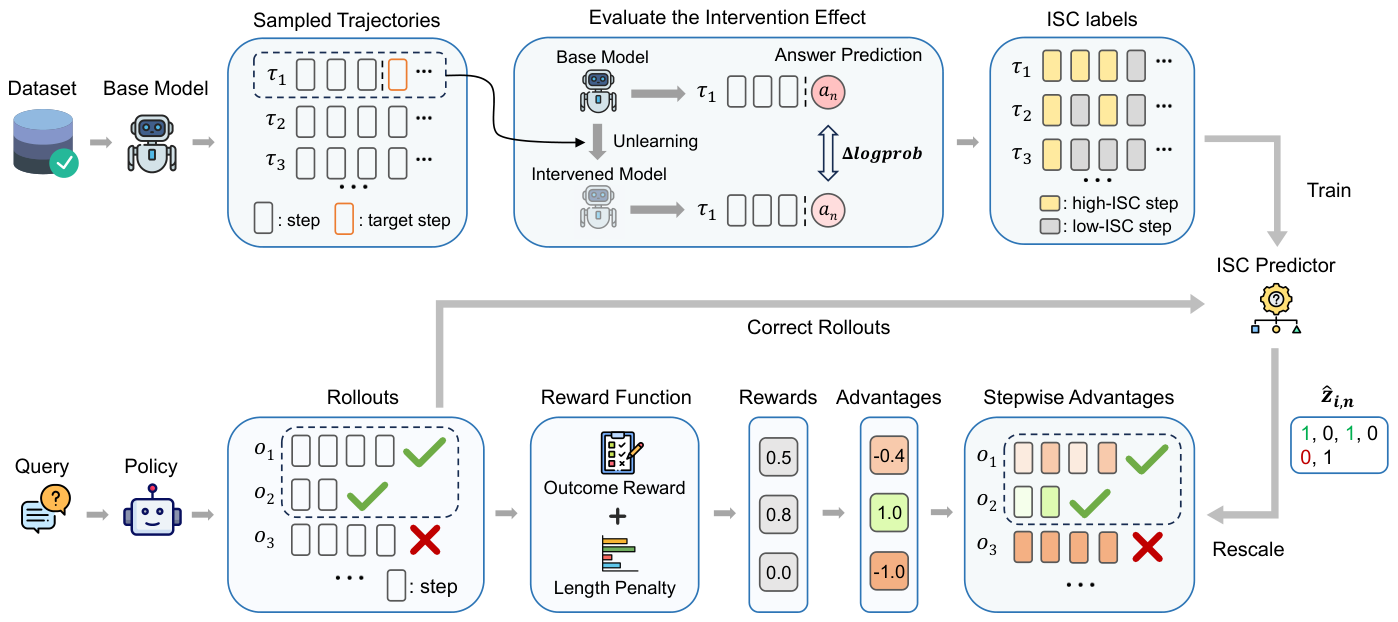
Вклад шага проверяют вмешательством в модель
Обычные способы ищут лишние шаги по косвенным признакам: вниманию модели, уверенности в следующем токене или энтропии генерации. Но необычный или неуверенно сформулированный шаг может оказаться необходимым, а уверенный — повторять уже известное.
Предложенный показатель ISC оценивает не внешний вид шага, а зависимость ответа от него. Для выбранного шага модель временно дообучают так, чтобы она хуже воспроизводила этот шаг после предшествующего текста. Остальное поведение удерживают близким к исходной модели с помощью дополнительного штрафа при обучении.
После вмешательства модель не продолжает рассуждение заново. Исследователи фиксируют предшествующий текст и ответ, затем сравнивают, насколько уверенно исходная и изменённая модели оценивают токены этого ответа. Чем сильнее меняется уверенность, тем выше вклад шага.
Такой порядок нужен, чтобы модель не обошла вмешательство: при новой генерации она могла бы восстановить пропущенную мысль другим способом. ISC измеряет изменение при неизменном контексте, поэтому ближе подходит к вопросу «нужен ли этот шаг для ответа», чем показатели поведения модели.
Для обучения IGPO дорогие вмешательства выполняют заранее. Полученные метки используют, чтобы обучить отдельный классификатор отличать важные шаги от малозначимых. Во время обучения с подкреплением классификатор уже работает без создания отдельной версии модели для каждого шага.
IGPO меняет обучающий сигнал избирательно. В правильных решениях он слабее поощряет малозначимые шаги и защищает важные от штрафа за длину. Ошибочные решения получают обычный сигнал целиком, чтобы сокращение не мешало исправлять сам ответ.
Короткие ответы сохранили точность на математике
На DS-7B средняя длина ответа по математическим задачам снизилась с 6557 до 2491 токена. Средняя точность одновременно выросла с 69,4% до 73,9%. Это отличает IGPO от простого ограничения бюджета: модель не только раньше останавливается, но и реже воспроизводит промежуточные действия, которые почти не влияют на результат.
За пределами обучающей области ответы стали короче на 35,3–61,2% на LiveCodeBench-v6, GPQA-Diamond и MMLU. Точность младшей модели выросла на всех этих наборах, а у старшей в основном сохранилась; исключением стал GPQA-Diamond, где результат немного снизился.
Работу проверяли на DeepSeek-R1-Distill-Qwen-1.5B и DeepSeek-R1-Distill-Qwen-7B. Обучение шло на математическом наборе DeepScaleR, а оценка охватила девять наборов задач по математике, программированию и естественным наукам. Среди сравнений были методы, которые штрафуют длину всего ответа, и методы, которые оценивают отдельные шаги по вниманию или энтропии.
Дополнительная проверка с удалением шагов показала, что ISC лучше сохраняет правильный ответ при агрессивном сокращении цепочки, чем оценки по вниманию и энтропии. Модель-оценщик ReasonEval-7B также находила в сокращённых рассуждениях меньше повторов, хотя такая автоматическая оценка сама зависит от качества выбранного оценщика.
Метод меняет план обучения, но не архитектуру продукта
IGPO имеет смысл рассматривать, если команда управляет параметрами модели, уже использует обучение с подкреплением и платит заметную цену за длинные рассуждения при массовом запуске. Метод встраивается в обучение политики: архитектуру основной модели и формат её ответа менять не требуется.
Для модели, доступной только через API, подход напрямую не применить: ISC требует временно менять параметры. Он также не заменяет сокращение контекста, кэширование и выбор меньшей модели, поскольку уменьшает именно сгенерированную цепочку рассуждений.
Основная практическая цена возникает до обучения. Каждый размечаемый шаг требует отдельного вмешательства в параметры, а затем эти результаты нужно перенести в классификатор. Авторы показывают этот процесс на задачах с проверяемым правильным ответом; для открытых диалогов и рабочих процессов сначала понадобится надёжный критерий результата.
Есть и методическая граница: временное забывание шага лишь приближает вмешательство во внутреннее вычисление модели. Поэтому ISC стоит воспринимать как обучающий сигнал, который улучшил соотношение точности и длины в проведённых опытах, а не как точное объяснение того, как модель получила ответ.
Источники
Иллюстрация: рисунок из статьи «Learning to Reason Efficiently with Interventional Step Credit», Guanda Li, Xuefeng Bai, Yulong Chen и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


