
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Компактную модель научились лучше сохранять качество учителя на данных, которые отличаются от обучающих. В препринте Dileesha Kannangara и Sanghamitra Dutta, который не прошёл рецензирование и где все числа получили сами авторы, метод IWD улучшил средний результат на задачах вопросов и ответов почти на 15 процентных пунктов относительно обычной дистилляции. Для команд это превращает устойчивость к смене данных из проверки после обучения в часть самой дистилляции.
Как устойчивость ответа превращается в вес примера
При дистилляции небольшая модель-ученик повторяет распределение ответов более крупной модели-учителя. Обычная схема одинаково учитывает все обучающие примеры, поэтому ученик перенимает как полезные закономерности, так и случайные связи: характерные слова, длину фразы, регистр или привычное положение ответа.
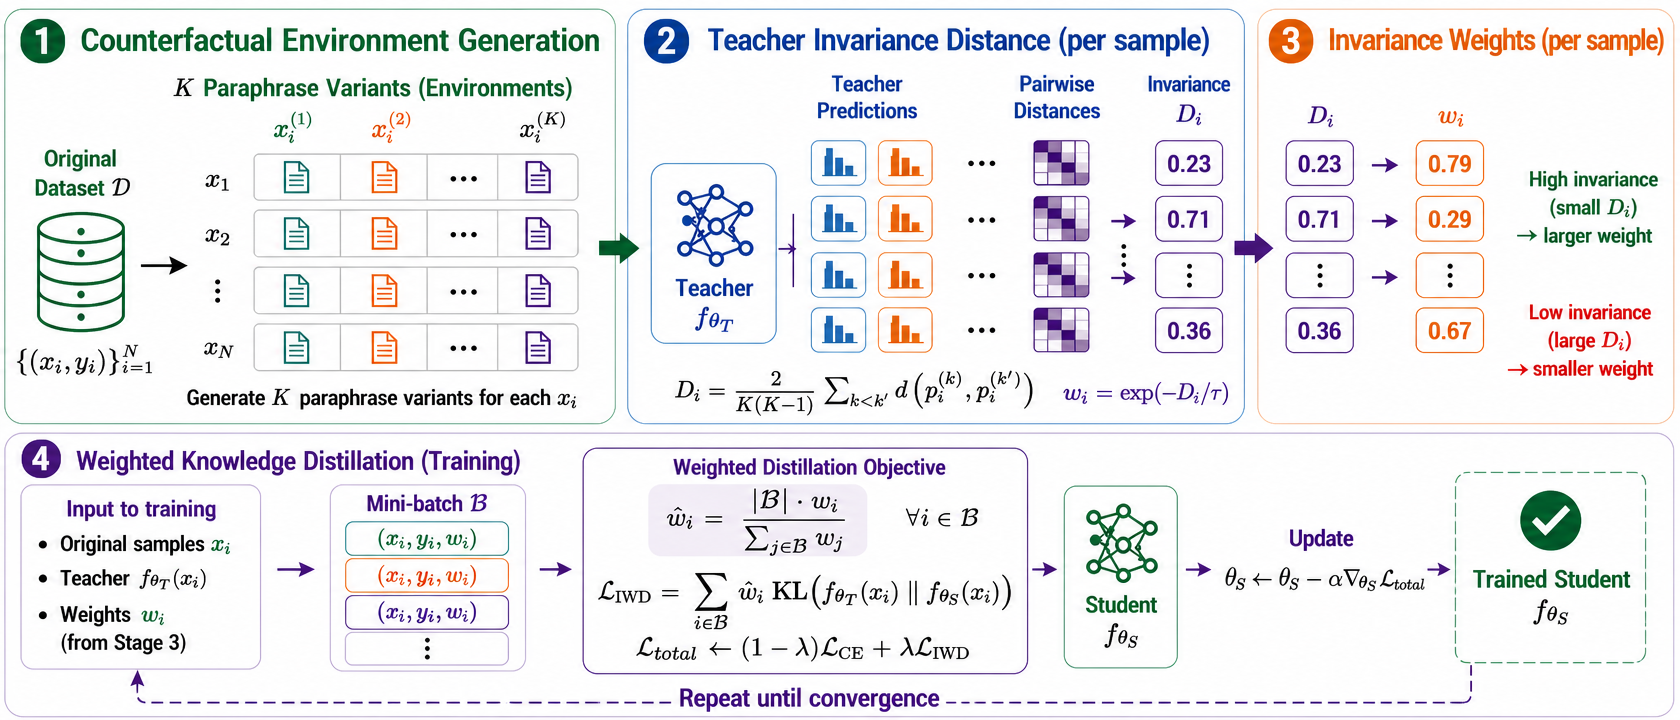
IWD сначала создаёт для каждого примера несколько перефразированных вариантов. GPT-4.1-mini меняет стиль, синтаксис, лексику, регистр и длину, но должен сохранять исходный смысл и правильную метку. Варианты, которые меняют метку, отбрасывают.
Затем учитель обрабатывает исходный пример и все его варианты. Если ответы почти не меняются, IWD считает такой пример надёжным: вероятнее, учитель опирается на смысл, а не на поверхностную подсказку. Если ответы расходятся, влияние учителя на обучение уменьшается.
Расхождение измеряют в пространстве, подходящем задаче. Для классификации сравнивают распределения вероятностей по меткам. Для извлечения ответа и распознавания сущностей сопоставляют уже декодированные фрагменты текста и наборы сущностей. Это важная инженерная деталь: единое сравнение по токенам добавляет шум, особенно для Qwen-2.5, где одинаковый смысл можно выразить разными последовательностями.
Вес примера экспоненциально уменьшается вместе с расхождением ответов учителя. Внутри каждой мини-выборки веса нормализуют, чтобы их среднее оставалось постоянным и не меняло фактический темп обучения. Ученик при этом продолжает учиться на правильных метках, а нестабильный сигнал учителя получает меньший вес.
Метод не требует менять архитектуру ученика, добавлять отдельную классификационную голову или проводить состязательное обучение. Дополнительная работа возникает до дистилляции: нужно сгенерировать варианты, проверить сохранение меток и несколько раз запустить учителя.
Где взвешивание помогло, а где оказалось лишним
IWD проверяли на MNLI, SQuAD-v2, CoNLL-2003 NER и SST-2 в семействах DeBERTa-v3 и Qwen-2.5. Они охватывают распознавание логического следования, извлечение ответа, поиск именованных сущностей и анализ тональности. Результаты сравнивали с обычной дистилляцией, обучением на дополненных данных и другими вариантами переноса знаний.
На логическом следовании средний результат вне обучающего распределения вырос на 4,34 процентного пункта, а на вопросах и ответах — на 14,94 пункта. IWD занял первое место в 15 из 16 проверок вне распределения. Наибольший эффект возник там, где обычная модель могла использовать положение ответа или лексические совпадения.
На тональности исходная дистилляция уже хорошо переносилась между наборами данных, поэтому прибавка оставалась небольшой. Это отделяет полезный сценарий от формального: взвешивание нужно не любой компактной модели, а задачам с известными поверхностными подсказками и заметной сменой входных данных.
Улучшение вне распределения иногда снижало качество на исходных данных. На SQuAD-v2 у DeBERTa-v3 дополнение данных и IWD уступили обычной дистилляции примерно на 19 пунктов. Авторы связывают это с тем, что перефразирование смещает обучающую выборку от исходного формата задачи.
Проверка охватывает модели для классификации и извлечения структурированного ответа. Она показывает результат для конкретных семейств и наборов данных, но ещё не устанавливает, как IWD поведёт себя при дистилляции универсального ассистента или обучении выполнению инструкций.
Когда IWD меняет план разработки
Работа меняет план, если компактную модель готовят для потока, который отличается от обучающей выборки: другого домена, стиля документов или структуры запросов. В таком проекте недостаточно сравнить ученика с учителем на случайно отложенной части тех же данных. Нужна отдельная проверка на заранее определённых сдвигах.
Практический пилот можно построить вокруг трёх вариантов: обычной дистилляции, дистилляции на перефразированных примерах и IWD. Такое сравнение покажет, даёт ли эффект само разнообразие текстов или именно понижение веса нестабильных ответов учителя.
Метрику расхождения следует выбирать по конечному ответу. Для классификатора подходят вероятности меток, для извлечения фрагмента — совпадение строк или слов, для сущностей — совпадение наборов. Если измерять не то представление, устойчивый по смыслу учитель будет выглядеть нестабильным, а полезные примеры получат меньший вес.
IWD не стоит сразу делать основной схемой обучения там, где исходная модель уже устойчива. Сначала полезно измерить разрыв между обычной и сдвинутой проверочными выборками, затем оценить выигрыш вне распределения вместе с потерей на исходном формате. Работа даёт способ управлять этим компромиссом, но не устраняет его.
Источники
Иллюстрация: рисунок из статьи «Do Student LLMs Inherit OOD Robustness? Invariance-Weighted Distillation for Reliable Knowledge Transfer», Dileesha Kannangara, Sanghamitra Dutta, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


