
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для агентов глубокого поиска предложили схему, которая сохраняет компактную рабочую память вместо полной истории запросов. В препринте Zhejiang University и Tencent, который не проходил рецензирование и содержит замеры самих авторов, IterSynth-8B набрал в среднем 50,7 балла и обошёл лучший сопоставимый агент на 4,2 пункта. Схему можно проверить на существующей LLM без дообучения, а затем усилить отдельной процедурой обучения.
Планировщик ищет пробелы, синтезатор обновляет память
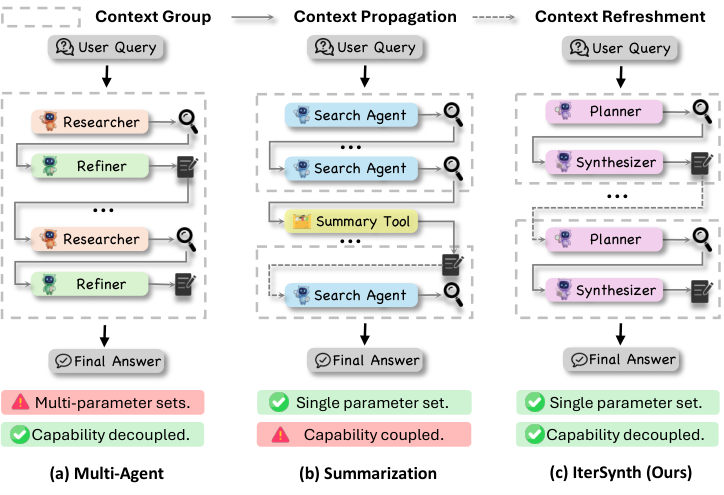
Обычный агент на основе ReAct складывает рассуждения, поисковые запросы, найденные документы и промежуточные выводы в один растущий контекст. На длинной задаче старые ошибки остаются перед моделью, полезные фрагменты теряются среди шума, а контекст заканчивается до появления ответа. В опытах из приложения больше 59% траекторий ReAct на BrowseComp не завершились в пределах контекста на 64 тысячи токенов.
IterSynth заменяет эту последовательность циклом из двух ролей. Планировщик видит исходный вопрос и текущую сводку, после чего формулирует новый поисковый запрос либо выдаёт окончательный ответ. Синтезатор получает найденные материалы, отбрасывает нерелевантные фрагменты, устраняет локальные противоречия и переписывает сводку.
Обе роли исполняет одна LLM с общими параметрами. Их разделяют инструкции, доступные данные и допустимые действия: планировщик не редактирует память, а синтезатор не запускает поиск и не завершает задачу. Перед каждым циклом рабочий контекст собирается заново из вопроса и обновлённой сводки.
Сводка здесь служит не периодическим сокращением истории, а состоянием всего процесса. Это принципиальное отличие от схем, где вспомогательный модуль время от времени сжимает накопленный контекст, но основная модель продолжает одновременно планировать, фильтровать источники и писать ответ.
Раздельная награда показывает, какая роль ошиблась
Сначала модель учат воспроизводить правильный порядок действий на готовых траекториях. Для этого авторы использовали Qwen3-8B и примеры, созданные Qwen3.5-397B-A17B в среде с живым поиском. Фильтр убирал траектории с неверным итоговым ответом, выдуманными рассуждениями и некорректными вызовами инструментов.
Затем применяется обучение с подкреплением (reinforcement learning). Итоговая правильность ответа передаётся всем шагам, а модель-оценщик отдельно проверяет действия планировщика и синтезатора по заданным критериям. RDPO сравнивает награды каждой роли только с наградами той же роли, поэтому частые хорошие обновления сводки не маскируют слабые поисковые решения.
Контролируемое дообучение дало средний результат 44,1 балла. Обычный GRPO, который опирался на конечный ответ, поднял его до 48,9, а раздельное распределение награды добавило ещё 1,8 пункта. Если использовать те же промежуточные оценки, но смешать роли при расчёте преимущества, результат падает до 47,2 балла: полезна не только подробная награда, но и её адресат.
Проверка охватывала пять задач длительного поиска: BrowseComp, BrowseComp-ZH, GAIA-text-only и две версии Xbench-DeepSearch. Сравнивали обученных агентов сопоставимого размера, более крупные системы и универсальные модели с поисковыми инструментами. Поэтому результат относится к многошаговому веб-поиску с накоплением свидетельств, а не ко всем сценариям генерации с поиском.
Сначала стоит поменять процесс, а не модель
Работа меняет планы команд, у которых агент уже упирается в длинную историю поиска. Разделение ролей не требует второй модели: достаточно двух инструкций, разных наборов действий и сводки, которая хранится между итерациями. Такую схему можно испытать поверх существующего поискового контура до подготовки обучающих данных.
Без обновления параметров IterSynth улучшил средний результат Claude-4.5-Opus относительно ReAct на 5,5 пункта, а DeepSeek-V3.1 — на 4,5 пункта. Это не доказывает, что схема одинаково сработает с любой LLM, но даёт практический порядок проверки: сначала сравнить процессы на собственных задачах, затем решать, окупится ли обучение.
Если команда всё же обучает агента, одной общей награды за финальный ответ недостаточно. Поисковые решения и обновления памяти создают разные типы ошибок, поэтому для них нужны отдельные оценки и отдельные базовые уровни при расчёте преимущества. Иначе удачный синтезатор может скрыть слабого планировщика, который собирает неподходящие источники.
Архитектурно сводка становится критической частью продукта. Её нужно хранить как явное состояние, проверять после каждого шага и передавать планировщику вместо полного журнала. Для короткого поиска это добавляет лишний цикл, но для длительных исследований даёт контролируемую точку, где можно увидеть потерянное свидетельство или преждевременный вывод.
Источники
Иллюстрация: рисунок из статьи «IterSynth: Rethinking Deep Search Agents via Role-Decoupled Iterative Synthesis», Xingyu Wu, Yuchen Yan, Zhengxi Lu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


