
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Для JEPA вывели условие, которое на старте отличает обучение полезных представлений от коллапса в одинаковый или низкоразмерный ответ. Хотя препринт не прошёл рецензирование и все числа получили сами авторы, найденная граница совпала с поведением более чем 800 конфигураций. Условие позволяет заранее оценивать риск неудачного обучения и выбирать устройство предсказателя не только перебором.
Как рост представлений конкурирует с затуханием
JEPA учится без разметки: кодировщик получает часть объекта, а предсказатель восстанавливает скрытое представление другой части. Отдельный целевой кодировщик задаёт ответ, к которому нужно приблизиться. Проблема в том, что одинаковое представление для всех объектов тоже может уменьшить ошибку, хотя для последующих задач оно бесполезно.
Работа рассматривает начало обучения рядом с полностью схлопнувшимся состоянием. В этой точке авторы линеаризуют совместную динамику основного и целевого кодировщиков и раскладывают её на спектральные моды — независимые направления, вдоль которых представление может расти или исчезать.
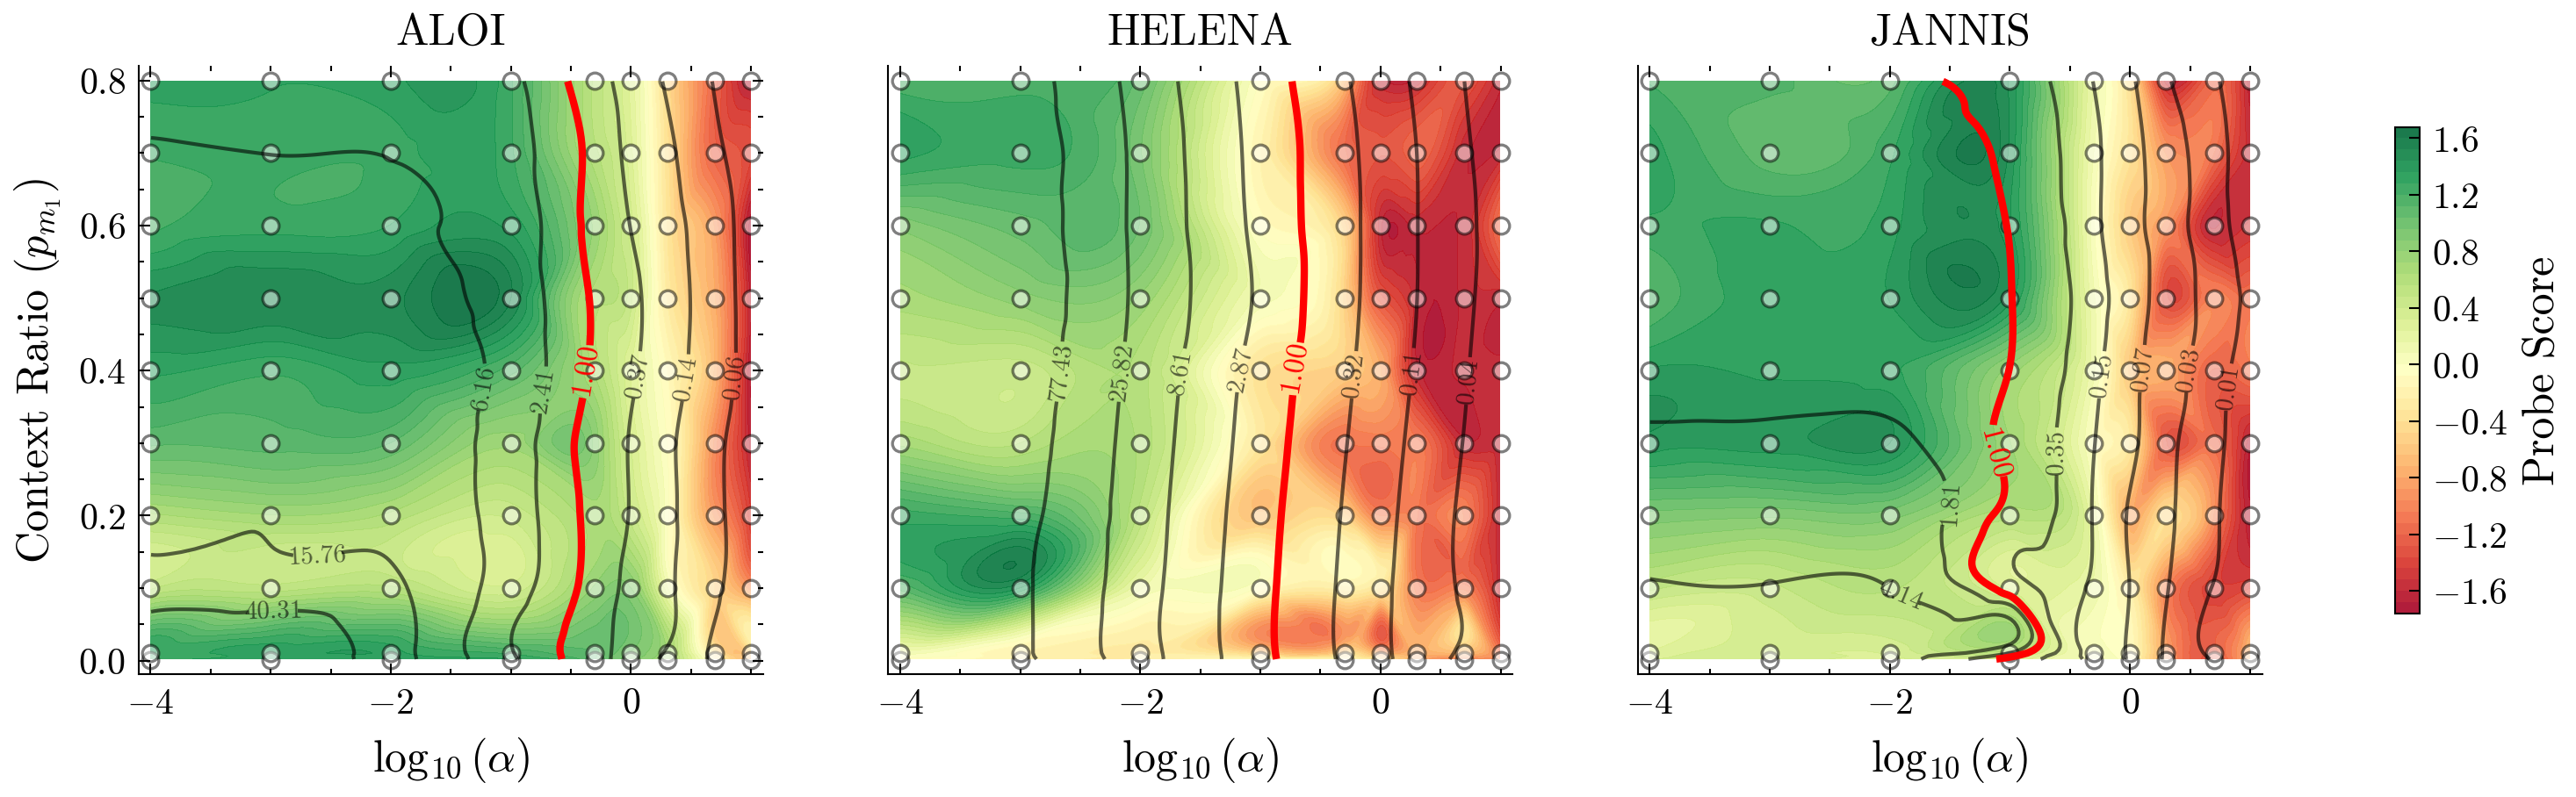
Для каждой моды действуют две силы. Движущая сила γ возникает из связи между видимой и целевой частями данных, а затухание σ — из геометрии предсказателя и ковариации входов. Их отношение μ = γ/σ задаёт фазовую границу: при μ > 1 направление уходит от схлопнувшегося состояния, при μ < 1 затухает.
Число направлений выше границы ограничивает будущий эффективный ранг представления. Эффективный ранг показывает, сколько независимых направлений действительно использует модель, причём почти пустые направления получают малый вес. Поэтому критерий предсказывает не только полный коллапс, но и частичный случай, когда модель сохраняет слишком мало признаков.
При приближённом разделении спектров μ распадается на два множителя. Первый зависит от данных и маскирования, второй — от предсказателя. Уменьшение начального масштаба весов предсказателя повышает μ, маскирование меняет сохранность сигнала между двумя представлениями, а экспоненциальное скользящее среднее для целевого кодировщика управляет скоростью выхода из неустойчивого состояния.
ResidualPred смещает старт в сторону обучения
Из анализа следует, что предсказателю полезно начинать близко к тождественному преобразованию: передавать каждое направление в основном само в себя, а не сразу смешивать признаки. На этой основе авторы собрали ResidualPred — трансформерный предсказатель, у которого внимание при инициализации смещено к диагонали. Архитектурная идея не новая сама по себе; новое здесь — её связь с фазовой границей JEPA.
На намеренно нестабильной конфигурации набора helena обычный предсказатель свёл точность линейной пробы к 8,6%, а ResidualPred поднял её до 21,3% и увеличил эффективный ранг во всех запусках. В коротком пилотном опыте на ImageNet ResidualPred также опередил регуляризатор SIGReg на 2,5 процентного пункта.
Границу проверяли на линейных Tabular-JEPA с наборами aloi, helena и jannis. Затем ResidualPred сравнили со стандартными предсказателями в T-JEPA и I-JEPA на семействах CIFAR, STL и ImageNet. Качество признаков измеряли линейной пробой: кодировщик замораживали и обучали поверх его представлений простой классификатор.
Теория точно описывает только раннюю динамику линейной модели и опирается на приближённое разделение спектров данных и предсказателя. Опыты с трансформерами показывают, что вывод переносится за пределы этой модели, но уже как эмпирическое правило. Запуски на ImageNet использовали ограниченный и одинаковый бюджет, а не полный официальный режим обучения I-JEPA.
Когда работа меняет план разработки
Для команды, которая уже стабильно обучает JEPA, работа не требует менять архитектуру. Она предлагает более содержательную диагностику: вместе с ошибкой обучения отслеживать эффективный ранг и проверять, сколько начальных мод оказывается выше фазовой границы. Низкая ошибка при падающем ранге тогда перестаёт выглядеть как успешная оптимизация.
При проектировании новой модели результат сокращает пространство перебора. Масштаб предсказателя, долю доступного контекста и скорость обновления целевого кодировщика можно рассматривать как связанные регуляторы одной динамики, а не как независимые гиперпараметры. Если расчёт указывает на затухание большинства мод, увеличение длительности обучения само по себе не устраняет причину.
ResidualPred стоит проверять там, где стандартный предсказатель регулярно даёт низкоранговые признаки или сильно зависит от начальных весов. Но он не служит общей гарантией: в глубоко подкритических табличных режимах выход из коллапса оставался частичным и зависел от запуска. Практический вывод работы — сначала сдвинуть начальную динамику в область роста, а затем уже сравнивать качество представлений на целевой задаче.
Источники
Иллюстрация: рисунок из статьи «Drive vs. Decay: On the Training Dynamics of Joint-Embedding Predictive Architectures», Jos\'e Lucas De Melo Costa, Seong Woo Ahn, Fabrice Popineau и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


