
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
В многоагентном конвейере значительную часть координации можно убрать из генеративных LLM без заметной потери качества. В не прошедшем рецензирование препринте числа получили сами авторы: Jev-LiteMAS сократил расход токенов генеративной LLM, сохранив точность на уровне сравниваемой системы. Для архитектуры это означает, что выбирать следующего агента и предварительно проверять результат может отдельная модель, если она видит накопленный контекст и умеет передавать сложные случаи обратно LLM.
Где координация расходует токены
В многоагентных системах LLM не только решают задачу. Они составляют план, выбирают следующего специалиста, проверяют промежуточные результаты и пишут рекомендации для исправления. При профилировании MetaGPT, AgentNet и LAS на задачах по математике и коду маршрутизация с проверкой заняли 31,7–43,5% токенов генеративной LLM.
Часть этих операций не требует свободного текста. Маршрутизатору достаточно вернуть идентификатор следующего агента или команду остановки, а первичной проверке — один из двух вердиктов: пропустить результат дальше либо отправить его на дополнительный разбор.
Прямая замена LLM на небольшую модель здесь ломает два интерфейса. Такая модель не создаёт подробный план и инструкции для передачи работы следующему агенту. Она также может обнаружить плохой результат, но не способна объяснить исполнителю, как его исправить.
Как Jev-LiteMAS сохраняет план и обратную связь
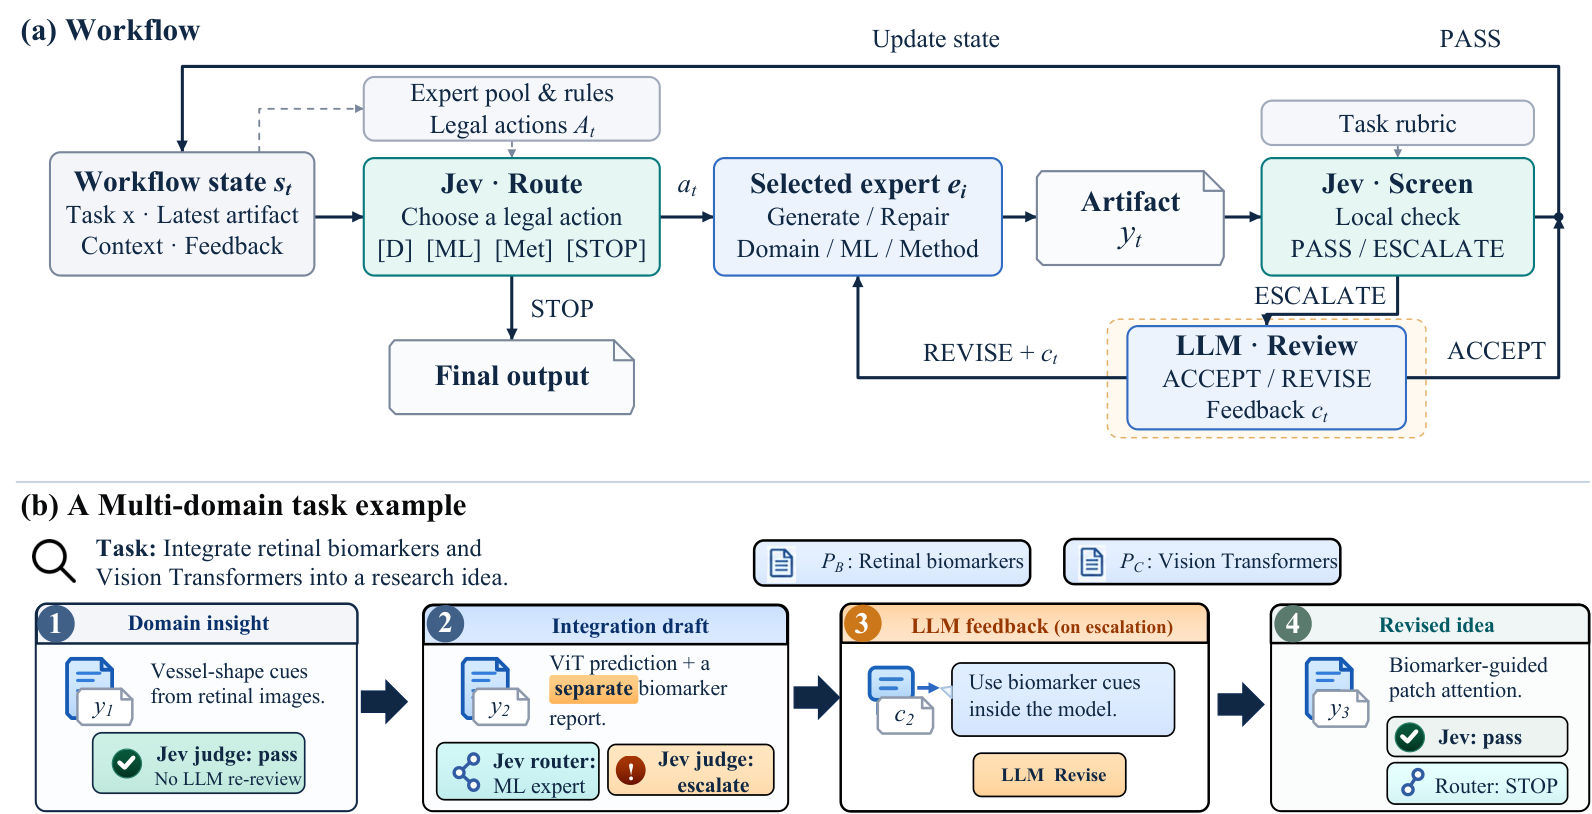
Jev-LiteMAS не строит полный маршрут заранее. После каждого шага Jev выбирает следующее действие из разрешённого набора, опираясь на исходную задачу, роли доступных агентов и уже созданные материалы. Выбранный агент получает накопленное состояние процесса (workflow state), выполняет содержательную работу и добавляет результат в общий контекст.
Такой порядок заменяет текстовый план последовательностью решений по фактическому состоянию работы. Если предыдущий агент написал код, провёл вычисление или подготовил проект ответа, маршрутизатор видит этот материал, а не только исходное задание. Поэтому следующий выбор учитывает то, что произошло в конвейере, а не предположение планировщика в начале выполнения.
Проверка устроена как каскад. Jev сначала сопоставляет промежуточный результат с критериями задачи. Успешный результат проходит дальше без вызова проверяющей LLM, а подозрительный поступает ей на повторную оценку. LLM либо принимает материал, либо пишет конкретные указания для исправления, после чего ответственный агент повторяет работу.
Ключевая деталь — Jev принимает ограниченные решения, но не заменяет генерацию там, где нужен новый текст. Эксперты по-прежнему решают задачу, а проверяющая LLM формулирует обратную связь. Экономия возникает за счёт рутинных переходов, а не за счёт переноса всей работы на меньшую модель.
Когда эту схему стоит закладывать в архитектуру
Систему проверили на MATH, MBPP+, API-Bank и IDRBench I3 с экспертами на DeepSeek-V4-Flash и GPT-5. Сравнением служила LAS — многоагентная система, которая меняет глубину обработки по ходу выполнения. Набор охватывает математику, генерацию кода, работу с инструментами и объединение идей из разных областей, но остаётся стендовой проверкой четырёх типов задач.
Jev-LiteMAS расходовал на 12,7–54,6% меньше токенов генеративной LLM, чем LAS. Разница в точности не превысила 1,34 процентного пункта, а задержка снизилась в семи из восьми сочетаний модели и задачи. В таблицах работы экономия относится именно к токенам генеративной LLM; Jev измеряли как отдельный слой принятия решений.
Удаление результатов предыдущих экспертов из входа маршрутизатора снизило точность на отдельных задачах до 18 процентных пунктов при почти неизменном числе вызовов LLM. Значит, дешёвый маршрутизатор сам по себе не решает задачу: экономия зависит от того, передаёт ли инфраструктура содержательные артефакты между шагами.
Работа меняет планы команд, у которых планировщик и проверяющий агент вызывают LLM после каждого промежуточного результата. Такой конвейер имеет смысл разделить по типу выхода: выбор из фиксированного набора поручить модели решений, создание артефакта оставить генеративному эксперту, а подробную проверку вызывать только после сигнала первичного фильтра.
Перед переносом схемы стоит отдельно измерить расходы маршрутизации и проверки в существующем процессе. Если они занимают заметную долю токенов, прототип может сократить затраты без смены экспертных моделей. При этом общий контекст, разрешённые переходы и возврат к LLM для исправления ошибок становятся обязательными частями архитектуры, а не вспомогательной обвязкой.
Источники
Иллюстрация: рисунок из статьи «Jev-LiteMAS: Separating Decisions from Generation in Multi-Agent Workflows», Kaixiang Wang, Zhaijiacheng Zhou, Jiong Lou и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


