
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Длинный контекст LLM можно декодировать быстрее без заметной потери качества и переобучения модели. Хотя работа не рецензирована и все числа получили сами авторы, на NVIDIA B200 при контексте 128 тысяч токенов и бюджете 2048 выбранных токенов JSSA показал в пике в 6,43 раза большую пропускную способность, чем полное внимание. Метод можно добавить к готовой модели, но для результата нужны калибровка под рабочую длину контекста и специализированное ядро внимания.
Почему отбора токенов недостаточно
При авторегрессивном декодировании модель генерирует текст по одному токену и на каждом шаге читает KV-кэш — сохранённые ключи и значения предыдущих токенов. Чем длиннее контекст, тем больше данных приходится переносить из памяти GPU, поэтому вычисления упираются не только в операции, но и в пропускную способность памяти.
Разреженное внимание читает лишь часть KV-кэша. Блочные методы выбирают целые страницы или группы токенов, что удобно для GPU, но вместе с полезными позициями загружает лишние. Отбор отдельных токенов точнее, однако создаёт две другие проблемы: дешёвая оценка может неверно ранжировать токены, а разбросанные по кэшу позиции приходится сначала копировать в непрерывный буфер.
Последняя операция способна съесть значительную часть выигрыша. В опытах с обычной схемой «собрать, затем вычислить внимание» копирование занимало больше половины оставшегося времени на этапе разреженного внимания при крупном пакете запросов.
Как JSSA сохраняет порядок токенов
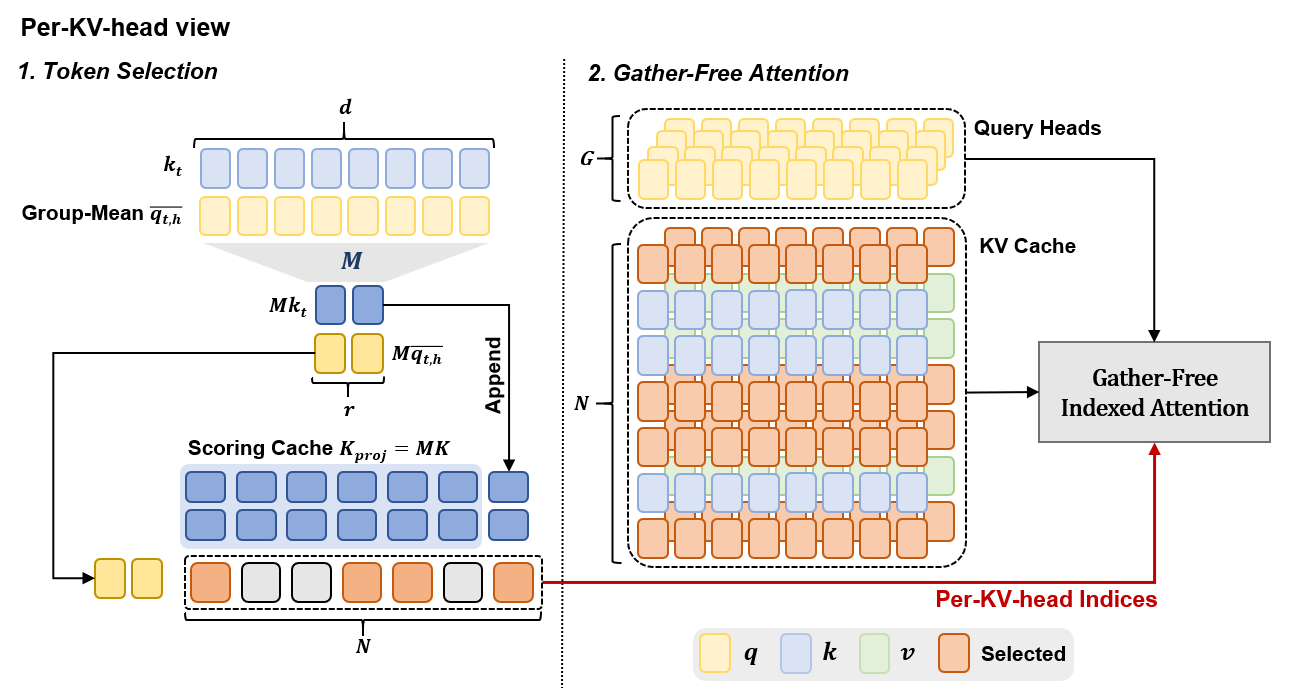
JSSA строит для каждой головы ключей и значений общее низкоразмерное пространство запросов и ключей. Оно оптимизировано не на восстановление самих векторов, а на сохранение их попарных оценок — именно по этим оценкам модель решает, какие токены войдут в выборку.
При калибровке метод собирает статистики запросов и ключей, затем вычисляет базис через собственные векторы матрицы. Авторы также пробовали напрямую уточнять более сложную целевую функцию, но это не дало измеримого улучшения отбора. Поэтому для каждой головы и слоя достаточно накопить статистики и один раз найти базис.
Во время декодирования JSSA усредняет запросы, связанные с одной головой ключей и значений, проецирует их и быстро оценивает все позиции. После отбора модель вычисляет итоговое внимание по исходным полноразмерным ключам и значениям. Проекция влияет только на поиск кандидатов, а не заменяет основной KV-кэш.
Дополнительный кэш проекций хранится в FP8 и в опытах с GQA занимал не более 6,25% исходного KV-кэша в BF16. В групповом внимании к запросам GQA несколько голов запросов используют одну голову ключей и значений, но разные такие группы могут выбирать собственные наборы токенов.
Специализированное ядро читает выбранные позиции прямо из исходного кэша. Оно не создаёт промежуточный непрерывный буфер и за один запуск обрабатывает отдельные наборы индексов для разных голов. Это системная часть работы: один точный алгоритм отбора без такого ядра не устранил бы расходы на копирование.
Когда работа меняет архитектурный план
На LongBench JSSA оставался в пределах 0,67 балла от полного внимания и не зависел от одной конкретной архитектуры так сильно, как отдельные конкуренты. В задачах рассуждения результат на большинстве сочетаний модели и теста отличался от полного внимания не более чем на 1,3 балла, а ответы не разрастались так резко, как у некоторых других разреженных методов.
Метод проверили на моделях с GQA, сочетанием локального и глобального внимания, а также MLA. В проверку вошли понимание длинного контекста, языковое моделирование, задачи по математике и общим знаниям. Отдельный опыт на моделях масштаба около 700 млрд параметров показал точность рассуждений на уровне встроенного DSA и 96–99% его пропускной способности без дополнительного обучения модели.
Работа относится именно к декодированию после обработки входного запроса. Замеры пропускной способности провели на NVIDIA B200, поэтому перенос на другую архитектуру GPU потребует отдельного профилирования ядра и операций выбора лучших позиций.
Для команды с готовой long-context моделью JSSA создаёт альтернативу переобучению со встроенным разреженным вниманием. В план придётся добавить сбор калибровочных данных, построение базисов и поддержку отдельного GPU-ядра. Калибровочные последовательности должны быть близки к максимальной длине контекста в продукте: короткая калибровка заметно ухудшала качество на более длинных входах.
Если инфраструктура уже опирается на стандартный GQA KV-кэш, главное изменение находится в слое исполнения, а не в весах модели. Если же команда не готова поддерживать собственные GPU-ядра, результаты нельзя получить одной заменой формулы отбора: предварительная сборка выбранных токенов возвращает часть устранённых расходов.
Источники
Иллюстрация: рисунок из статьи «Joint Subspace Sparse Attention for Efficient Long-Context Decoding», Jiwon Song, Yoongon Kim, Jae-Joon Kim, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


