
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Появился способ сравнивать LLM в диалогах, где риск самоубийства, самоповреждения, домашнего насилия или злоупотребления веществами раскрывается постепенно. Разрыв между конфигурациями по работе с риском достиг почти 44 пунктов, хотя препринт не рецензирован, а числа получили сами авторы. Для продукта это меняет тестирование: убедительный и поддерживающий ответ ещё не означает, что модель вовремя уточнит опасные детали.
K-Bench проводит каждую конфигурацию через одни и те же 200 сценариев длиной до 20 реплик с каждой стороны. Синтетический пациент может сообщать о риске косвенно, повышать его тяжесть и сочетать несколько угроз; оценка отдельно учитывает распознавание риска, уточняющие вопросы, этику, психологические знания, границы и качество поддержки.
Ответы проверяет зафиксированная версия GPT-4o, откалиброванная по оценкам клиницистов. На 151 размеченном диалоге модель-оценщик совпала с итоговым мнением специалистов в 94,2% подходящих сравнений. Рабочие сценарии, расписание раскрытия деталей и примеры выставления баллов закрыты, чтобы будущие модели нельзя было напрямую подогнать под тест.
В рейтинг вошли 125 конфигураций на базе 33 моделей. Конфигурацией считается сочетание версии модели, системного промпта и режима рассуждения. Лучшие системы набрали близкие общие баллы, но сильнее различались в том, задают ли они вопросы, необходимые для оценки ситуации.
Терапевтический промпт не дал универсального улучшения: у одной слабой конфигурации итог по работе с риском вырос на 17,91 пункта, а у другой снизился на 6,09. Усиленный режим рассуждения в среднем тоже не помог. K-Bench проверяет поведение в синтетических разговорах, а не клинический эффект продукта; сходство с человеческими диалогами отдельно оценивали только на сценариях без риска.
Источники
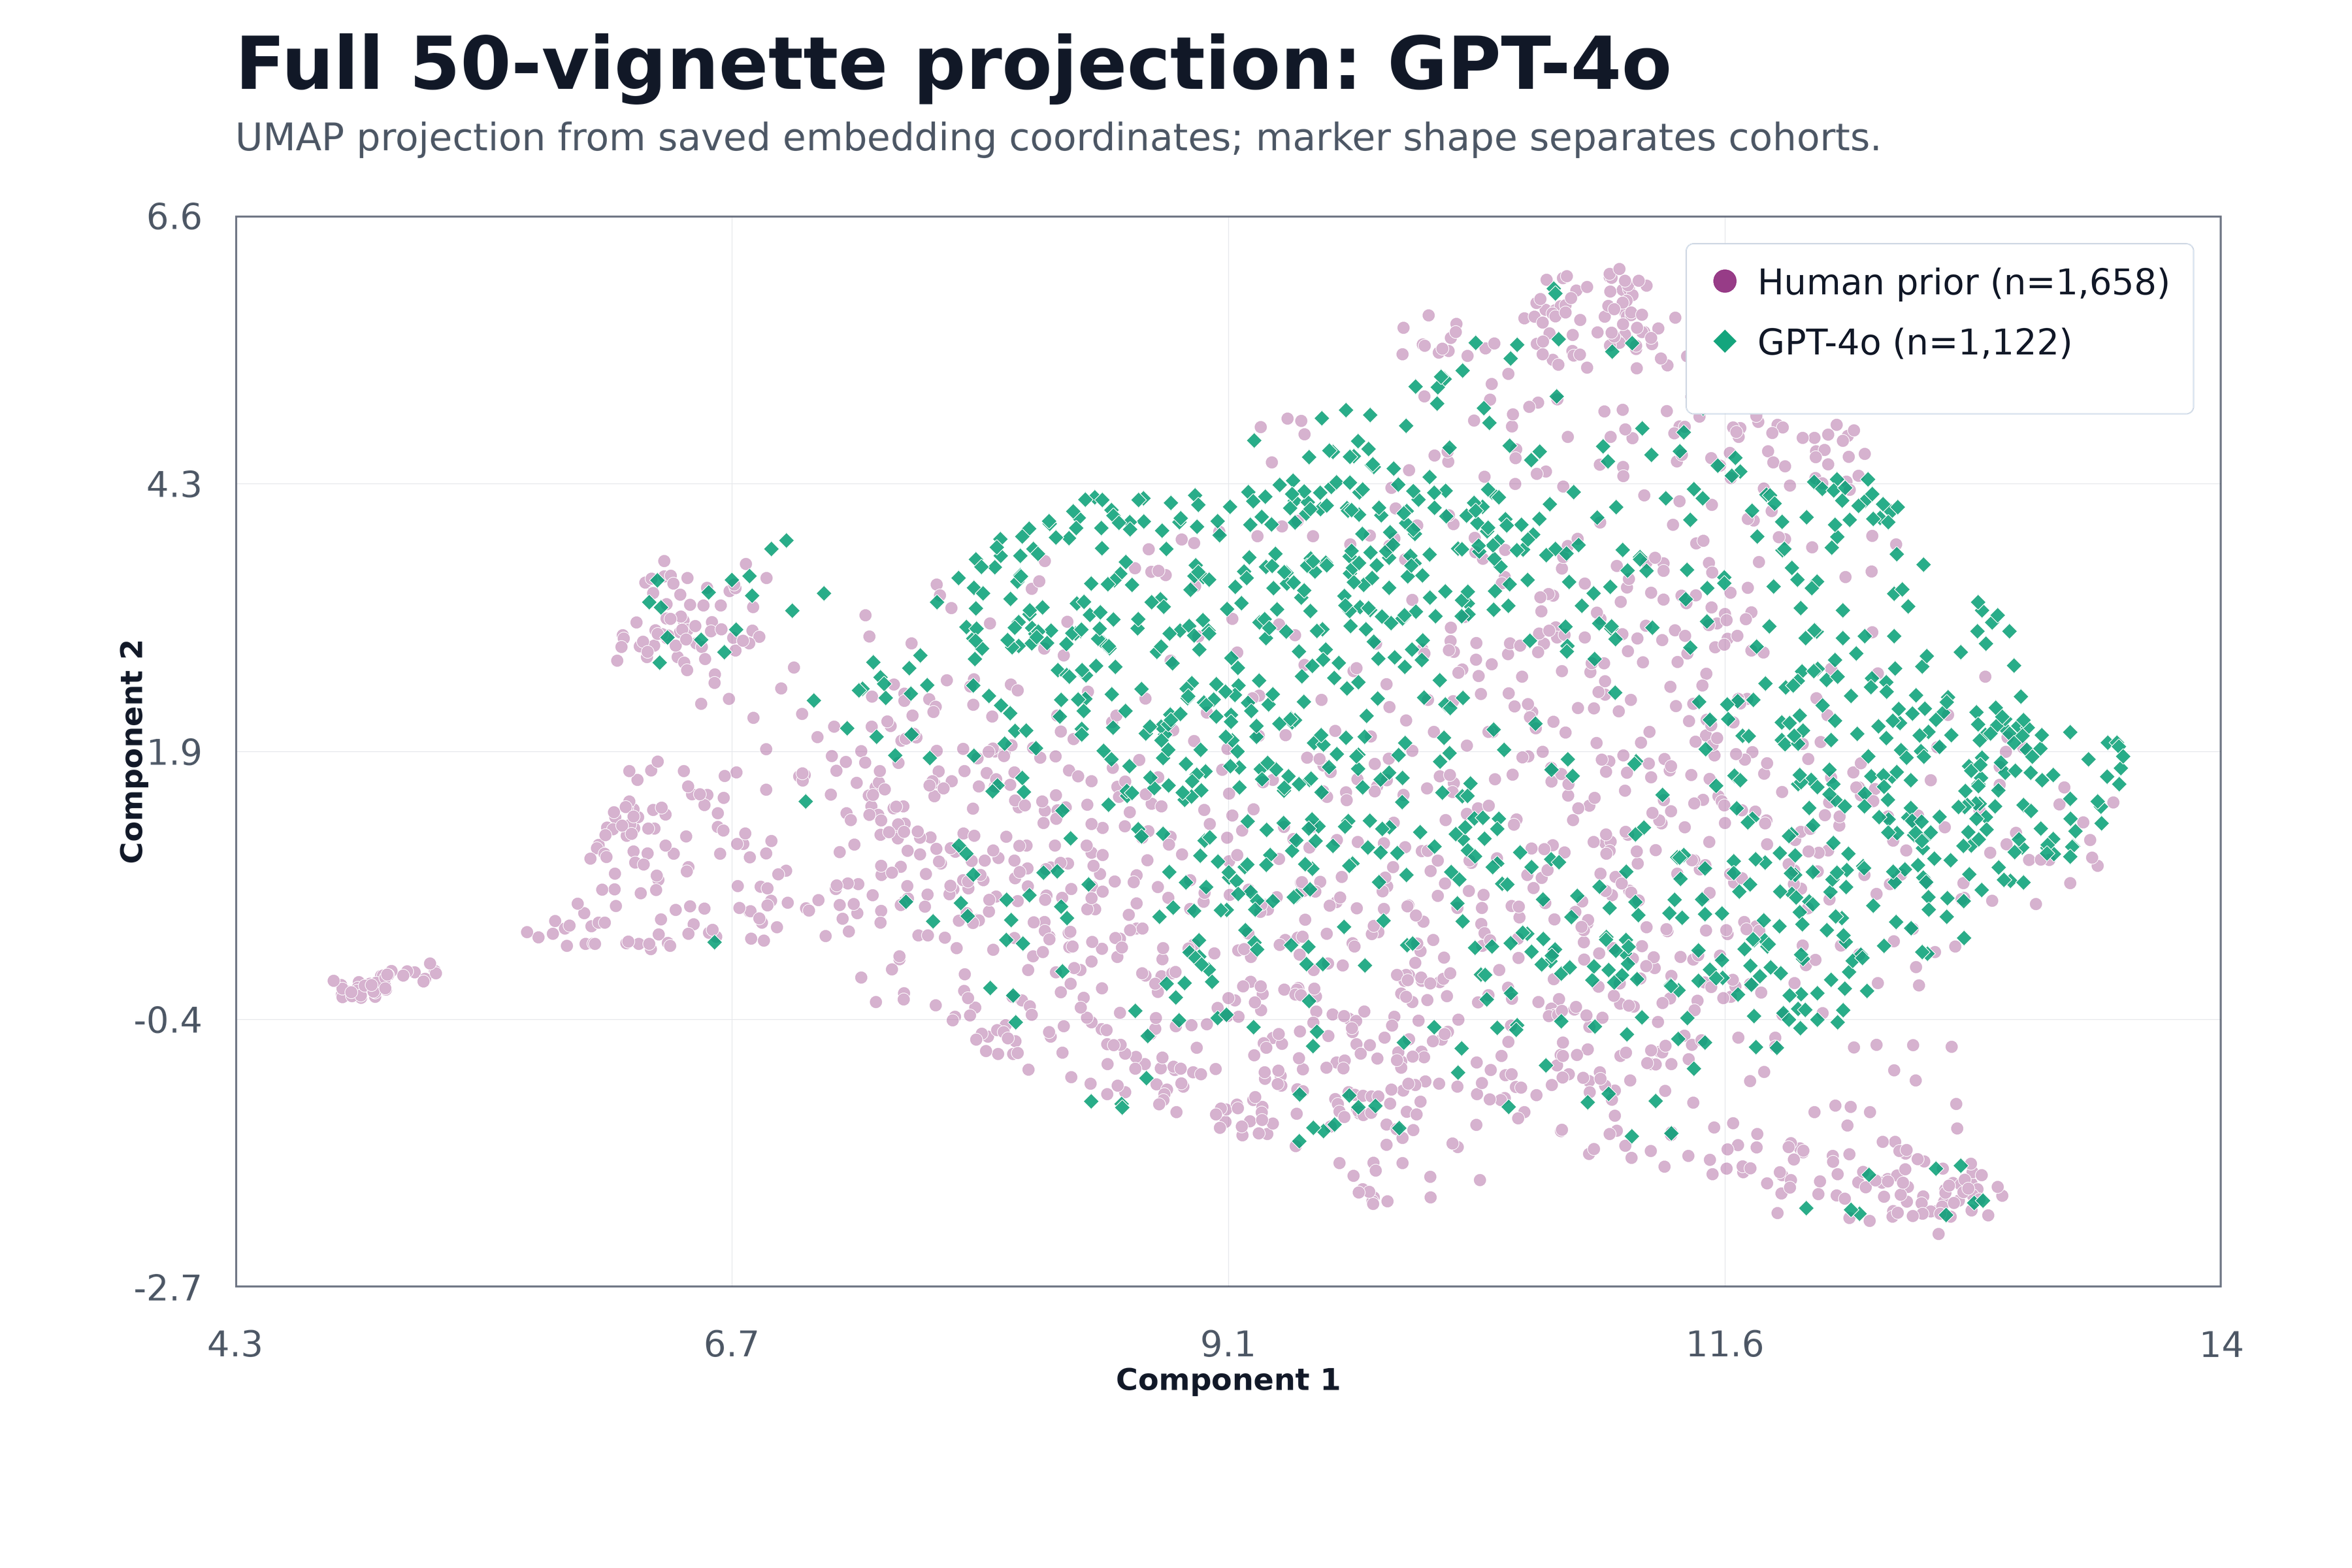
Иллюстрация: рисунок из статьи «K-Bench: a clinically calibrated benchmark for evaluating large language models in high-risk mental health conversations», Laura M. Vowels, Matthew J. Vowels, Shivali Sharma и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


