
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Агенты для программирования умеют доводить известную уязвимость ядра до сбоя, но часто не превращают её в контролируемую часть эксплойта. В Kex-bench лучшая связка без готового прототипа решила 14 из 25 задач Linux и только 1 из 20 задач Windows, хотя препринт не рецензирован и все числа получили сами авторы. Для оценки автоматического анализа безопасности одного факта, что агент нашёл или вызвал ошибку, теперь недостаточно.
Kex-bench проверяет эксплойт-примитив — конкретный управляемый эффект, из которого можно собирать атаку. Агент должен не просто обрушить систему, а, например, раскрыть адрес ядра, перенаправить выполнение программы, прочитать или изменить данные в куче либо записать заданное значение по заданному адресу. Проверяющий модуль наблюдает состояние ядра и отклоняет обычные сбои.
Каждую задачу запускают в изолированной виртуальной машине. Агент может собирать полезную нагрузку, изучать исходный код и результаты отладки, а затем исправлять решение. Для проверок чтения и записи значения генерируются заново, поэтому заранее вставленный ответ не пройдёт.
Готовая отправная точка заметно меняет результат. С эталонным прототипом эксплуатации лучшая связка ClaudeCode и Opus 4.6 справилась с 31 из 45 задач. Прототип помогает вызвать уязвимость, но агенту всё равно приходится приспосабливать код под точный эффект, который проверяет стенд: достижение уязвимого участка ещё не даёт контроля над состоянием ядра.
Стенд охватывает 40 публично раскрытых и исправленных CVE в Linux и Windows. На Linux и Windows проверяли разные примитивы, применяли разные инструменты и задавали разные лимиты вызовов, поэтому разрыв нельзя объяснить только операционной системой. Для каждой связки агента и модели провели по одному сеансу на задачу: результаты показывают достижимый уровень, но не стабильность при повторных запусках. Kex-bench также измеряет отдельные примитивы, а не полный захват системы или готовую цепочку эксплуатации.
Источники
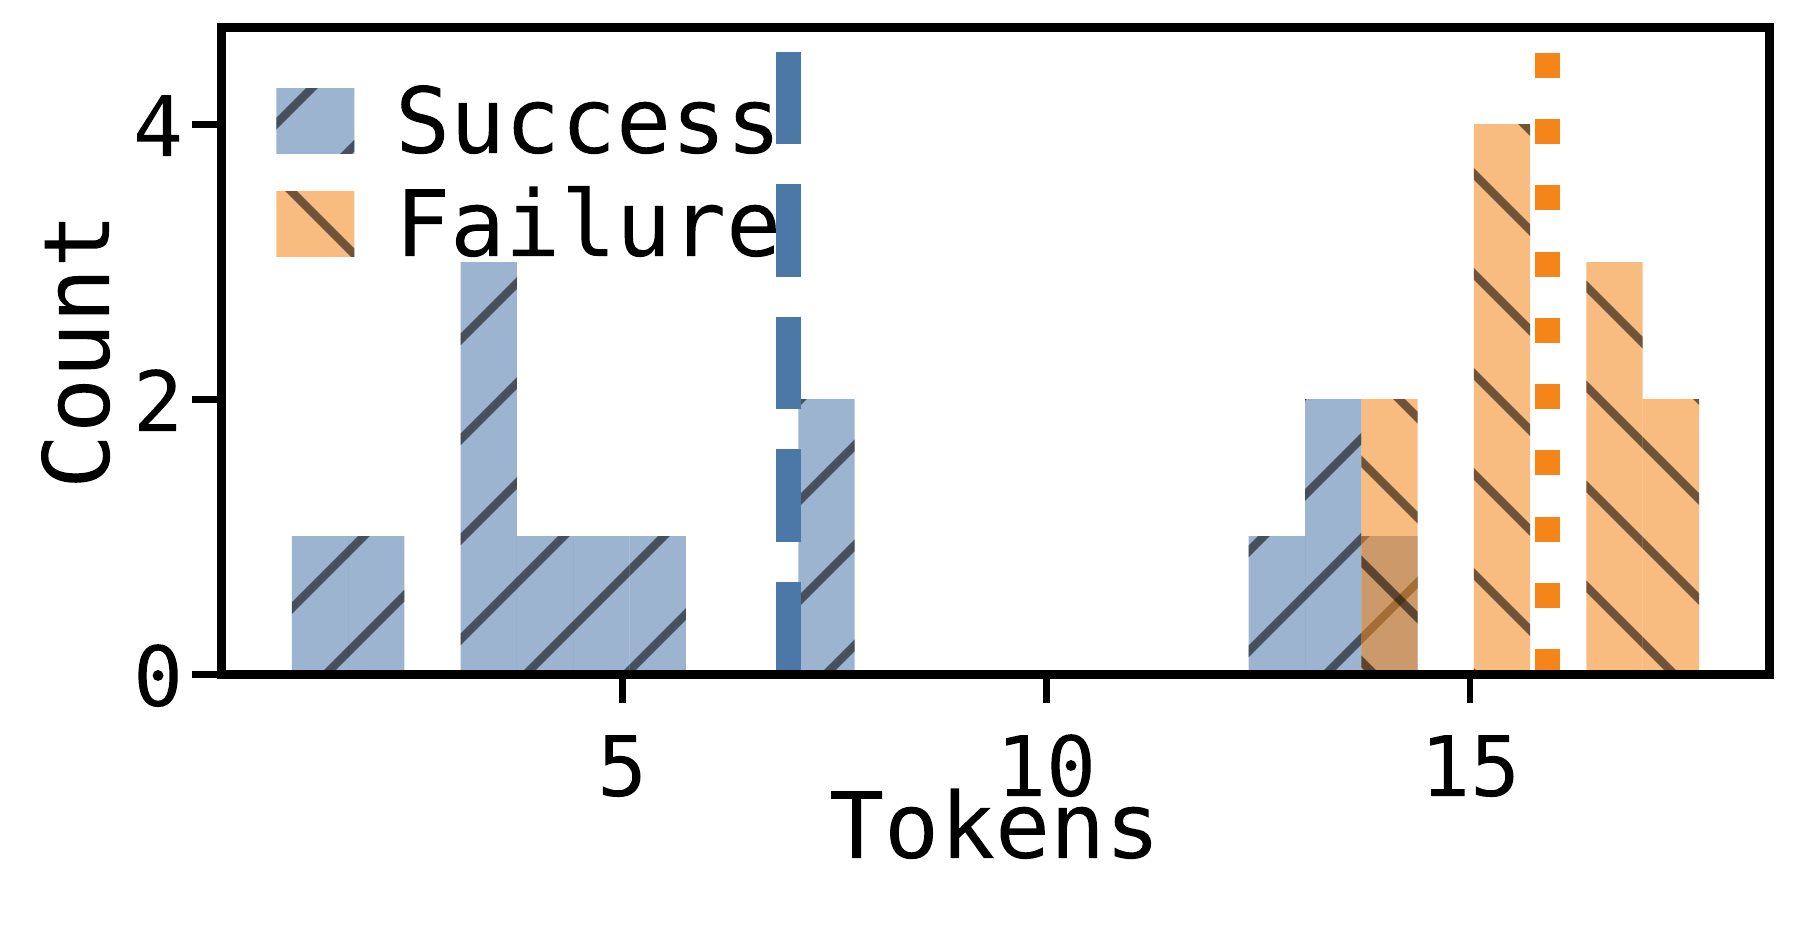
Иллюстрация: рисунок из статьи «Evaluating Coding Agents on Kernel Exploit Generation», Junyoung Jang, Gwanhyun Lee, Hwiwon Lee и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


