
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Генератор GPU-ядер научили автоматически находить задачи, которые ему пока удаются лишь иногда, и тренироваться на них. В препринте, который не прошёл рецензирование и приводит числа самих авторов, KernelZero-7B обошёл свою версию после обучения на готовых примерах во всех проверенных режимах CUDA и Triton. Для команд, которые обучают специализированные модели, работа предлагает заменить статичный датасет циклом, где генератор задач подстраивается под текущие слабости модели.
Одна модель ставит задачи, другая пишет ядра
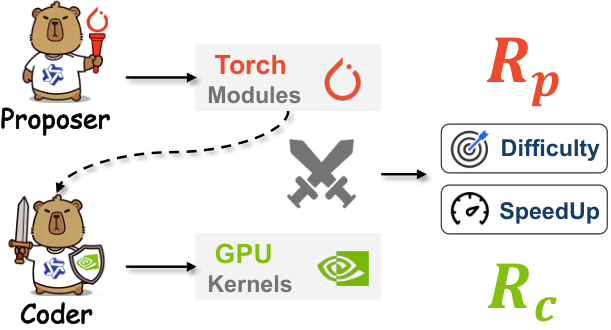
KernelZero состоит из двух моделей с разными ролями. Proposer получает набор Torch API и собирает из них исполняемый модуль, а Coder переводит этот модуль в оптимизированное ядро CUDA или Triton.
Proposer не генерирует произвольные сочетания операторов. Система строит распределение совместной встречаемости API по реальным Torch-модулям, поэтому чаще выбирает правдоподобные комбинации. Затем она проверяет структуру программы, запускает модуль на GPU и отбрасывает варианты с ошибками, NaN или бесконечными значениями.
Главная деталь — Proposer получает наибольшую награду за задачу, на которой Coder пишет правильное ядро примерно в половине попыток. Слишком простые модули не дают полезного сигнала, а слишком сложные оставляют модель без успешных примеров. После очередного обновления Coder граница сдвигается, и Proposer начинает собирать более трудные задачи.
Модели обновляют по очереди, фиксируя вторую на время обучения первой. Так статичный набор упражнений превращается в автоматическую учебную программу: ошибки Coder определяют, какие сочетания API появятся в следующем цикле.
Скорость учитывают только после правильности
Обычная общая награда за правильность и скорость создаёт конфликт. На раннем этапе быстрый, но неверный код может дать модели ложное направление, а обучение только на правильности закрепляет осторожные реализации без заметного ускорения.
KernelZero разделяет эти сигналы. Coder генерирует группу вариантов для одного модуля; пока правильных ядер недостаточно, модель получает награду только за совпадение результата с эталоном. Когда доля правильных вариантов достигает 50%, система начинает дополнительно поощрять самые быстрые решения внутри группы.
До обучения с подкреплением Coder проходит настройку на проверенных трассировках рассуждений и кода. Учитель применяет типичные приёмы оптимизации GPU: разбиение данных на блоки, слияние операторов, совмещение вычислений с переносом данных и перестановку операций ради более эффективного доступа к памяти. Каждый полученный пример исполняют и оставляют только при правильном результате.
Порог важен не как отдельный гиперпараметр, а как порядок обучения. В варианте без награды за скорость модель чаще писала правильный код, но реже ускоряла вычисления. Если включать скорость сразу, баланс также ухудшался; промежуточный режим дал лучший совокупный результат.
Метод улучшил точность, но не отменил ручную оптимизацию
Систему проверяли на 200 задачах первых двух уровней KernelBench: отдельных операторах и цепочках операторов. Модель получала PyTorch-реализацию и с одной попытки писала эквивалентное ядро; метрика pass@1 показывает долю задач, где первый вариант прошёл проверку правильности.
Для CUDA KernelZero получил pass@1 75,8% на отдельных операторах и 69,6% на цепочках. Для Triton результаты составили 77,2% и 72,5%. Продолжение обучения Proposer особенно помогло на более сложных цепочках, тогда как его заморозка раньше оставляла Coder на менее полезном распределении задач.
На CUDA модель приблизилась к Claude-4.5-Sonnet по первой попытке и обошла его при выборе из нескольких вариантов на обоих уровнях. На Triton она превзошла DeepSeek-V4-Pro в приведённых сравнениях. Это показывает, что узкая модель с адаптивными заданиями может конкурировать с более крупными системами, но только в исследованном классе задач.
Границы проверки узкие: обе роли начинали с Qwen2.5-Coder-7B, учебные модули строили из небольших сочетаний Torch API, а оценку проводили только на KernelBench для CUDA и Triton. Кроме того, сгенерированные CUDA-ядра не вызывали cuDNN и cuBLAS, тогда как эталонный PyTorch использовал эти библиотеки. Поэтому на сложных операциях правильное собственное ядро далеко не всегда оказывалось быстрее.
Работа меняет план прежде всего для команд, которые обучают собственный генератор кода. Им имеет смысл выделить отдельный контур создания задач, запускать каждый пример и направлять новые данные туда, где модель ошибается не всегда, а лишь иногда. Награду за производительность также стоит включать после проверки устойчивой правильности, а не смешивать оба требования с начала обучения.
Для команды, которой нужны готовые ядра в продукте, вывод осторожнее. KernelZero подтверждает ценность специализации и автоматического тестирования, но результаты бенчмарка не заменяют замеры на целевых формах тензоров, конкретном GPU и реальной цепочке операторов. Ручные реализации и библиотеки производителя остаются ориентиром там, где задержка критична.
Источники
Иллюстрация: рисунок из статьи «KernelZero: Co-Evolving Proposer and Coder for Continuously Improved GPU Kernel Generation», Changxin Ke, Rui Zhang, Zixiang Fang и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


