
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
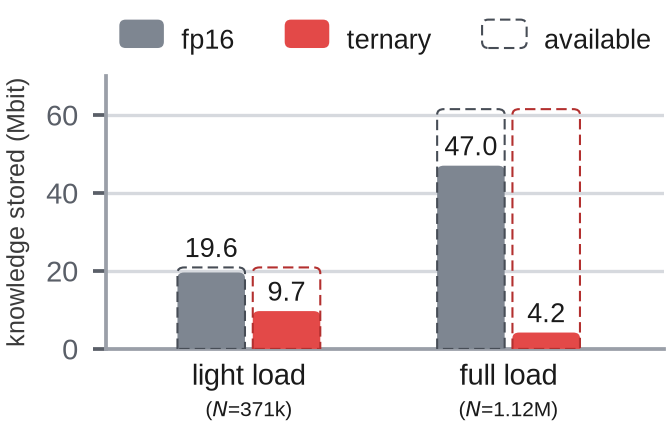
Троичные языковые модели могут сначала запомнить факты, а затем потерять их ещё во время обучения. В препринте University of Wyoming, который не проходил рецензирование и где все числа получили сами авторы, крупнейшая модель сохранила лишь 6% фактической ёмкости версии fp16. Значит, выбирать режим низкобитного обучения только по функции потерь и перплексии рискованно: итоговая модель может выглядеть исправной по привычным метрикам, но хранить заметно меньше знаний.
Ёмкость измеряли как число фактических битов, усвоенных на один параметр. Для этого модели учили на синтетических биографиях, информационное содержание которых известно заранее. Перплексия — показатель того, насколько уверенно модель предсказывает следующий элемент текста, — скрывала разрыв: при 25 млн параметров троичная модель удержала 9% ёмкости fp16, хотя её перплексия ухудшилась в 1,58 раза.
Замеры по ходу обучения показали резкий спад после первоначального роста. Его вызывало не прохождение через конкретную скорость обучения, а длительная работа на ней; возврат к безопасному значению знания не восстанавливал. Сбой возникал в выходном слое: строки, отвечающие за месяц рождения, бесконтрольно росли, тогда как остальные предсказания почти не менялись. Когда значение делали предсказуемым, распад исчезал.
Короткое плавное снижение скорости обучения в конце оказалось лучше стандартного косинусного расписания. Отведённые на него 10% обучения увеличили ёмкость троичной модели в 4,3 раза при 50 млн параметров. Сжатие уже обученной fp16-модели проверенными методами не сохранило измеримую ёмкость ниже четырёх бит, поэтому проблему нельзя было исправить одной посттренировочной квантизацией.
Эксперименты охватывали модели GPT-2 четырёх размеров до 50 млн параметров и пять вариантов точности. В троичной конфигурации только блоки трансформера имели троичные веса, а входной и выходной слои оставались четырёхбитными; активации не квантизировали. Синтетические биографии помогают точно найти сбой, но эти опыты не показывают, повторится ли он на естественных текстах и крупных LLM.
Источники
Иллюстрация: рисунок из статьи «Linger and Lose: Knowledge Collapse in Low-Bit Language Models», Prashanna Mani Paudel, Shivanand Venkanna Sheshappanavar, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


