
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
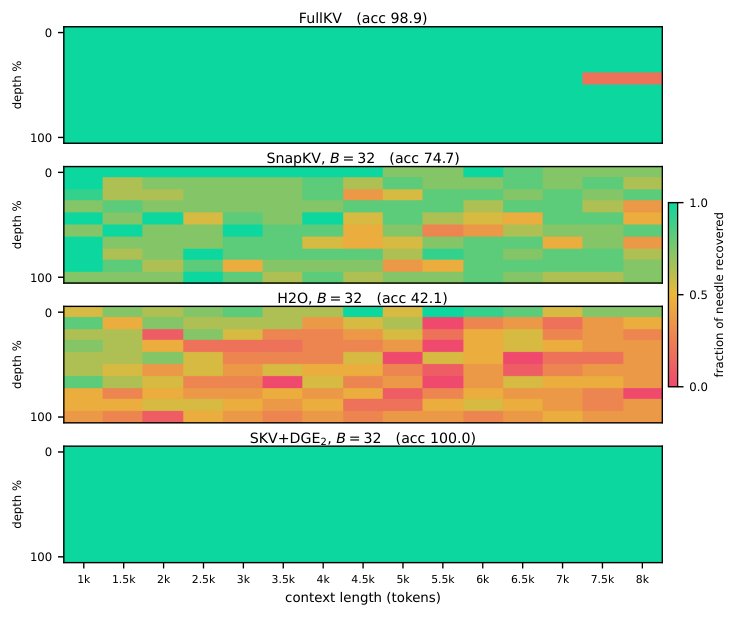
Качество ответа зависит не только от того, какие записи остаются в KV-кэше, но и от момента, когда модель его сокращает. В препринте Haeyong Kang и Chang D. Yoo средний результат приблизился к полному кэшу: 44,2 против 44,3 на LongBench; поскольку работа не рецензирована, все числа получили сами авторы. Для систем с длинным контекстом это открывает ещё один способ экономить память без обучения модели и разработки нового правила отбора.
Почему точный отбор записей не гарантирует хороший ответ
KV-кэш хранит ключи и значения механизма внимания для уже обработанных токенов. Его размер растёт вместе с контекстом и числом одновременных запросов, поэтому сервисы часто оставляют ограниченное число записей для каждой головы внимания, а остальные вытесняют.
SnapKV, H2O и PyramidKV сокращают кэш после предзаполнения — обработки всего запроса перед генерацией ответа. В этот момент модель ещё не сформировала векторы запросов внимания, которые появятся при генерации. Методам приходится оценивать будущую полезность записей по самому исходному запросу.
Авторы проверили два способа улучшить такое сокращение. Первый компенсирует потерянную массу внимания — сумму весов, которые модель назначила удалённым токенам. Второй старается сохранить записи, на которые будущие шаги действительно обращают больше внимания.
Оба подхода улучшали собственные технические показатели, но это не переносилось на итоговую задачу. Возвращённый вес внимания не восстанавливал содержание удалённых токенов. Более полное покрытие тоже могло ухудшить ответ, если метод сохранял разрозненные токены вместо связного фрагмента, из которого можно извлечь факт или цитату.
Из этого следует, что масса внимания сама по себе служит слабой целью для оптимизации. Модель может распределить правильный объём внимания по неправильным данным или сохранить полезные токены в форме, которая мешает восстановить связный ответ.
Один полный шаг задаёт траекторию ответа
Предложенный метод DGE сначала оставляет полный кэш и формирует первые два токена ответа. Первый появляется на выходе предзаполнения, поэтому полный кэш требуется лишь ещё на одном шаге генерации. После этого DGE один раз сокращает кэш и продолжает обычное декодирование.
Начало ответа даёт модели сигнал, которого не было при предварительном отборе: реальные запросы внимания из формирующегося ответа. DGE может использовать их для оценки записей, но эксперимент с DGE-W показал более важную деталь. Если оставить прежнее правило SnapKV и изменить только момент вытеснения, средний результат остаётся тем же.
Авторы называют это закреплением траектории. На задачах извлечения начало ответа выбирает нужный фрагмент исходного текста, а при суммаризации задаёт тему и структуру. После такого старта с полным кэшем модель может продолжить уже выбранную линию, даже когда часть записей удалена.
DGE не увеличивает постоянный лимит записей для головы внимания и не добавляет отдельный проход модели. Пиковый порядок потребления памяти также не меняется: полный кэш уже существует после предзаполнения. Отличие состоит в том, что система сохраняет его до начала ответа, а затем переходит к тому же сокращённому состоянию.
Когда командам стоит менять план внедрения
Работу проверяли на моделях семейств Llama, Mistral и Qwen размером от 3B до 14B параметров. Основной тест охватывал 16 англоязычных наборов LongBench с вопросами по документам, суммаризацией, поиском, подсчётом и дополнением кода. Модели генерировали ответы жадно, а методы сравнивали при трёх лимитах KV-кэша на голову внимания.
Результат относится прежде всего к системам, которые уже рассматривают SnapKV, PyramidKV, H2O или StreamingLLM. DGE оборачивает существующий способ вытеснения: сервис выполняет генерацию в два этапа и между ними редактирует кэш на месте. Переобучать модель или заменять её правило оценки записей не требуется.
Для команды это меняет порядок экспериментов. Прежде чем разрабатывать более сложный оценщик полезности токенов, стоит проверить отложенное вытеснение с текущим алгоритмом. Контрольный вариант DGE-W отделяет эффект расписания от нового способа отбора и потому подходит для такого теста лучше полной версии DGE.
Практический компромисс проявляется в задержке. В прототипе операция с кэшем увеличила время коротких ответов до 1,45 от времени SnapKV, тогда как на длинных ответах коэффициент составил 1,02: постоянные затраты почти полностью распределились по генерации. Поэтому для длинных документов и развёрнутых ответов изменение выглядит привлекательнее, чем для сервиса с короткими ответами и жёстким пределом задержки.
Главный вывод для архитектуры сервиса — момент сокращения KV-кэша стоит считать отдельным параметром, а не неизменной частью метода. Начало ответа даёт достаточно информации, чтобы прежний алгоритм отбора работал ближе к полному кэшу, не расширяя его постоянный бюджет.
Источники
Иллюстрация: рисунок из статьи «When to Evict, Not What to Keep: Draft-Guided Eviction for Training-Free KV-Cache Compression», Haeyong Kang, Chang D. Yoo, CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


