
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
Плотную LLM научились перестраивать так, чтобы она обрабатывала каждый токен лишь частью исходной сети. На Qwen2-7B скорость инференса выросла в 2,5 раза почти без изменения качества, хотя препринт не рецензирован, а все числа получили сами авторы. Метод даёт ещё один путь ускорить готовую открытую модель, если квантование или обрезка слишком заметно ухудшают ответы.
Как из плотной модели получают экспертов
В плотной LLM каждый токен проходит через все доступные параметры слоя. В смеси экспертов маршрутизатор выбирает только несколько специализированных блоков, поэтому модель выполняет меньше вычислений. Обычно такую архитектуру обучают с нуля или перестраивают на большом корпусе, что ограничивает её практическую ценность для команд с уже выбранной моделью.
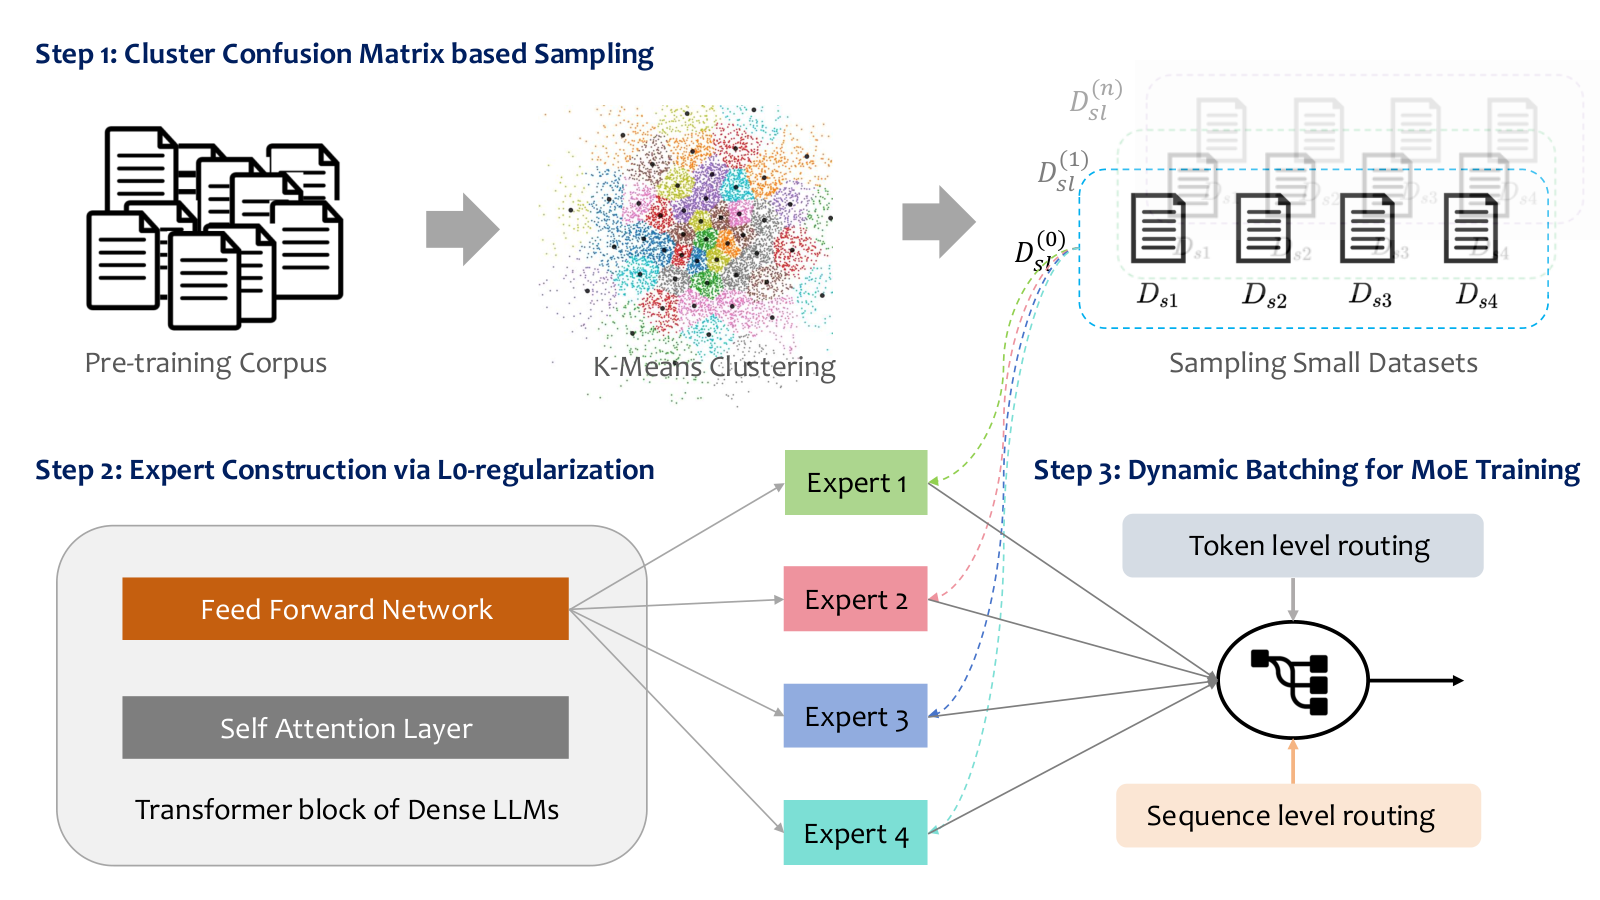
L0-MoE начинает с готовой плотной LLM. L0-регуляризация штрафует модель за ненулевые элементы и помогает определить, какие внутренние измерения полносвязных слоёв важны для конкретной группы текстов. Из выбранных измерений собирают экспертов, а остальные части исходной модели на этом этапе замораживают.
Обучающий корпус RedPajama сначала делят на смысловые области. Для этого тексты кодируют с помощью BGE-M3 и группируют алгоритмом K-means. Затем матрица смешения кластеров оценивает, насколько хорошо очередное разбиение отделяет области друг от друга, и задаёт порядок данных для обучения.
Маршрутизатор сначала видит области, на которых эксперты уже специализировались, а затем получает всё более смешанные пакеты. Такой динамический порядок помогает ему перейти от выбора эксперта для целой последовательности к выбору на уровне отдельных токенов. На всю перестройку использовали корпус объёмом 30 млрд токенов — заметно меньше корпусов, на которых обычно обучают крупные MoE-модели с нуля.
Ускорение сохранило средний результат моделей
L0-MoE проверили на Llama-3-8B, Mistral-7B и Qwen2-7B. Качество измеряли на MMLU для общих знаний, GSM8K для арифметических задач, HumanEval для генерации кода и BBH для сложных рассуждений. Исходные и перестроенные модели запускали через SGlang, поэтому разница в скорости не связана со сменой среды инференса.
Llama ускорилась в 2 раза, а Mistral — в 2,1 раза. Средний результат каждой перестроенной модели отличался от исходной не более чем на один балл: Llama немного уступила своей основе, Mistral улучшила результат, а Qwen осталась почти на прежнем уровне.
Сравнение на Qwen показывает сам компромисс. LLM Shearing дала ускорение в 2,6 раза, но уступила L0-MoE на MMLU и GSM8K. GPTQ и сочетание дистилляции рассуждений с обычной дистилляцией также сильнее снизили результаты хотя бы на одной из этих задач.
Разбор компонентов подтвердил, что одной архитектуры MoE недостаточно. Случайный выбор измерений для экспертов, обычная обрезка по величине весов и разложение матриц дали худшие результаты. Случайный порядок пакетов и отказ от K-means тоже ухудшили качество, поэтому выигрыш зависит сразу от отбора параметров, подготовки корпуса и расписания обучения.
Когда L0-MoE меняет планы внедрения
Работа добавляет реалистичный вариант для команды, которая уже выбрала открытую плотную модель и может провести дополнительное обучение. Вместо перехода на другую LLM можно сохранить исходные веса, выделить экспертов под области собственного корпуса и обучить маршрутизатор. Такой пилот имеет смысл сравнивать с квантованием на реальном профиле запросов, а не только на тестах качества.
Ускорение не означает, что модель становится меньше целиком. В варианте на базе Qwen суммарный объём вырос до 23,3 млрд параметров, хотя при обработке токена активировалось 2,8 млрд. Вычислений становится меньше, но при проектировании инфраструктуры всё равно придётся учитывать размещение всех весов и работу маршрутизатора.
Количество экспертов тоже нельзя переносить между проектами как готовую настройку. Чем их больше, тем лучше модель сохраняла качество, но тем ниже становилась скорость. Авторы отдельно связывают удачное разбиение с тематически разнообразным RedPajama, поэтому для узкого корпоративного корпуса баланс может оказаться другим.
Границы проверки пока проходят по моделям класса 7–8 млрд параметров; дополнительный опыт на меньшей Qwen дал сходный результат. Модели на 70 млрд параметров не проверяли. Поэтому работа меняет планы для средних открытых LLM, но ещё не обосновывает перенос того же выигрыша на самые крупные модели или закрытые API.
Источники
Иллюстрация: рисунок из статьи «Accelerating Dense LLMs via L0-regularized Mixture-of-Experts», Zhenyu Zhang, Jiudong Yang, Zhaowen Tao и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


