
Материал подготовлен автоматически по первоисточникам: ссылки на них — в конце статьи.
GPU-ядра, созданные LLM, можно проверять на эквивалентность реализации на PyTorch так, чтобы ошибка агента не превратилась в ложный сертификат. В препринте LARK, который не прошёл рецензирование и содержит замеры самих авторов, проверка нашла гонку данных, которую пропускали тесты. Для команд, генерирующих низкоуровневый код, это переносит узкое место с построчной проверки каждого ядра на предварительную проверку общей модели вычислений.
Lean проверяет не ответы агента, а всё ядро
Обычный тест запускает ядро на выбранных входах и сравнивает результат с эталоном. Он показывает, что код сработал на этих примерах, но не доказывает корректность для всех допустимых входов и вариантов выполнения потоков.
LARK формулирует более сильное условие: ядро должно завершиться без ошибок и выдать тот же результат, что и исходный модуль PyTorch, для любого входа, который соответствует заданным формам, типам, расположению буферов и геометрии запуска. Дополнительно система доказывает отсутствие гонок данных, завершение программы и корректность операций с памятью в пределах описанного интерфейса.
Написать такое доказательство сразу для низкоуровневого ядра трудно. В коде есть регистры отдельных потоков, барьеры, общая память, переходы и коллективные операции, но нет тензоров и циклов высокого уровня, на которые удобно опираться в доказательстве.
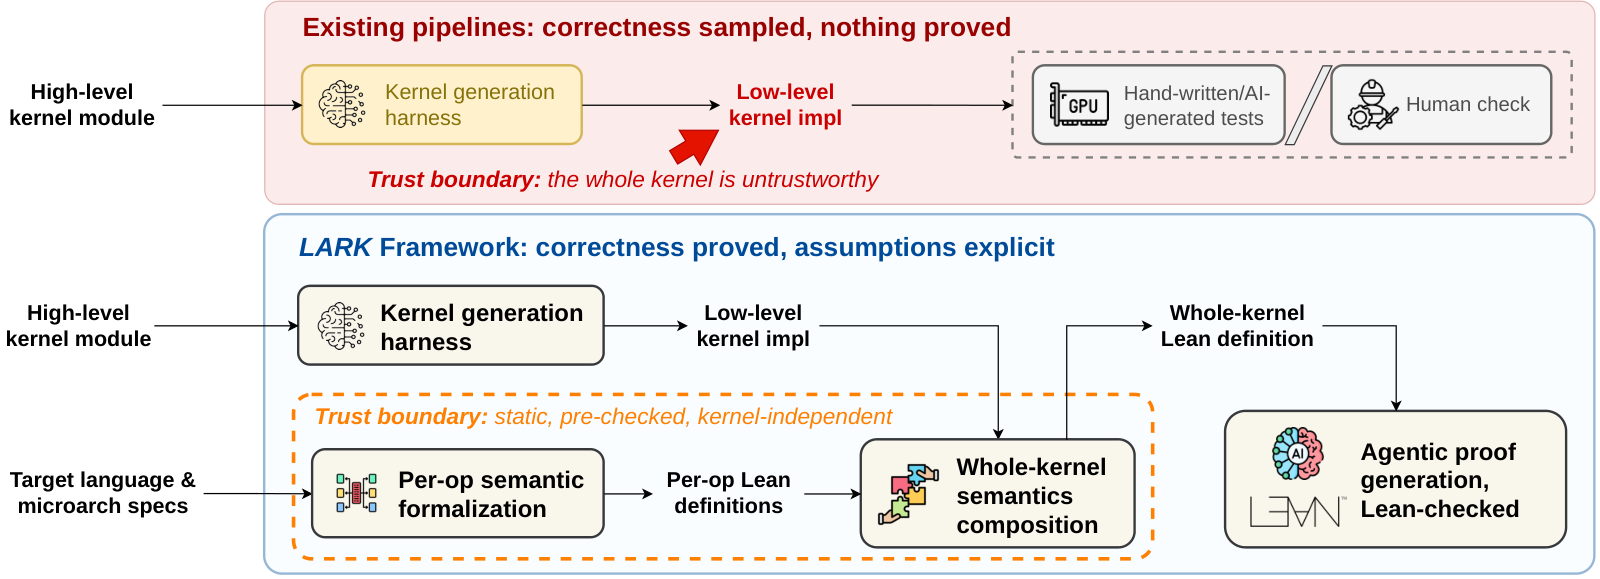
LARK сначала переводит ядро в семантику Lean, собранную из заранее определённых операций. Затем агент делит эту плоскую программу на смысловые участки, а Lean проверяет, что такое деление ничего не изменило. Другие агенты доказывают соответствие каждого участка фрагменту реализации на PyTorch. Если агент написал неверный шаг, Lean не принимает доказательство.
На KernelCraft, наборе задач по генерации GPU-ядер, GLM 5.3 получил сертификаты для 10 из 12 базовых ядер, а Opus 5.5 — для всех 5 более сложных объединённых ядер. Среди 10 ядер из открытых систем обслуживания LLM система подтвердила 9; последнее отклонила из-за реальной гонки данных.
Доверять всё равно приходится модели GPU
Доказательство относится не непосредственно к физическому ускорителю, а к его формальной модели. До обработки конкретных ядер специалисты должны проверить, что операции PTX, CUDA или HIP правильно описаны в Lean, модель памяти соответствует оборудованию, а интерфейс задачи верно задаёт входы, выходы и запуск.
После этого LLM не входит в доверенную часть системы. Агент может предложить разбиение программы, сформулировать промежуточное утверждение или написать доказательство, но окончательный сертификат проверяет Lean. Его можно повторно проверить отдельно, не запуская весь процесс LARK.
Гарантия действует при точной арифметике. Она не охватывает округление чисел с плавающей точкой, переполнение, порядок накопления и погрешность приближённых инструкций. Эти свойства по-прежнему приходится проверять тестами на оборудовании.
Модель также предполагает вычисления по фазам, разделённым синхронизацией. Она отклоняет некоторые корректные, но неудобные для такого представления программы: например, ядра с атомарными и асинхронными операциями, частичными масками или допустимыми гонками. Память в модели не ограничена размером реального буфера, поэтому сертификат не гарантирует отсутствие записи за пределами выделения на стороне хоста.
Генератор ядер можно отделить от проверяющего контура
LARK не требует менять модель, которая пишет код. Система принимает готовое ядро и эталон на PyTorch, поэтому её можно поставить после собственного агента генерации или использовать для проверки написанной вручную библиотеки.
Практическая выгода появляется, когда команда многократно создаёт ядра для одного языка и стабильного набора операций. Формальную семантику каждой инструкции проверяют заранее, а затем используют для всех новых программ. Чем чаще меняются язык, инструкции и архитектурные возможности GPU, тем хуже окупается эта подготовка: перенос на новый язык остаётся ручной работой.
Отказ LARK сам по себе не доказывает, что в ядре есть ошибка. Система может не поддерживать использованную инструкцию или форму параллелизма, а агент может не успеть построить доказательство в заданный бюджет. В производственном процессе такой результат следует считать отсутствием сертификата, а не автоматическим основанием удалить код.
Работа меняет архитектуру контроля, но не отменяет тестирование. Формальное доказательство закрывает функциональную эквивалентность, гонки и завершение в пределах модели; аппаратные тесты остаются нужны для численной точности и поведения возможностей GPU, которых в модели пока нет. Командам стоит сначала проверить покрытие своего набора инструкций, а уже затем оценивать LARK как обязательный этап выпуска сгенерированных ядер.
Источники
Иллюстрация: рисунок из статьи «LARK: Lean-Assisted Reasoning for LLM-Generated GPU Kernels», Zixi Zhang, Jiayi Nie, Haoran Wu и др., CC BY 4.0
Похоже на вашу задачу?
Расскажите, что собираете. За полчаса разложим на этапы и назовём сроки — это бесплатно и ни к чему не обязывает.


